


LLM加速的验证示例
内容提要
文章介绍LLM加速中的快速交叉熵损失。由于LLM训练目标仅一个有效值,交叉熵可简化为logsumexp(x)减x_y,复杂度从O(4n)降至O(2n)。验证时发现需减去最大logit以稳定softmax,否则损失不下降。微调Gemma2后,新代码与官方结果几乎一致,耗时减少约2.8%。作者建议用Triton实现以获更好性能。
延伸解读
LLM训练中交叉熵的简化原理
文章指出,LLM训练时目标标签只有一个有效值,其余为零,因此交叉熵可简化为logsumexp(x)减x_y,避免了完整的log_softmax计算。这种简化将时间复杂度从O(4n)降至O(2n),能减少时间和GPU内存开销,但仅适用于这种稀疏标签场景。
数值稳定性:减去最大logit的必要性
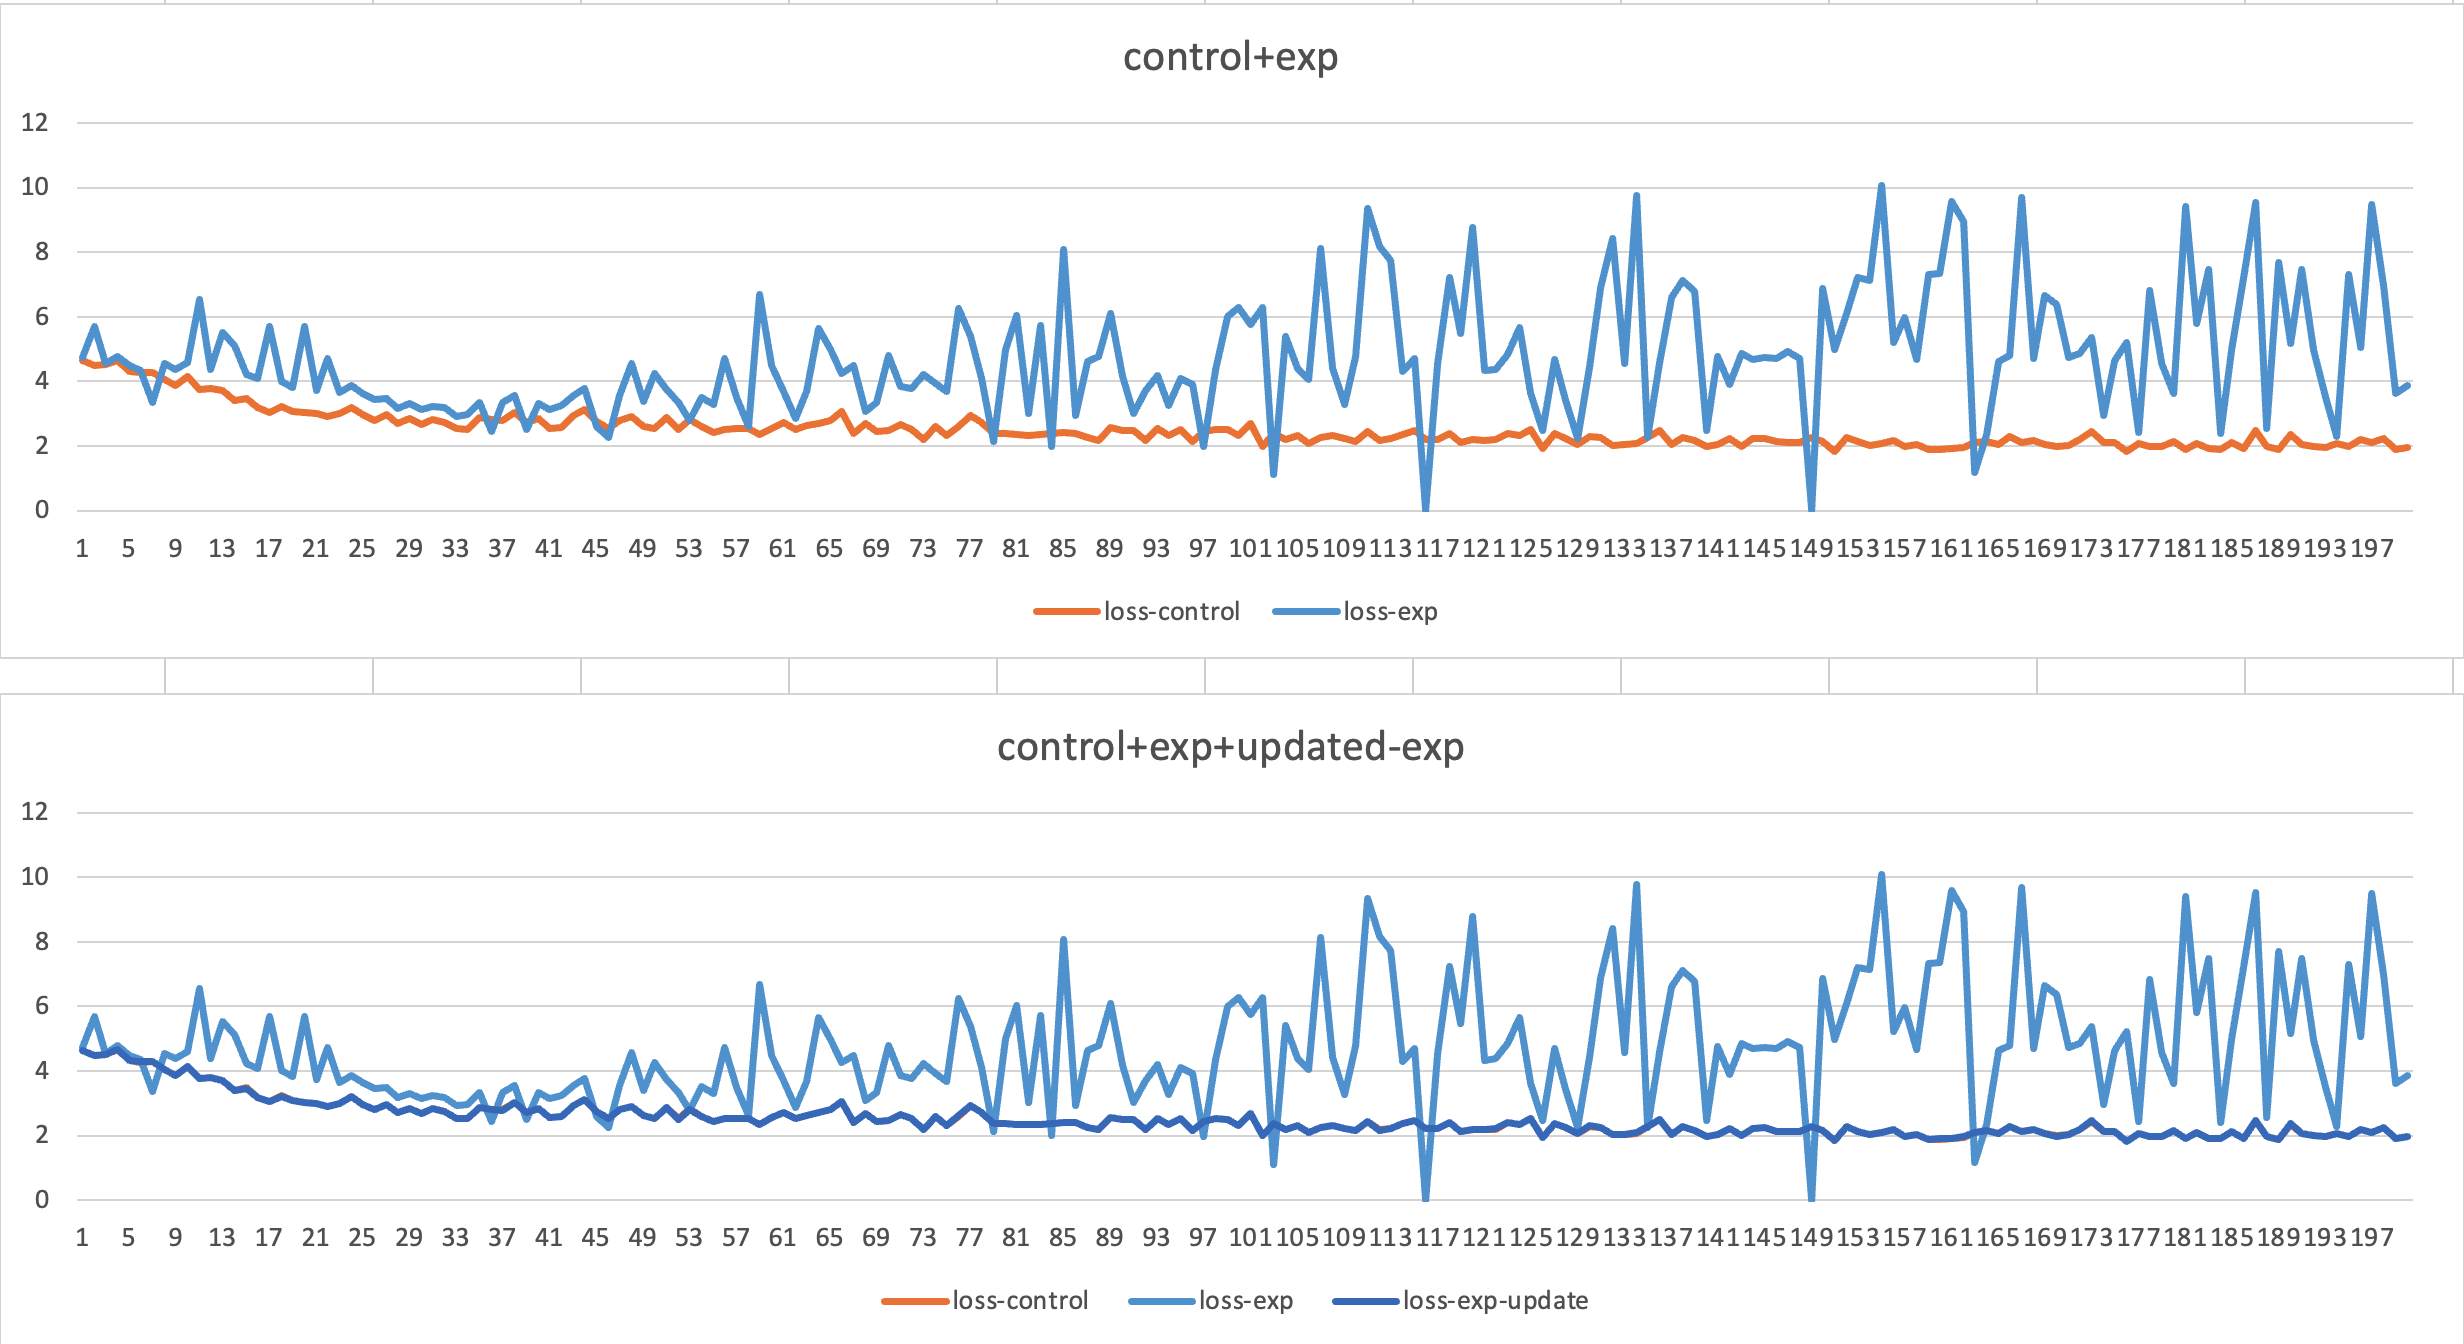
验证中发现,若不减去最大logit,新代码的损失不下降。这是因为softmax计算需要数值稳定,减去最大值可防止指数运算溢出。应用该技巧后,新代码与官方PyTorch的损失几乎无差异,证明了其正确性。
实测性能与验证局限
在微调Gemma2的测试中,新代码比官方实现耗时减少约2.8%。但作者仅从yahma/alpaca-cleaned中采样100个样本,运行60步两次,样本量小,结果可能不具广泛代表性。此外,理论复杂度降低的收益在实际中受多种因素影响。
进一步优化方向
作者建议使用Triton实现快速交叉熵损失,以获取更好性能。这表明当前基于PyTorch的实现仍有优化空间,LLM加速项目可借鉴类似思路,针对特定计算模式进行定制化内核开发。
Q&A
LLM训练中的交叉熵损失为什么可以简化?
因为LLM训练时目标只有一个有效值(其他元素为0),所以交叉熵可以简化为logsumexp(x) - x_y,而不需要完整的log_softmax计算。
快速交叉熵损失相比默认PyTorch实现能降低多少计算复杂度?
时间复杂度从O(4n)降低到O(2n),理论上可减少时间和GPU内存消耗。
在验证快速交叉熵损失时遇到了什么问题?
发现损失不下降,原因是未减去最大logit以稳定softmax;此外还有smoothed_loss的干扰。
如何解决快速交叉熵损失验证中损失不下降的问题?
在计算中减去最大logit(max-logit)以使softmax更稳定,之后损失与官方代码几乎一致。
微调Gemma2时,新交叉熵损失代码与官方代码的结果和耗时对比如何?
损失几乎无差异,耗时减少约2.8%(官方平均362.5秒,新代码352.5秒)。
作者对进一步优化LLM加速有什么建议?
建议使用Triton实现以获得更好的性能,并指出类似方法可用于其他加速场景。
