
如何定制模型以学习新技能
内容提要
本文介绍模型定制与微调方法。提示和RAG只能引导模型,无法改变参数;微调可将期望行为固化为默认能力。LoRA冻结原权重,仅训练小型适配器,降低更新成本;QLoRA进一步以4位量化存储冻结权重,节省显存。训练需准备高质量示例,划分训练、验证、测试集,并调整秩、学习率、批次等参数,防止过拟合,最终以实际任务效果评估。
延伸解读
微调与提示、RAG 的互补关系
文章指出,提示和 RAG 通过输入信息引导模型,但不改变模型参数;微调则通过训练将期望行为固化为默认能力。三者并非替代关系:提示定义任务,RAG 提供动态或需溯源的信息,微调解决反复出现的模式化弱点。实际应用中可组合使用,例如用提示指定任务、用 RAG 补充最新知识、用微调确保输出风格或分类标准稳定。
LoRA 与 QLoRA 的显存权衡
LoRA 冻结原权重,仅训练小型适配器,降低更新参数的开销;QLoRA 进一步将冻结权重以 4 位量化存储,减少显存占用,使有限显存下定制更大模型成为可能。但量化会引入近似误差,适配器虽可缓解部分影响,却不能保证修正所有错误。此外,显存降低不直接等于训练速度成比例提升,实际需求还受模型、序列长度、批次大小和实现方式影响。
训练配置中的关键取舍
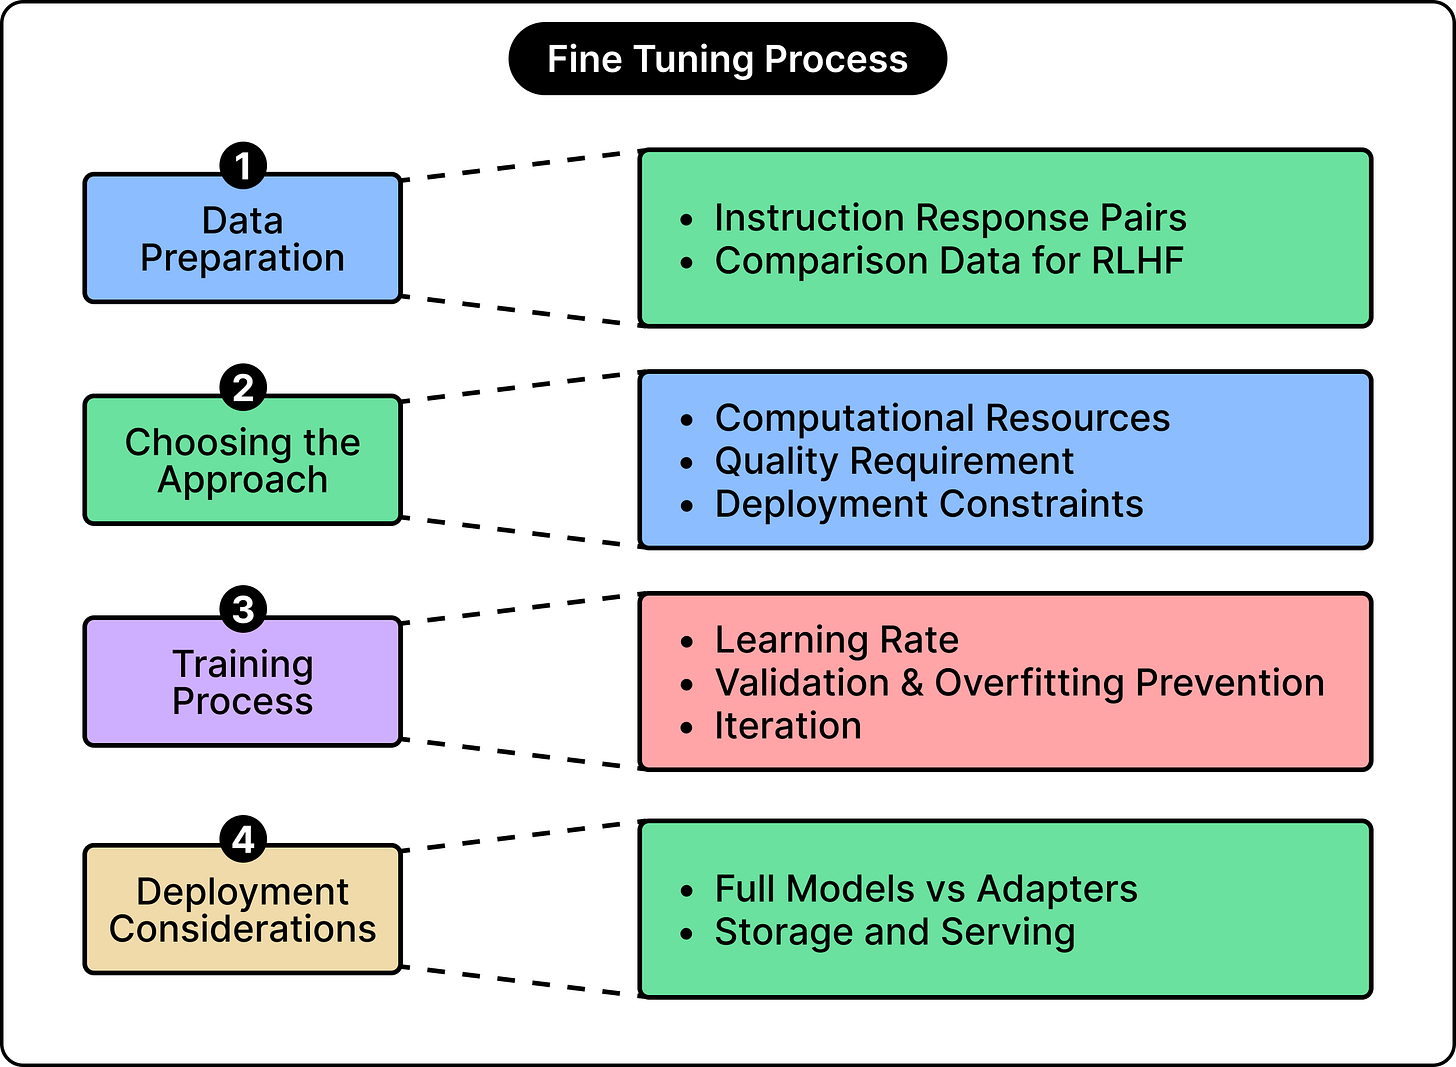
文章强调,秩决定适配器容量,过高不一定更好;学习率控制更新幅度,过大易不稳定,过小则进展缓慢;批次大小影响显存,梯度累积可在小批次下模拟更大更新。训练轮次通常 1 到 3 轮起步,但过长会导致过拟合,表现为训练集性能提升而验证集性能下降。应使用独立验证集选择检查点,测试集仅用于最终评估,并防止数据泄漏。
评估与部署的注意事项
评估应针对实际任务,如分类看标签正确性、抽取看值是否准确、摘要看关键细节是否忠实,格式正确不等于内容正确。同时需检查模型原有能力是否被削弱,因为适配器可能改变整体行为。部署时,适配器文件较小但需搭配兼容的基础模型;也可将适配器合并回基础权重,得到独立模型但失去存储优势。合并与量化支持因实现而异,部署前应评估最终版本。
Q&A
提示和RAG已经能引导模型了,为什么还需要微调?
提示和RAG都只通过请求时提供的信息来引导模型,不会改变模型已学习的参数。当模型反复出现同样的弱点,比如总是忽略某些细节或分类混淆时,微调可以用大量示例训练模型,让期望行为成为模型默认能力的一部分。
LoRA是怎么做到只训练少量参数的?
LoRA冻结原始模型权重,只在模型内部选定计算上附加小型适配器。适配器由两个小矩阵组成,训练只更新这两个矩阵的值,将学到的调整与原始计算结果结合,从而改变模型输出。这样无需重新学习模型已有的能力,大幅减少需要更新的参数量。
QLoRA和LoRA有什么区别?
LoRA减少了需要训练的参数量,但冻结的基础模型仍占用大量内存。QLoRA在LoRA基础上加入量化,通常将冻结的基础权重以4位形式存储,适配器保持较高精度。这样进一步降低显存占用,使得在固定内存预算下可以定制更大的模型。
微调时如何准备训练数据?
需要准备高质量示例,每个示例包含输入和期望输出。数据应划分为训练集、验证集和测试集,且重复或高度相似的示例不能跨集泄漏。示例要正确且一致,避免相似输入对应矛盾标签,否则模型会收到冲突指导。
微调时怎么防止过拟合?
训练轮数不宜过多,通常1到3个epoch可作为初始实验。如果训练集表现提升但验证集表现变差,就是过拟合的警告信号。应使用验证集比较设置并选择保存的模型版本,有用的检查点可能出现在最终训练步骤之前。
LoRA训练后如何部署到应用中?
LoRA训练产生适配器权重,可单独保存,文件通常比完整模型小得多,但需要兼容的基础检查点。部署时可以让同一基础模型搭配不同适配器服务不同任务,也可以将适配器调整合并到基础权重中,生成独立定制模型,但会失去适配器文件的存储优势。
