


何时可以仅凭离线评估上线?
内容提要
文章讨论能否仅凭离线评估决定上线AI功能。理论上可行,但需满足强假设:离线与线上效果关系稳定、数据同质、测量误差可控。噪声会低估相关性,例如实测24%而真实为60%。若LLM评审偏见随实验组变化,会扭曲结果。上线后停止A/B测试将失去真值,需通过审计样本监测漂移。实践中门槛较高,Spotify仍将离线评估与在线实验结合使用。
延伸解读
测量噪声会低估离线评估的预测力
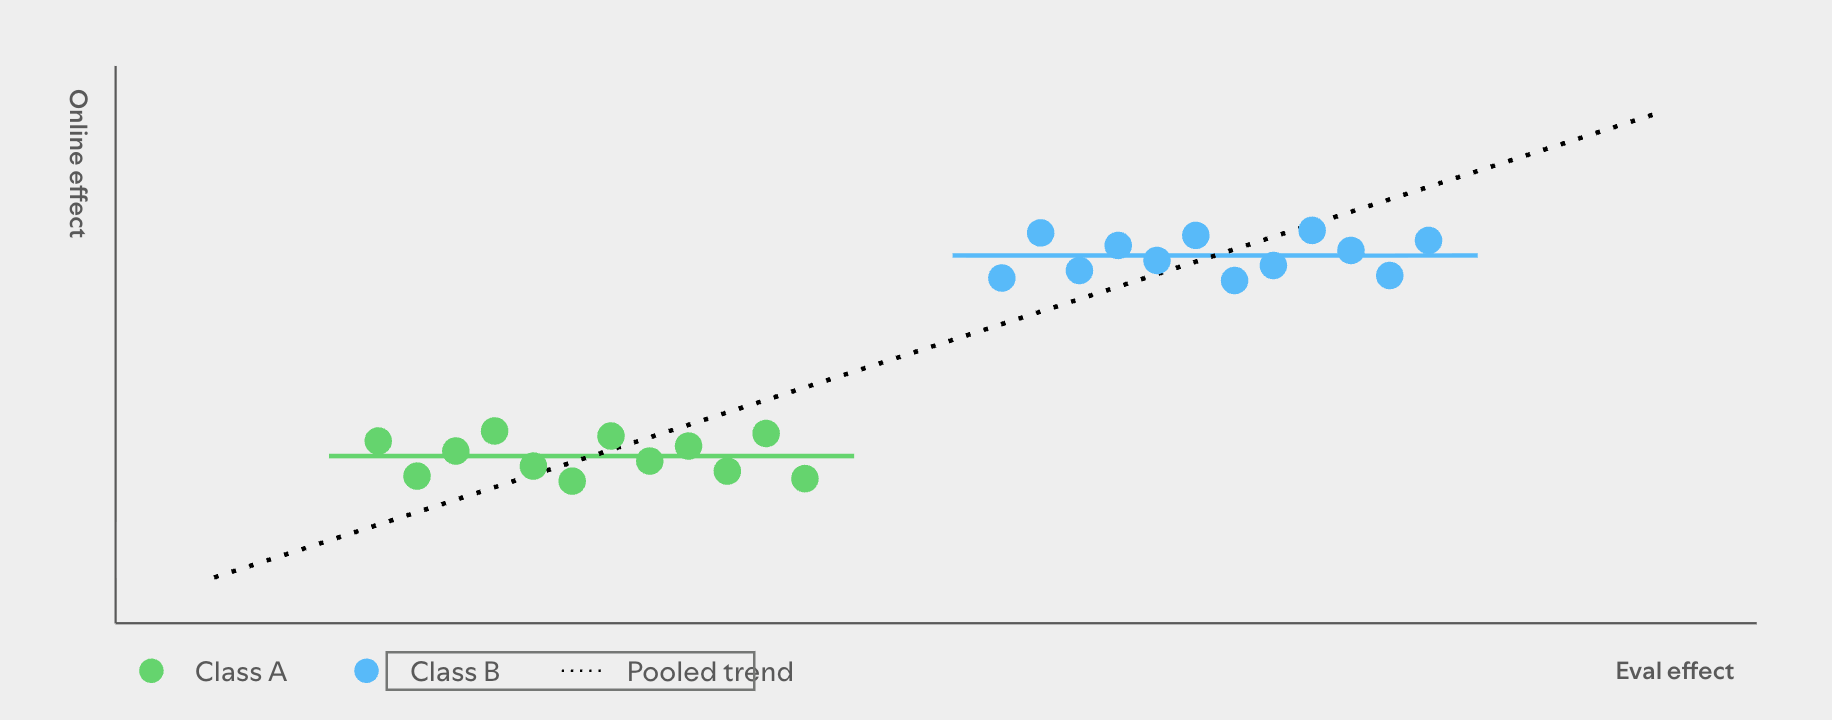
文章指出,离线评估分数和线上效应估计都带有抽样误差,直接计算两者的相关性会被噪声稀释。在示例中,朴素估计显示离线评估只能解释线上结果24%的变异,而真实值高达60%。这意味着团队若忽略测量误差,可能误判离线评估的价值,过早放弃一个有潜力的代理指标。要准确评估离线与线上的关系,需采用元分析方法校正误差,否则决策门槛可能设置不当。
LLM评审偏见与实验组相关时危害最大
使用LLM作为评审时,偏见本身不一定有问题,关键在于偏见是否随实验组变化。如果偏见独立于实验组,它会在处理组与对照组的差值中抵消;但如果偏见与实验组相关,比如评审偏爱自家模型生成的答案,就会扭曲离线评估效应,甚至翻转符号,让更差的版本看起来更好。在比较不同底层LLM的智能体系统中,这种偏见尤其普遍,会直接破坏基于离线评估的决策门控的有效性。
上线后停止A/B测试将失去真值监测能力
一旦部署基于离线评估的决策门控,被直接上线或否决的变更就不再运行A/B测试,团队只能观察到它们的离线评估效应,而无法获得线上真实效应。这导致在门控做出决策的区域失去地面真值,难以检测离线与线上关系是否随时间漂移。文章建议引入审计池,随机抽取一小部分本可直接决策的实验仍进行A/B测试,以持续验证门控并检测漂移,但代价是减少可完全依赖离线评估的决策数量。
实践门槛高,Spotify仍坚持离线与在线结合
文章强调,仅凭离线评估上线需要强假设,包括数据同质、关系稳定、测量误差可控等,这些假设难以验证且需持续复核。构建和维护干净的同质语料库很困难,稳健的决策规则可能牺牲效率,导致很少变更能仅凭离线评估决策。Spotify的实践是广泛使用离线评估迭代LLM产品,但仍将其与在线实验结合,以管理风险并优化离线评估可能无法充分捕捉的长期结果。
Q&A
仅凭离线评估上线AI功能,理论上需要满足哪些关键假设?
需要满足强假设:离线评估与线上效果的关系稳定且同质(即来自同一底层关系),数据可交换,测量误差可控且独立于实验组,LLM评审偏见不随实验组变化。这些假设难以验证且可能随时间漂移。
为什么测量噪声会低估离线评估与线上效果的相关性?
因为离线评估和线上效果都是带有抽样误差的估计值,噪声会稀释观察到的相关性。例如在论文示例中,朴素估计显示离线评估只能解释线上结果的24%,而真实相关性为60%。需用元分析方法校正测量误差。
LLM作为评审的偏见在什么情况下会严重影响离线评估决策?
当评审偏见与实验组相关时(即偏见随处理组变化),会严重扭曲观察到的处理效应和离线-线上关系强度,甚至翻转符号,使更差的版本看起来更好。若偏见独立于实验组,则可通过差分消除,不影响效果估计。
如果仅用离线评估做上线决策,如何监测离线与线上关系是否发生漂移?
需要引入审计池:随机抽取一小部分本可直接上线或砍掉的实验,仍然运行A/B测试,获得决策区域的配对观测,从而持续验证决策门、检测漂移并更新模型。代价是减少无需A/B测试的决策数量。
基于离线评估的决策门如何设置阈值来平衡风险?
阈值取决于替代关系的强度(R²)。若替代完美(R²=1),可直接用离线评估的常规显著性水平决策;关系越弱,需要越强的离线证据才能决策。通常设置:足够正的离线效应则上线,足够负的则砍掉,中间区域转A/B测试。
实践中仅靠离线评估上线的主要障碍有哪些?
主要障碍包括:构建和维护同质干净的数据集困难;强分布假设难以验证且需持续复核;测量误差和LLM评审偏见难以可靠表征;关系可能随时间漂移;保守阈值下可能只有极少数变更能仅凭离线评估决策,效率收益有限。
Spotify目前是如何使用离线评估的?
Spotify广泛使用离线评估来迭代LLM和生成式AI产品,但仍将其与在线实验结合使用。这样既能管理风险,也能评估和优化离线评估可能无法充分捕捉的长期结果。
