


为什么单独使用大型语言模型无法满足公司的预测需求
内容提要
大型语言模型(LLMs)不适合大多数涉及数值数据的商业应用。传统的机器学习模型更高效且更易于优化。LLMs 缺乏可解释性和可说明性,使其不太适合商业用例。然而,LLMs 可以帮助企业将需求转化为模型。Pecan 的预测生成AI将LLMs与其机器学习平台结合,使预测建模对商业用户更易于访问,帮助公司在AI方面取得成功。
延伸解读
LLM与数值预测的错配
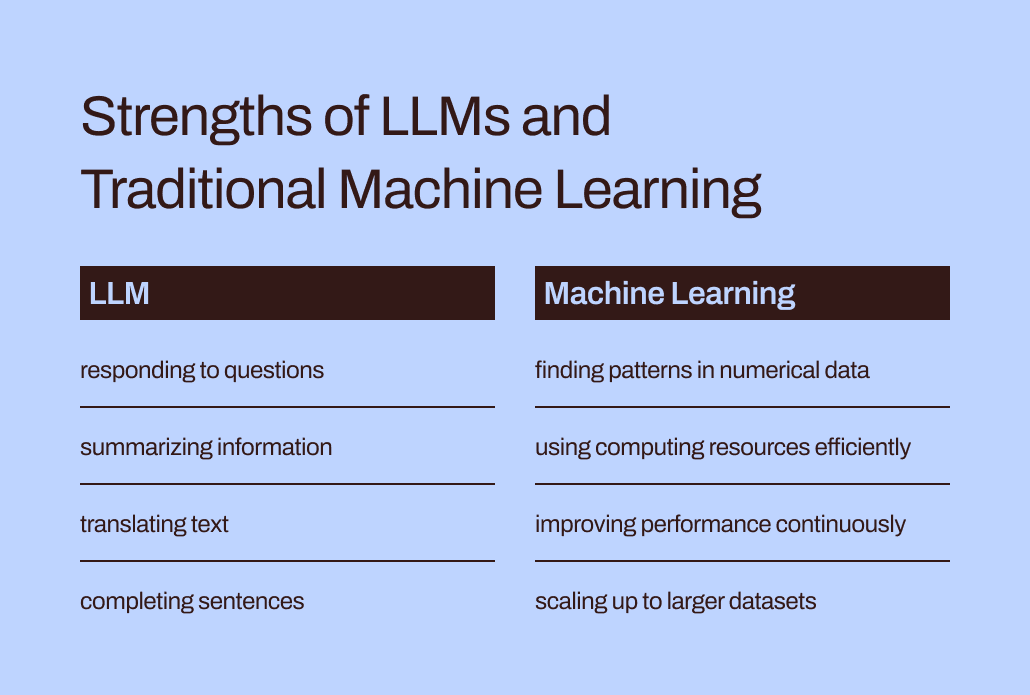
文章指出,LLM的设计目标是预测文本序列中的下一个词,而非处理数值表格数据。当企业试图用LLM预测客户流失或交易数据时,模型缺乏针对数值模式训练的基础,效果往往不佳。传统机器学习模型如决策树或神经网络,专门为数值数据优化,在效率和准确性上更胜一筹。因此,企业应避免将LLM直接用于核心预测任务,而应选择匹配数据类型的工具。
可解释性不足带来的商业风险
LLM的决策过程难以追溯,连ChatGPT自身也无法明确说明其回答的具体来源。这种不透明性在商业场景中可能引发合规问题,尤其是受监管行业要求解释模型预测依据时。传统机器学习模型通常更易解释和说明,能提供清晰的决策逻辑,更适合需要审计和问责的业务用例。企业若忽视这一点,可能面临监管处罚或信任危机。
LLM作为需求翻译的桥梁
尽管LLM不擅长直接预测,但能帮助业务用户将自然语言需求转化为建模问题。Pecan的Predictive GenAI利用LLM理解用户意图,自动生成预测问题和SQL查询,降低了机器学习的使用门槛。对于缺乏数据科学团队的企业,这能加速AI项目启动,弥合业务需求与技术实现之间的鸿沟。LLM在此扮演的是辅助角色,而非替代传统模型。
Q&A
为什么大型语言模型不适合处理商业预测任务?
大型语言模型(LLMs)主要为自然语言处理设计,擅长处理文本而非数值数据。商业预测通常涉及数值和表格数据,而LLMs在这类任务上表现不佳。此外,LLMs训练复杂、计算需求高,且缺乏可解释性和可说明性,难以满足商业合规要求。因此,传统机器学习模型更适合商业预测。
传统机器学习模型在处理数值数据方面有哪些优势?
传统机器学习模型(如决策树、神经网络)专门为处理数值和表格数据设计,更高效且易于优化。它们需要更少的计算资源,速度更快,成本更低,且通常更具可解释性和可说明性,适合商业应用。
LLMs在商业中还有哪些用途?
尽管LLMs不适合直接进行预测,但它们可以帮助企业将业务需求转化为模型。例如,LLMs可以理解用户用自然语言描述的问题,并生成相应的预测建模步骤,从而降低AI应用的门槛。
什么是Pecan的Predictive GenAI?
Pecan的Predictive GenAI是一种将LLMs与机器学习平台结合的方法。它利用LLMs的语言能力,通过Predictive Chat收集用户输入,定义预测问题,并生成Predictive Notebook,其中包含预填充的SQL查询,以自动化数据准备、特征工程、模型构建和部署,使预测建模对商业用户更易用。
为什么LLMs的可解释性对商业应用很重要?
商业应用常需满足监管要求,必须能够解释影响模型预测的因素。LLMs的决策过程难以追溯和解释,缺乏透明度和可说明性,因此不适合需要合规性的商业场景。传统机器学习模型通常更易解释。
企业采用AI进行预测建模面临哪些挑战?
尽管机器学习工具已存在十多年,但许多企业仍难以成功实施AI。例如,Workday研究显示42%的北美公司尚未开始使用AI或处于早期探索阶段。缺乏将业务问题转化为模型的能力是主要障碍,而LLMs可以帮助弥合这一差距。
