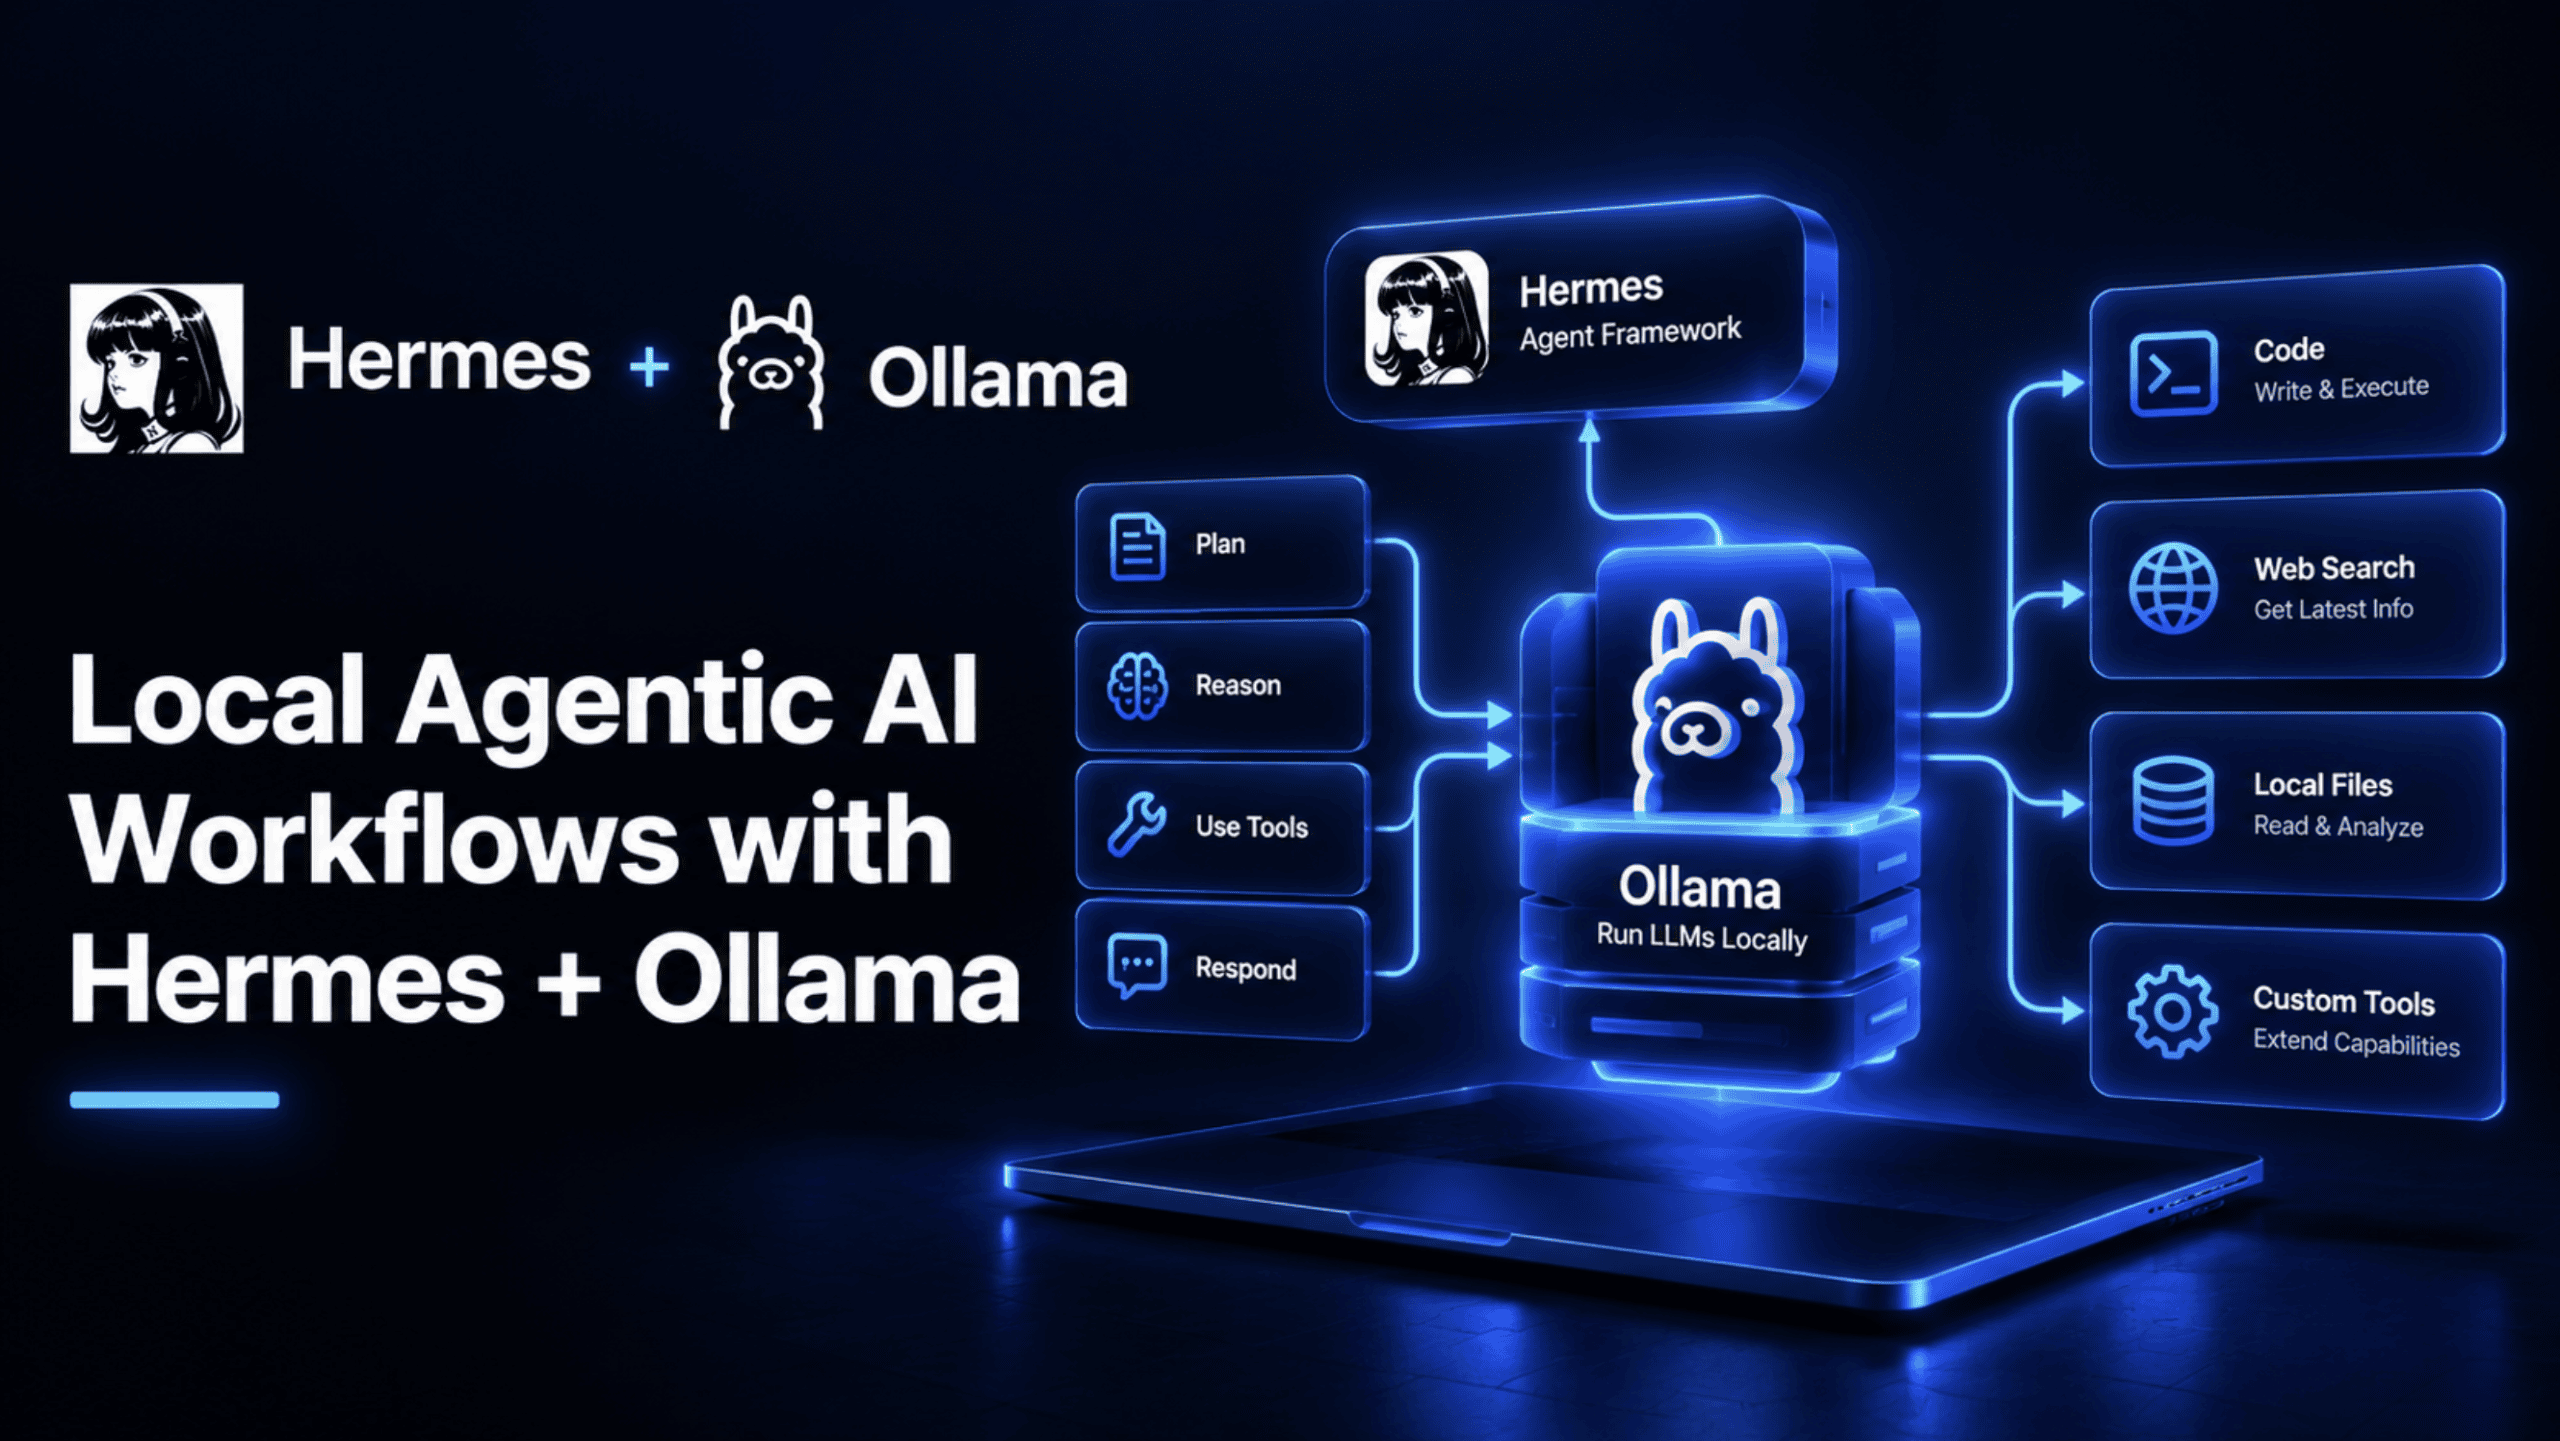

使用 Hermes + Ollama 构建本地智能体 AI 工作流
内容提要
介绍用 Hermes Agent 搭配 Ollama 搭建完全本地、零成本的智能体工作流:安装 Ollama 并拉取支持工具调用的 gemma4:31b 模型,配置 Hermes 指向本地端点,优化上下文窗口、保持模型常驻、启用 GPU 加速,接入 Telegram 远程访问,并配置云端回退应对难题。
延伸解读
本地智能体的成本与隐私权衡
文章指出,云端AI编码会话每次成本约0.60至0.80美元,重度使用可达5至20美元,且所有文件、代码和对话都会发送到第三方服务器。本地方案虽然零API成本且数据不出硬件,但需要前期硬件投入,并接受推理速度较慢的现实。对于频繁自动化或处理敏感数据的用户,这种权衡可能更有利。
工具调用能力是模型选择的关键
并非所有本地模型都能胜任智能体任务。文章对比的模型中,只有gemma4:31b支持工具调用,能执行文件编辑、终端命令和网页搜索等操作;而gemma2:27b、gemma2:9b和llama3.2:3b仅能进行对话,无法实际执行动作。因此,若需要真正的智能体工作流,必须选择支持工具调用的模型,否则Hermes只能聊天而无法完成任务。
性能优化:上下文、常驻与GPU
Ollama默认上下文仅2048令牌,远低于Hermes所需的64000令牌,需通过Modelfile调整。默认模型闲置5分钟后卸载,导致下次请求重新加载,可通过keep_alive参数保持常驻。若有NVIDIA GPU,Ollama会自动卸载部分层到GPU,即使部分卸载也能带来明显加速。这些优化对交互体验和网关机器人尤为重要。
混合架构:本地为主,云端兜底
文章建议配置云端回退模型,仅在本地模型失败或反复产生错误响应时触发,而非每次请求都调用。这样既保持了大部分日常使用的零成本和隐私性,又能在遇到真正困难的问题时获得高质量回答。这种混合模式避免了全本地或全云端的极端,实现了成本与能力的平衡。
Q&A
Hermes Agent 是什么?它和普通聊天界面有什么区别?
Hermes Agent 是 Nous Research 开发的开源 AI 智能体,采用 MIT 许可证,当前版本 0.21.1。它提供桌面应用和 CLI 两种形式。与普通聊天界面不同,它具备真正的智能体能力:可以编辑文件、运行终端命令、浏览网页,并能将任务委托给拥有独立对话和工具的隔离子智能体。此外,它还有持久记忆、消息网关(连接 Telegram、Discord 等)以及支持五种隔离后端的沙箱系统。
为什么搭建本地智能体工作流必须选择支持工具调用的模型?
因为 Hermes 作为智能体,需要调用工具来编辑文件、运行命令、搜索网页等。如果模型不支持工具调用,它只能进行文本聊天,无法真正执行操作。文章中的模型对比表显示,只有 gemma4:31b 支持工具调用,因此它是构建文件整理、网页搜索等智能体任务的真正起点,而 gemma2:27b、gemma2:9b、llama3.2:3b 均不支持工具调用。
如何配置 Hermes 使用本地 Ollama 端点?
有两种方式:一是运行 hermes setup 向导,选择 Custom Endpoint,输入 http://localhost:11434/v1 作为基础 URL,API 密钥留空,模型设为 gemma4:31b;二是直接编辑 ~/.hermes/config.yaml,设置 model.default 为 gemma4:31b,provider 为 custom,base_url 为 http://localhost:11434/v1。provider 设为 custom 告诉 Hermes 将其视为通用的 OpenAI 兼容端点。
如何优化本地智能体工作流的运行速度?
有三个主要方法:1. 增大 Ollama 的上下文窗口,默认 2048 令牌太小,Hermes 需要至少 64000 令牌,可通过创建 Modelfile 并设置 PARAMETER num_ctx 64000 来生成新模型;2. 保持模型常驻内存,默认 5 分钟无活动即卸载,可发送请求设置 keep_alive 为 24h;3. 启用 GPU 加速,Ollama 会自动将模型层卸载到 NVIDIA GPU,可用 ollama ps 查看卸载情况。
如何让本地智能体通过 Telegram 远程访问?
首先通过 Telegram 的 @BotFather 创建机器人并获取令牌,然后在 ~/.hermes/config.yaml 中添加 platforms.telegram 配置块,设置 enabled: true 和 token。之后运行 hermes gateway 启动网关,而不是普通的 CLI 会话。这样就能从手机通过 Telegram 与同一个智能体交互,共享相同的内存和模型。
本地模型处理不了的问题怎么办?如何配置云端回退?
可以在 Hermes 配置中设置 fallback_providers 列表,例如添加 provider: openrouter 和 model: anthropic/claude-sonnet-4。该回退仅在主模型失败或反复产生格式错误响应时触发,而非每次请求都调用。这样大部分日常使用保持免费本地,只有真正困难的问题才会调用付费 API,实现成本可控的混合方案。
