本指南介绍在Ubuntu 24.04系统上构建数据智能体的方法,使用Ollama本地大模型、MySQL数据库、TraeCode开发工具和Python语言。准备工作包括安装Ollama、MySQL、TraeCode及通过Anaconda3安装Python。构建实践首先在终端执行trae-cn命令启动TraeCode。
OGX 是 Meta Llama Stack 更名后的开源智能体 API 服务器,兼容 OpenAI 接口,支持任意模型与基础设施。文章介绍如何用 OGX 和 Ollama 构建 DocBrain 应用:上传文档实现自动 RAG 检索,并通过自定义工具将文档中的待办事项保存到本地文件。核心优势是本地开发与生产部署可无缝切换,无需重写应用。
iTerm2 3.7.5 正式版发布,首次加入简体中文等多语言界面,结束 24 年无中文历史。开发者曾称实现困难,后态度转变。更新还带来浮动终端面板、原生 Ollama 支持、跟踪 Claude Code 与 Codex CLI 任务状态,以及防止 Mac 任务时自动睡眠等功能。
该文本仅为作者身份信息,无实质文章内容,无法总结。
2026年10月,AWS发布基于阿里Qwen3.5的开源决策模型Strands Decider 2B,接口与TypeSafe AI的Jev相同。该模型接收应用状态和类型化问题,返回带概率的结构化答案,不生成文本,充当AI应用的判断层。TypeSafe的System One模式正成为行业标准,AWS、Upstage、Ollama等纷纷兼容。但研究显示Jev决策可被对抗性上下文误导,且OpenAI可能推出竞争性模式。
作者在RTX 4090 24GB上以Strata替代Ollama推理Qwen3.8-Flash-Next(512专家MoE),专家权重驻留内存、GPU仅缓存热专家,配256K上下文与int8 KV。解码中位约100–110 tok/s,冷预填充约2500–2800 tok/s。官方GSQ-RCO IQ3_S量化优于Unsloth,整体探索时间从12分钟降至8分钟。服务单请求串行,两三人使用尚可。
Ollama 简化了本地语言模型运行,但需确保模型与上下文能装入内存。`ollama ps` 可查看模型占用及 GPU/CPU 分配,低于 100% GPU 表示部分已转 CPU,生成变慢。macOS 桌面应用需通过 `launchctl setenv` 设置环境变量,否则配置无效。传入 JSON schema 可约束结构化输出,而 "json" 仅保证合法 JSON。速查表还涵盖磁盘管理、API 端点、Modelfile 及环境变量。
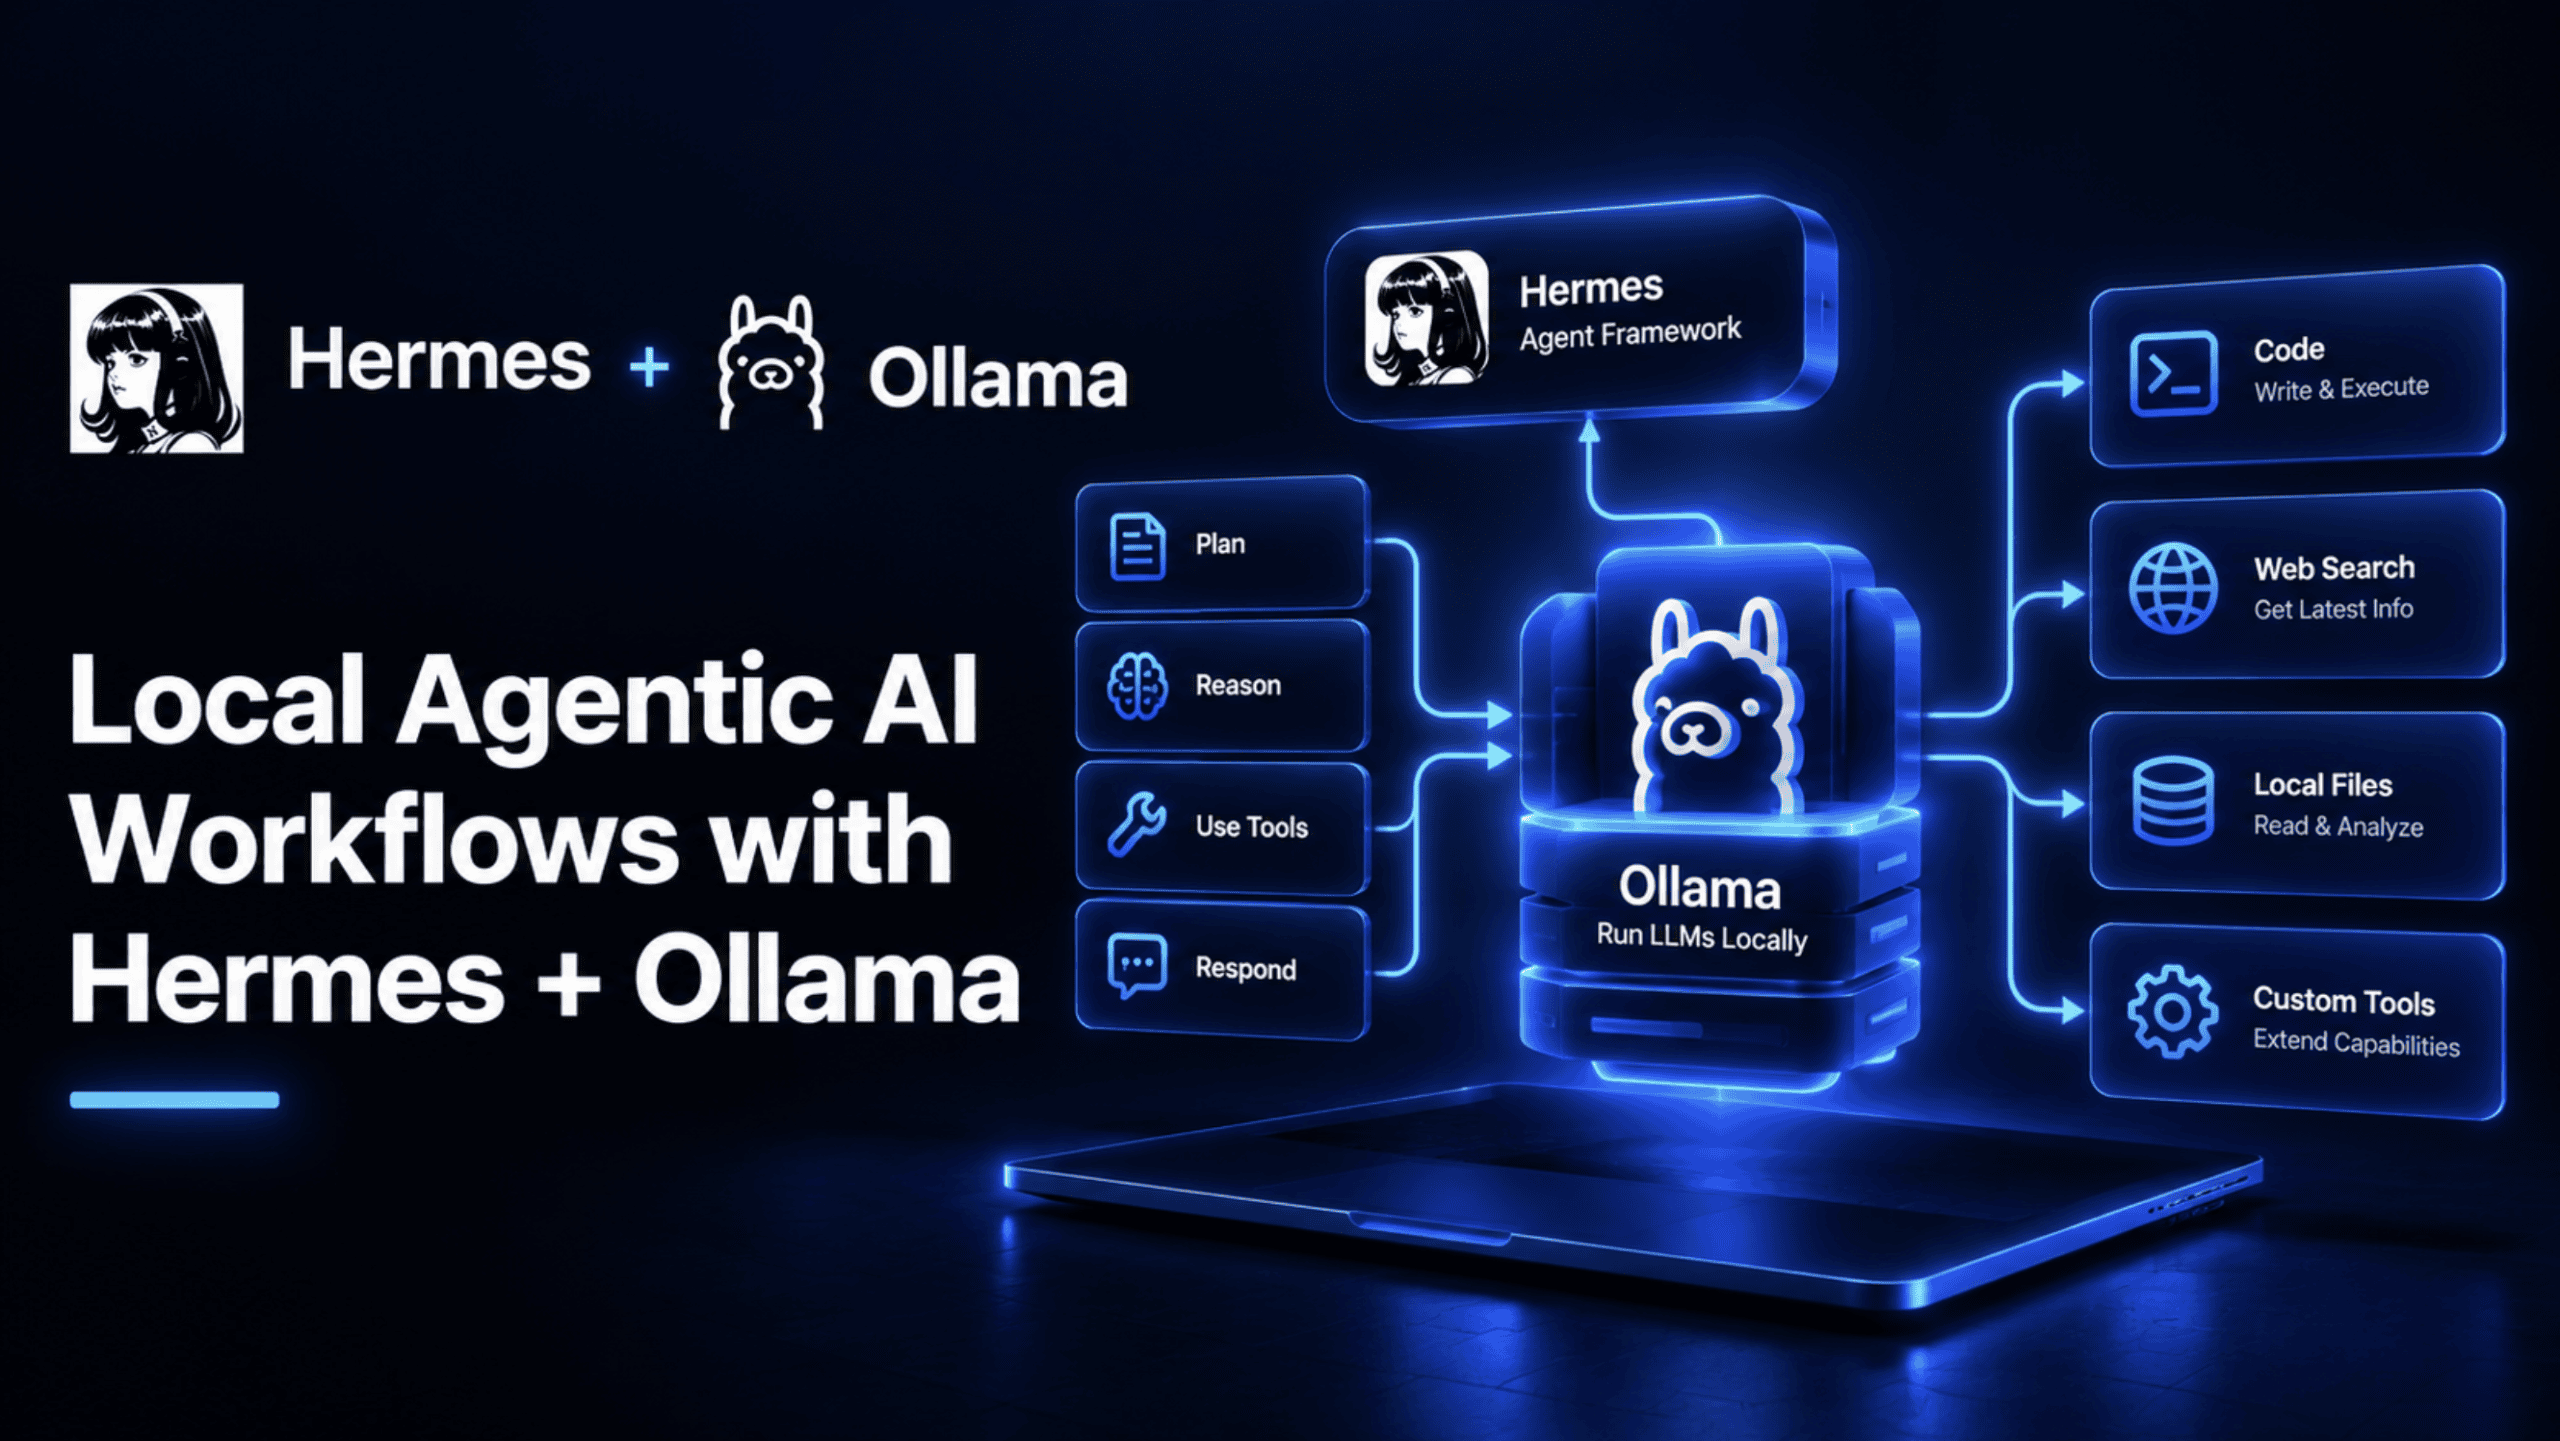
介绍用 Hermes Agent 搭配 Ollama 搭建完全本地、零成本的智能体工作流:安装 Ollama 并拉取支持工具调用的 gemma4:31b 模型,配置 Hermes 指向本地端点,优化上下文窗口、保持模型常驻、启用 GPU 加速,接入 Telegram 远程访问,并配置云端回退应对难题。
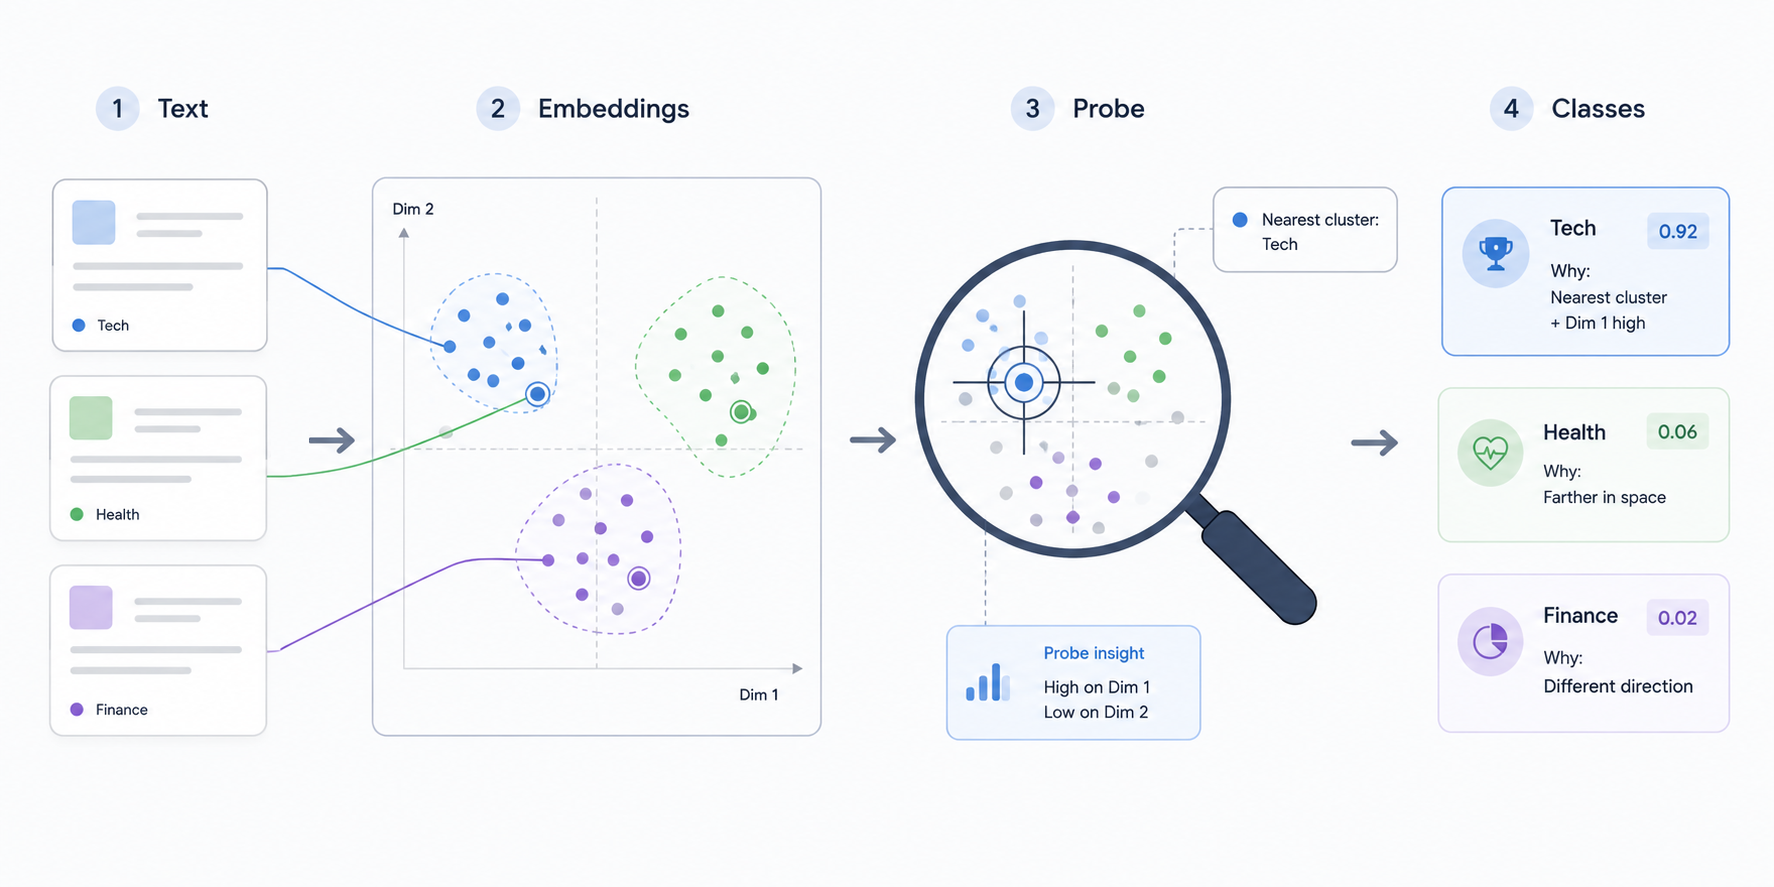
本文介绍如何利用Scikit-LLM和本地Ollama模型生成电影评论嵌入,训练逻辑回归分类器评估质量,并通过UMAP降维可视化语义结构,最后使用SHAP值识别关键嵌入维度,以提升LLM文本分类的可解释性。
Ollama重新推出与Claude Desktop的集成,允许用户通过Ollama连接本地或云端模型(如Qwen、DeepSeek等),在Claude界面内使用。此功能支持Mac应用,用户可切换模型,强调成本、速度和灵活性。Ollama旨在让开源模型更易用,未来或支持Windows。
本地小语言模型(SLM)已成熟,可在笔记本或消费级GPU上运行,提供隐私保护、成本可控和低延迟优势。选择模型需考虑参数规模、任务特性和量化格式,Ollama工具简化部署。通过配置上下文窗口、温度和系统提示优化性能,适用于文档问答、编码助手和代理工作流。建议先用小型评估集验证模型质量,再逐步集成。
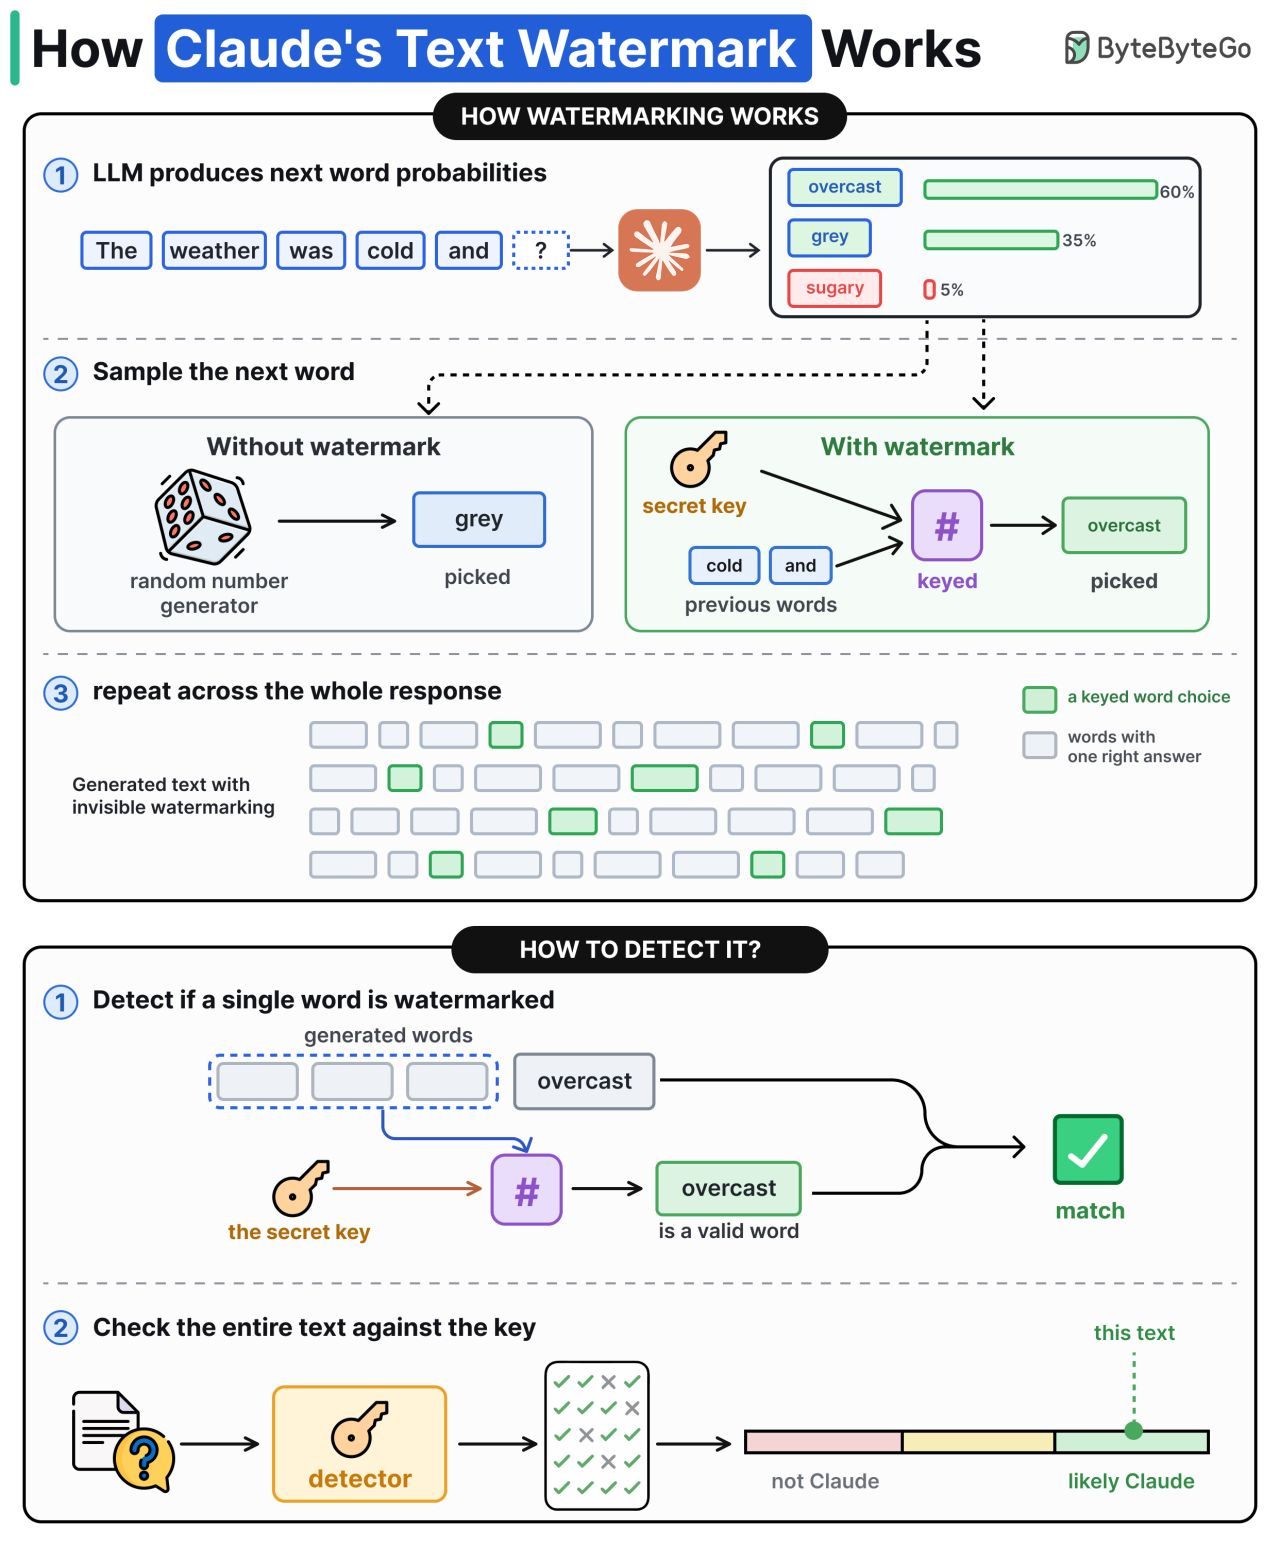
本文对比了三种开源模型推理引擎:Ollama适合本地开发,vLLM适合高并发服务,SGLang适合多轮对话和智能体场景。此外,简述了Claude文本水印技术原理、Git常用命令、Kafka与RabbitMQ的区别,以及12个热门Agent技能仓库。
本文介绍如何用三条命令将Qwen3.8-27B模型配置为本地AI编程助手。首先检查硬件(建议24GB显存和32GB内存),然后安装Ollama、下载模型,最后在OpenCode中启动。测试显示模型能快速构建并测试应用,适合初学者快速体验本地AI编程,无需复杂配置。
本文介绍如何构建一个始终在线的流式AI代理,用于监控维基百科实时编辑流并检测恶意编辑。系统采用两阶段漏斗设计:第一阶段用廉价Python逻辑过滤大多数无关编辑,第二阶段仅对可疑事件调用本地LLM(通过Ollama)进行深度分析。代理支持实时流式输出推理过程,并通过SSE广播给客户端。文章强调效率、自动重连和优雅降级对始终在线系统的重要性。
本文介绍Ollama的安装与使用,涵盖常用命令及systemd服务模式。通过systemctl可管理服务,如重启、启动、停止,并可禁用或启用开机自启。若需手动运行,可先停止服务并禁用,再自行启动。
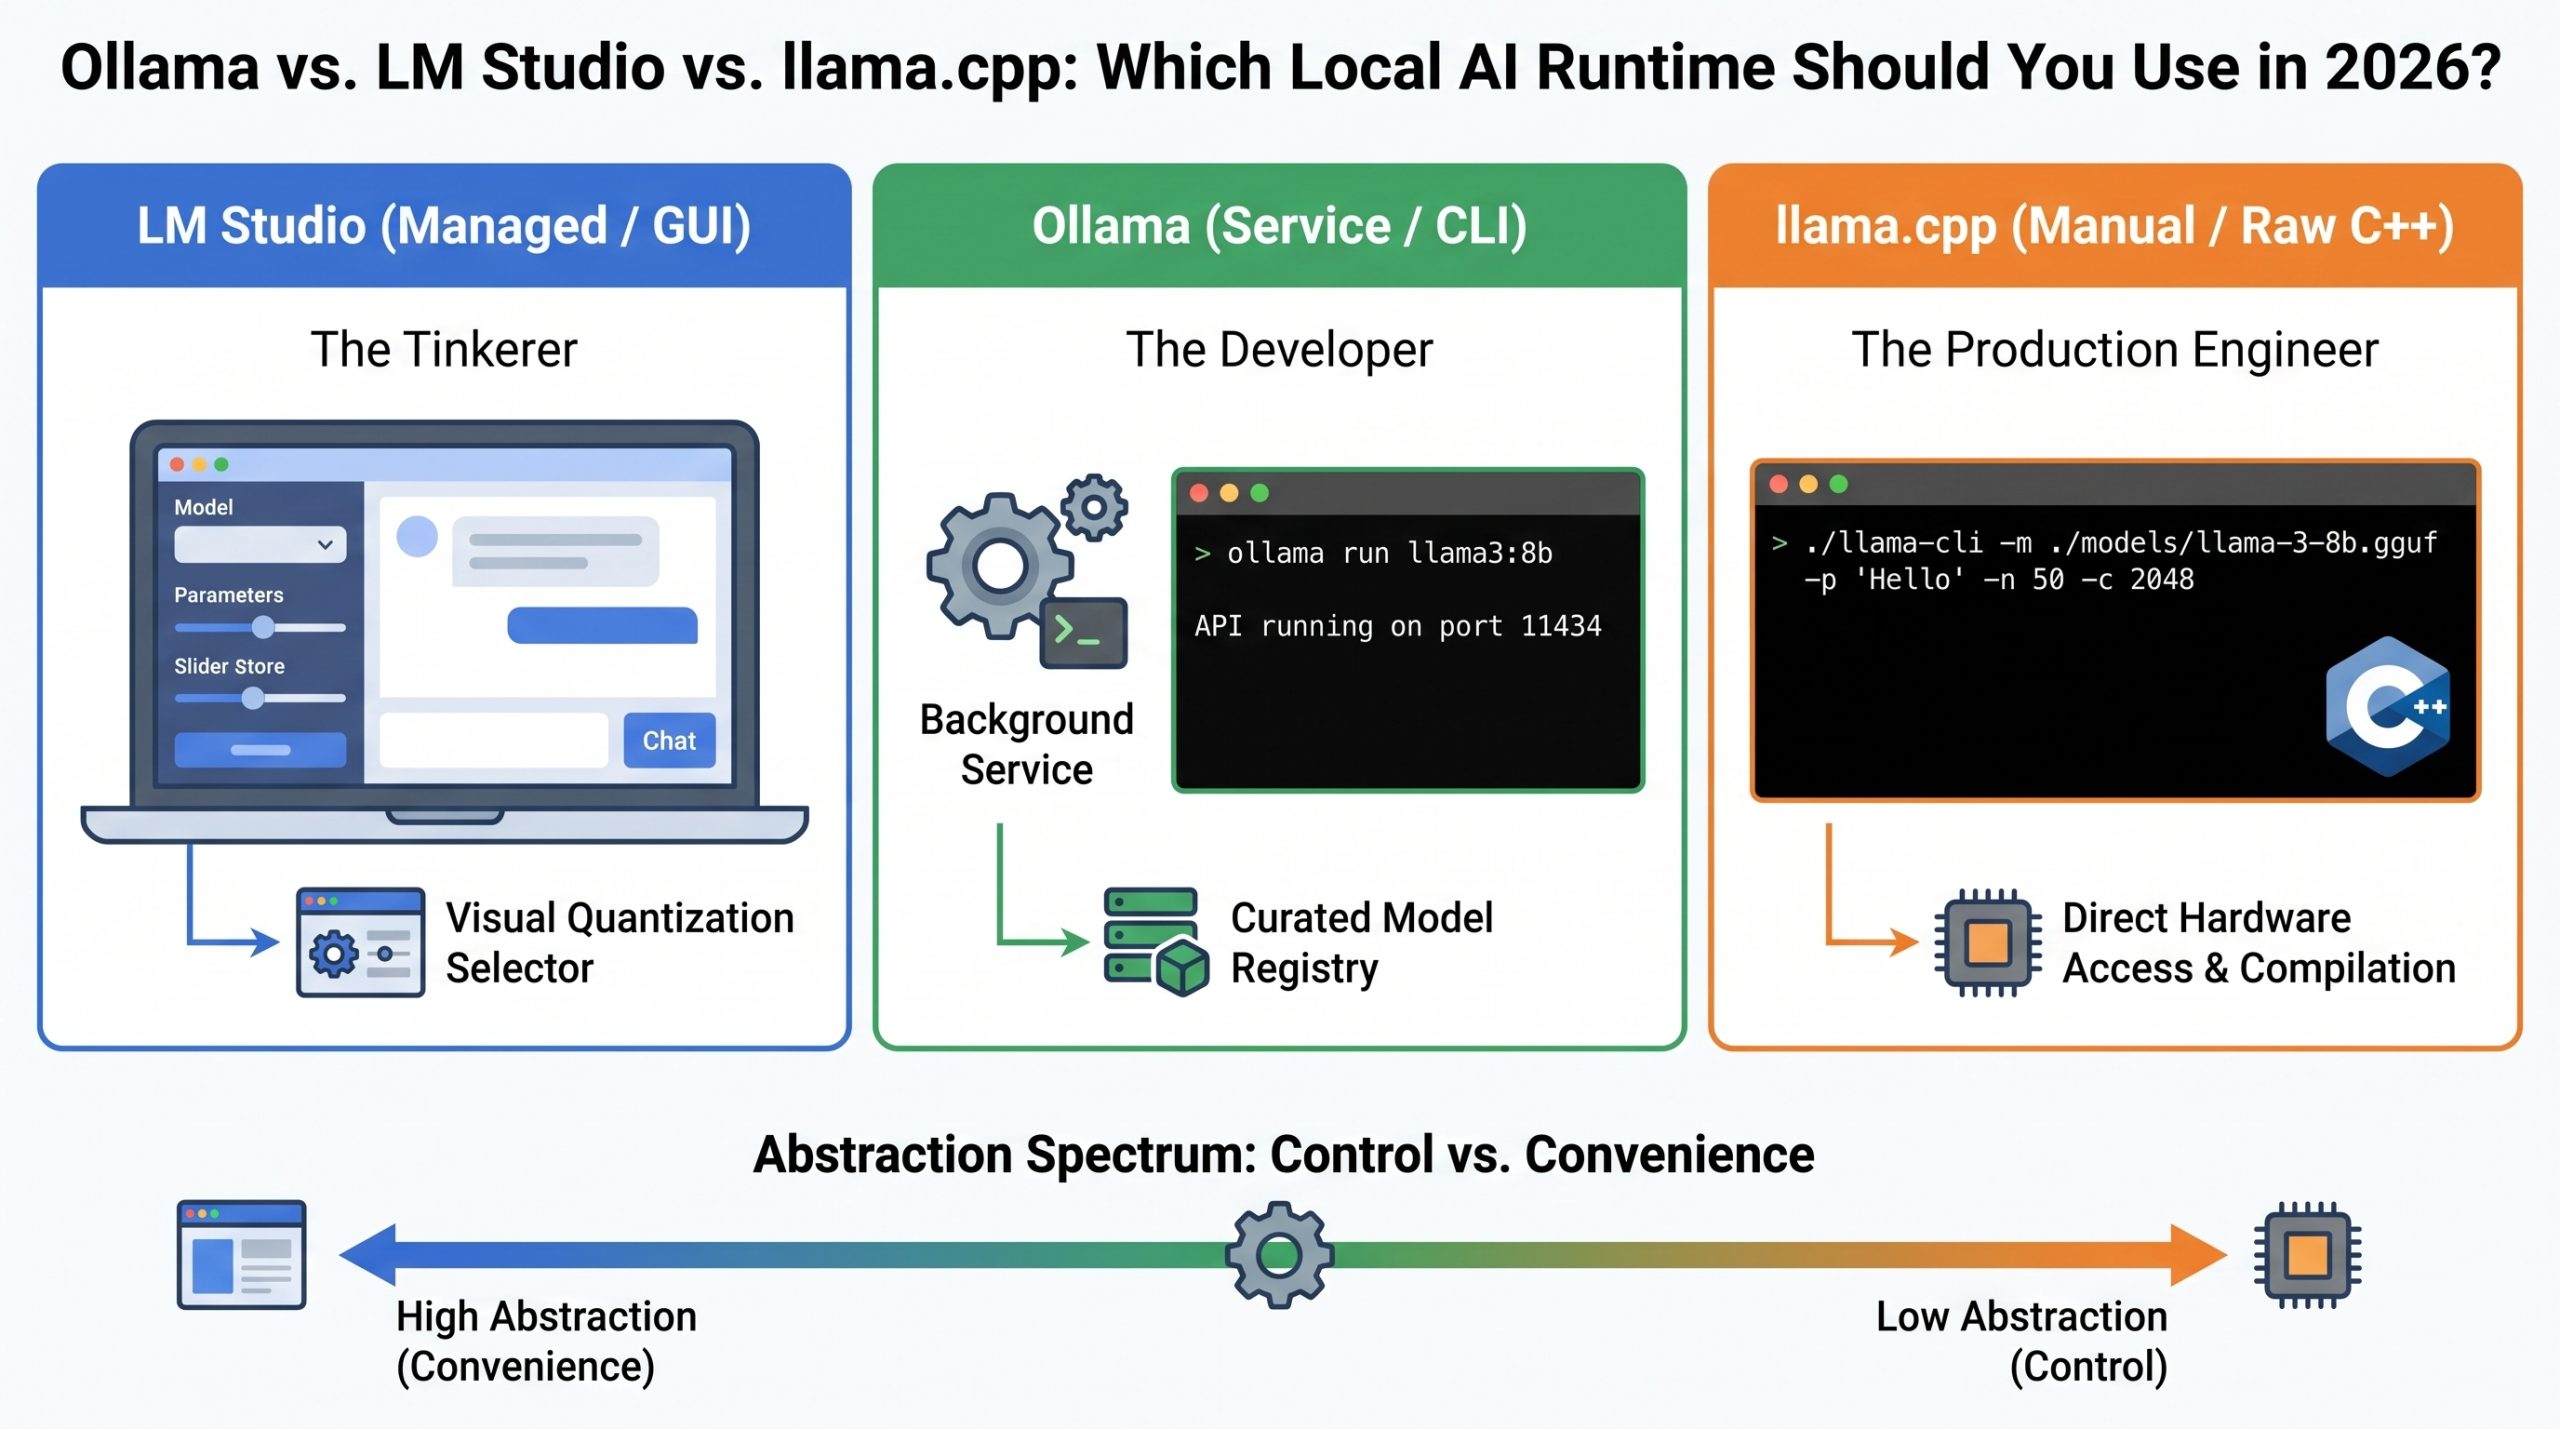
本文比较了Ollama、LM Studio和llama.cpp三种本地AI运行时。LM Studio适合初学者,提供图形界面和可视化量化控制;Ollama适合开发者,提供简洁CLI和API集成;llama.cpp适合追求极致控制的生产工程师,支持手动量化。三者共享同一推理引擎,用户可按需从LM Studio迁移至Ollama再至llama.cpp。
OpenCode 是一款开源 AI 编程代理,支持多模型提供商和隐私保护,可接入 Android Studio 等 IDE。文章介绍通过 JetBrains AI Assistant 插件启用 OpenCode Agent,配置 Zen 免费模型或自定义 OpenAI 兼容 API,并设置中文回复规则。还涵盖 Token 优化、本地 Ollama 方案及项目级规则建议,帮助开发者高效使用。
本教程演示如何通过提示工程和上下文工程提升AI代理性能,使用LangChain v1、Ollama、Qwen和Python构建本地代理,对比基线、优化提示和增强上下文三种模式。结果显示,清晰指令和丰富上下文能显著改善输出质量,无需更换模型。同时提醒注意提示注入风险,并建议通过系统提示设置防护。
本教程介绍如何使用LangSmith监控本地AI代理。通过LangChain v1、Ollama和Qwen构建代理,并启用LangSmith追踪,可在Web界面查看模型调用、工具使用和延迟。步骤包括安装Ollama、配置环境变量、构建带工具调用的代理,并展示追踪结果。LangSmith支持调试和监控,但为专有服务,开源替代方案为Langfuse。
本教程介绍如何用LangChain v1、Ollama、Qwen和Python构建本地AI代理评估工具。通过测试用例、规则检查和LLM评判,生成通过/失败摘要,无需API费用。示例代理含时间和字数工具,评估发现代理遵循用户指令避免工具调用导致失败,通过修改系统提示词修复,最终全部通过。建议结合规则检查与LLM评判,并手动抽查结果。
完成下面两步后,将自动完成登录并继续当前操作。