


周刊第16期: Andrej Karpathy 讲 AI
内容提要
本期周刊解读Andrej Karpathy的三次演讲:提出“软件3.0”,即用自然语言提示词编程,大模型更像操作系统而非电网;详解ChatGPT训练三阶段——预训练、监督微调、强化学习,并分析幻觉成因与缓解方法;介绍使用大模型的技巧,如联网搜索、深度研究、代码解释器、辅助编程等,强调应认识其能力边界。
延伸解读
软件3.0:用自然语言编程的时代
Karpathy 提出软件3.0概念,认为编程语言从代码变为自然语言提示词。这不仅是技术变革,更意味着大量现有代码需要重写。同时,他将大模型类比为操作系统而非电网,强调其生态核心地位,并指出当前阶段类似1960年代操作系统刚起步,是绝佳时机。
大模型幻觉的根源与缓解之道
文章解释幻觉源于大模型本质是概率性token补全机器,缺乏事实检索能力。缓解方法包括工具调用联网搜索,以及在训练中增加不确定性数据集,让模型学会说“不”。这提醒用户,大模型并非全知,需认识其能力边界。
半自主应用:平衡效率与可控性
Karpathy 以Cursor为例,提出“半自主应用”概念,保留传统界面让人类主导,同时集成大模型提升效率。在业务场景中,并非越自主越好,AI过于主动可能拖慢效率。这为AI应用设计提供了实用思路:根据任务复杂度灵活调整自主程度。
用好大模型的实用技巧
文章介绍联网搜索、深度研究、代码解释器、辅助编程等技巧,强调应认识大模型能力边界。例如,切换话题时开启新对话窗口以避免干扰;利用Python解释器进行精确计算;通过上传文件增强上下文理解。这些方法能帮助用户更高效地利用大模型。
Q&A
什么是软件3.0?它和软件1.0、2.0有什么区别?
软件3.0是Andrej Karpathy提出的概念,指用自然语言提示词(prompts)编程大模型。软件1.0是程序员直接写代码;软件2.0是训练神经网络,权重即软件;软件3.0则是通过提示词指挥大模型完成任务,编程语言变成人类语言。
为什么说大模型更像操作系统而不是电网?
Karpathy认为大模型不是单纯商品,而是生态核心,像操作系统一样有开源闭源、多家厂商,最终可能演变成少数生态。LLM本身像CPU,上下文窗口像内存,应用通过调度这些资源解决问题。而电网只是基础设施类比。
ChatGPT的训练过程分为哪几个阶段?各自的作用是什么?
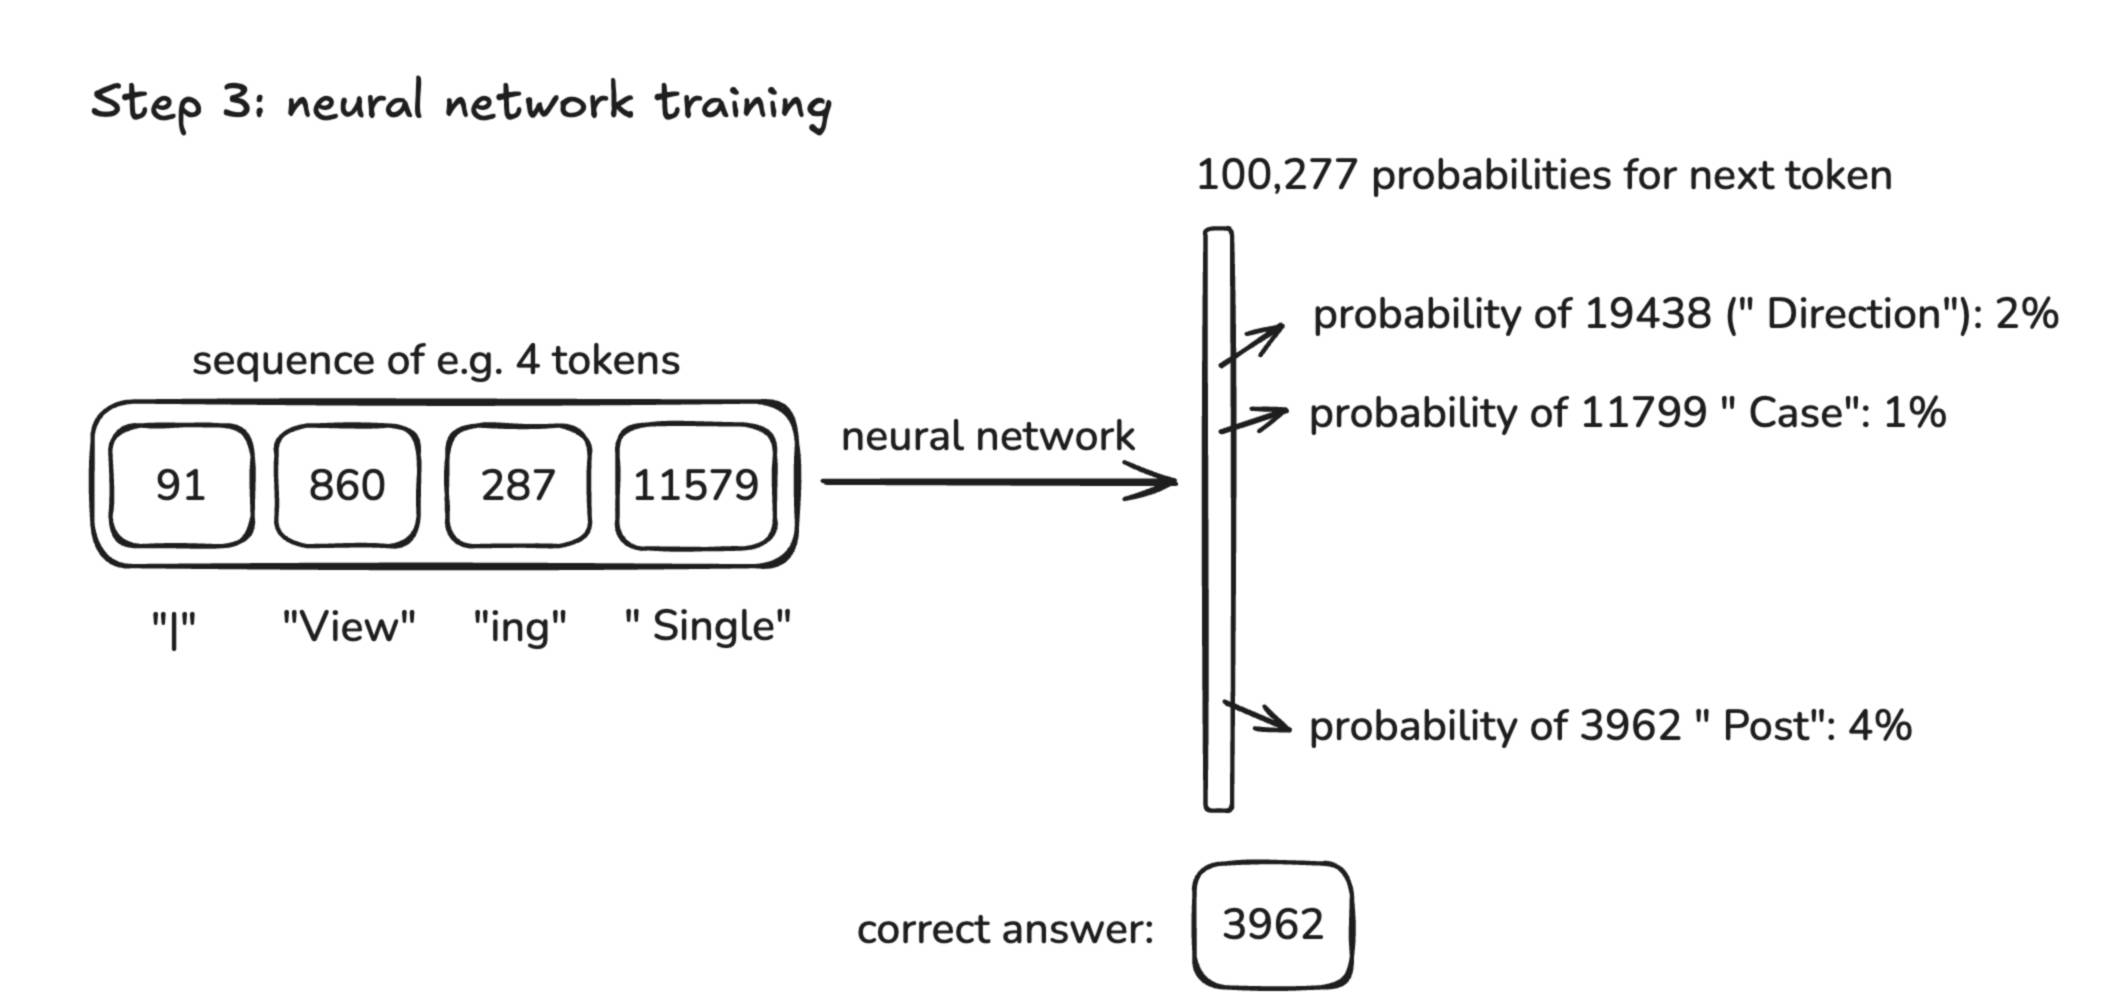
分为三阶段:1.预训练:用互联网数据训练基础模型,形成知识库;2.监督微调(SFT):用人工标注的对话数据微调,让模型学会对话;3.强化学习(RL):通过试错优化解题路径,提升推理能力,无标准答案时用RLHF加入人类偏好。
大模型为什么会产生幻觉?如何缓解?
幻觉源于大模型是概率性token补全机器,缺乏事实检索能力,只会模仿回答风格。缓解方法包括:使用工具调用联网搜索,以及在训练中增加不确定性数据,让模型学会说“不知道”。
使用大模型有哪些实用技巧?
技巧包括:联网搜索获取最新信息;深度研究生成报告;上传文件增强上下文;集成Python解释器进行精确计算;用Cursor辅助编程;语音交互;AI播客生成;图像视频生成等。注意切换话题时开启新对话窗口。
大模型的能力边界是什么?
大模型本质是1TB的压缩文件,知识有截止时间,对频繁出现的内容记忆更清晰,但答案非绝对正确。不擅长计数、拼写等细节任务,存在幻觉。上下文窗口有限,过长会分心且增加成本。
