

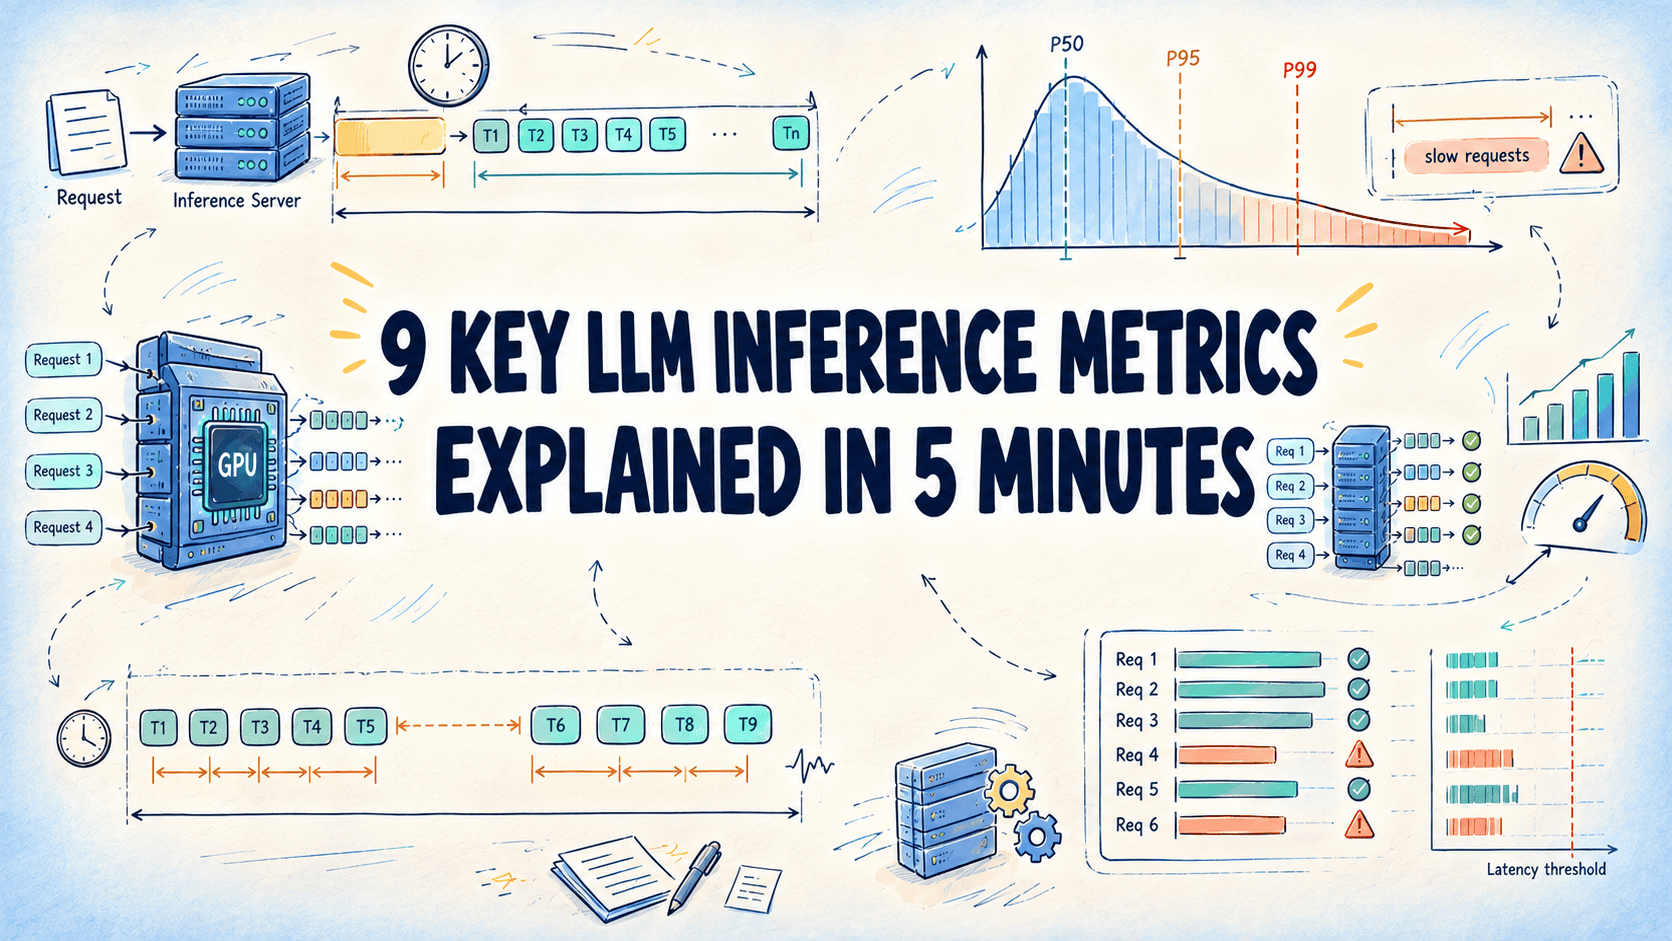

5分钟详解9项关键LLM推理指标
内容提要
本文介绍评估大模型推理性能的九项关键指标:单请求延迟包括首令牌时间(TTFT)、端到端延迟、令牌生成时间、每输出令牌时间(TPOT)和令牌间延迟(ITL);跨请求延迟用均值、中位数和P99等尾部百分位衡量;服务器负载用每秒请求数(RPS)和每秒令牌数(TPS);服务质量用goodput,即满足延迟SLO的成功请求速率。文章给出各指标公式,并提醒比较工具时需确认定义,百分位应基于原始样本合并计算。
延伸解读
吞吐量高不等于体验好
文章开篇指出,高令牌吞吐量并不必然带来快速用户体验:首令牌可能迟迟不到,后续令牌也可能流式缓慢,尤其在并发负载下。因此仅看吞吐量会掩盖延迟差异。读者应把TTFT、TPOT等延迟指标与RPS、TPS等负载指标结合使用,才能定位瓶颈。
TPOT与ITL:定义差异影响比较
TPOT是首令牌后平均每令牌间隔,ITL是相邻令牌间隔。单请求内ITL均值等于TPOT,但跨请求平均时权重不同:ITL按间隔计数,长请求主导;TPOT按请求计数,长短请求等权。文章提醒,部分工具将ITL作为TPOT别名或把TTFT计入平均,跨工具比较前务必确认定义。
百分位合并:不能平均各服务器的P99
文章强调,计算P99等尾部百分位应基于所有服务器的原始样本合并后排序,而不是对各服务器P99取平均。因为平均P99不等于合并流量的P99,后者才能反映真实尾部延迟。评估多实例部署时,应收集原始请求延迟数据统一计算。
Goodput:用SLO过滤后的有效吞吐
Goodput统计满足所有延迟SLO(如TTFT、TPOT、E2E上限)的成功请求速率,因此不会超过RPS,两者差距即未达标请求比例。文章还指出,DistServe论文用该词表示GPU在延迟约束下能维持的最大请求率,属容量含义。引用时需区分是速率还是容量。
Q&A
LLM推理中TTFT和TPOT分别衡量什么?
TTFT(首令牌时间)衡量从发送请求到收到第一个输出令牌的延迟,包括网络传输、排队和提示处理时间;TPOT(每输出令牌时间)衡量第一个令牌之后平均每个令牌的生成时间,即(E2E - TTFT) / (N_out - 1)。
为什么高吞吐量不代表好的用户体验?
因为吞吐量只反映整体处理能力,无法体现单个请求的延迟细节。例如首令牌可能等待过久,或后续令牌流式传输太慢,尤其在并发负载下,这些差异会被吞吐量掩盖。
评估LLM推理延迟时,为什么需要看P99而不仅是平均值?
平均值受异常值影响,中位数(P50)反映典型用户体验,而P99等尾部百分位能揭示最慢请求的延迟情况,帮助发现长尾问题。三者应分别应用于TTFT、TPOT和E2E。
计算跨服务器的P99延迟时需要注意什么?
必须基于所有服务器的原始样本合并计算,不能对各服务器的P99值取平均,因为平均后的P99不是合并流量的真实P99。
RPS和TPS有什么区别?各自适用什么场景?
RPS是每秒完成的请求数,忽略每个请求的工作量,仅适用于提示和输出长度混合相同的比较;TPS是每秒处理的令牌数,分为输出TPS和输入TPS,能更细粒度反映服务器吞吐,但需说明使用的是哪种形式。
Goodput是什么?它和RPS有什么关系?
Goodput是满足所有延迟SLO(如TTFT、TPOT、E2E上限)的成功请求速率。它永远不会超过RPS,两者之差就是未能满足至少一个目标的请求速率。
ITL和TPOT在单请求和多请求平均时有何不同?
单请求中,ITL的均值等于TPOT。多请求平均时,平均ITL对每个令牌间隔等权,长请求影响更大;平均TPOT对每个请求等权,长短请求权重相同。ITL还保留每个间隔,能暴露流式传输中的卡顿。
