
玩转 Gemma 2,模型的部署与 Fine-Tuning
内容提要
Google发布了开放模型Gemma 2,提供9B和27B两种参数规模的选择,支持8192 tokens的上下文长度。用户可以在Hugging Face和Kaggle上免费获取模型权重,并通过多种主流框架进行模型部署。Gemma 2还支持模型的fine-tuning,与主流训练框架完全兼容。Google Cloud提供高级解决方案,帮助用户大规模、自动化地训练开放模型。
延伸解读
部署方式选择:本地与云端
文章建议先将模型下载到本地或云端共享存储,再部署到推理框架,以避免每次从公网下载,提升加载和扩展效率。部署方案包括本地或Colab用于个人体验,GKE或第三方Kubernetes用于生产集成,以及Vertex AI全托管部署。读者应根据用途和资源调度需求选择合适方案。
微调方法对比:全参数与LoRA/QLoRA
全参数微调需重新训练所有参数,计算和存储成本高;LoRA通过训练低秩矩阵提升效率,QLoRA进一步量化优化存储。文章指出,LoRA和QLoRA在特定场景下成本低效果好,但复杂或领域数据丰富的场景仍需全参数微调。选择时需权衡效果与资源。
训练配置与资源优化
演示中使用8卡分布式训练,每卡batch size设为1,梯度累积为4,全局batch size为32。开启gradient checkpointing节省激活值内存,采用bf16混合精度。这些设置针对全参数微调显存占用大的问题,读者可参考以平衡训练效率与资源限制。
训练效果与生态兼容性
微调后模型对话更流畅自然,表明Gemma 2能有效学习数据集的对话风格。文章强调Gemma 2与Hugging Face Transformers等主流框架完全兼容,熟悉其他模型微调的开发者可快速迁移。但需注意不同模型的chat模板可能不同,需提前处理tokenizer。
Q&A
Gemma 2模型有哪些参数规模可供选择?
Gemma 2模型提供9B和27B两种参数规模的选择。
如何获取Gemma 2模型的权重?
用户可以在Hugging Face和Kaggle上免费获取Gemma 2模型的权重。
Gemma 2支持哪些主流框架进行模型部署?
Gemma 2支持Hugging Face Transformers、Keras NLP、Pytorch等多种主流框架进行模型部署。
Gemma 2的fine-tuning方式有哪些?
Gemma 2的fine-tuning方式包括全参数微调、Lora微调和QLora微调。
如何在Google Cloud上进行Gemma 2的模型训练?
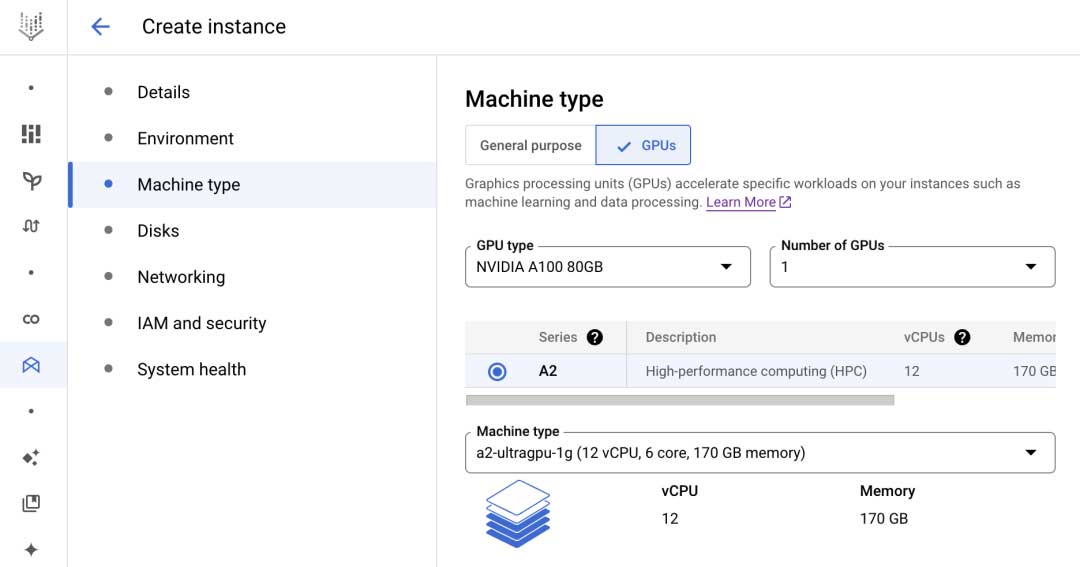
用户可以通过Vertex AI Workbench创建实例,使用Hugging Face SFTTrainer和Deepspeed框架进行Gemma 2的模型训练。
Gemma 2的上下文长度是多少?
Gemma 2支持8192 tokens的上下文长度。
