

给 Agent 造一座记忆塔(二):我去测了它,错了两次
内容提要
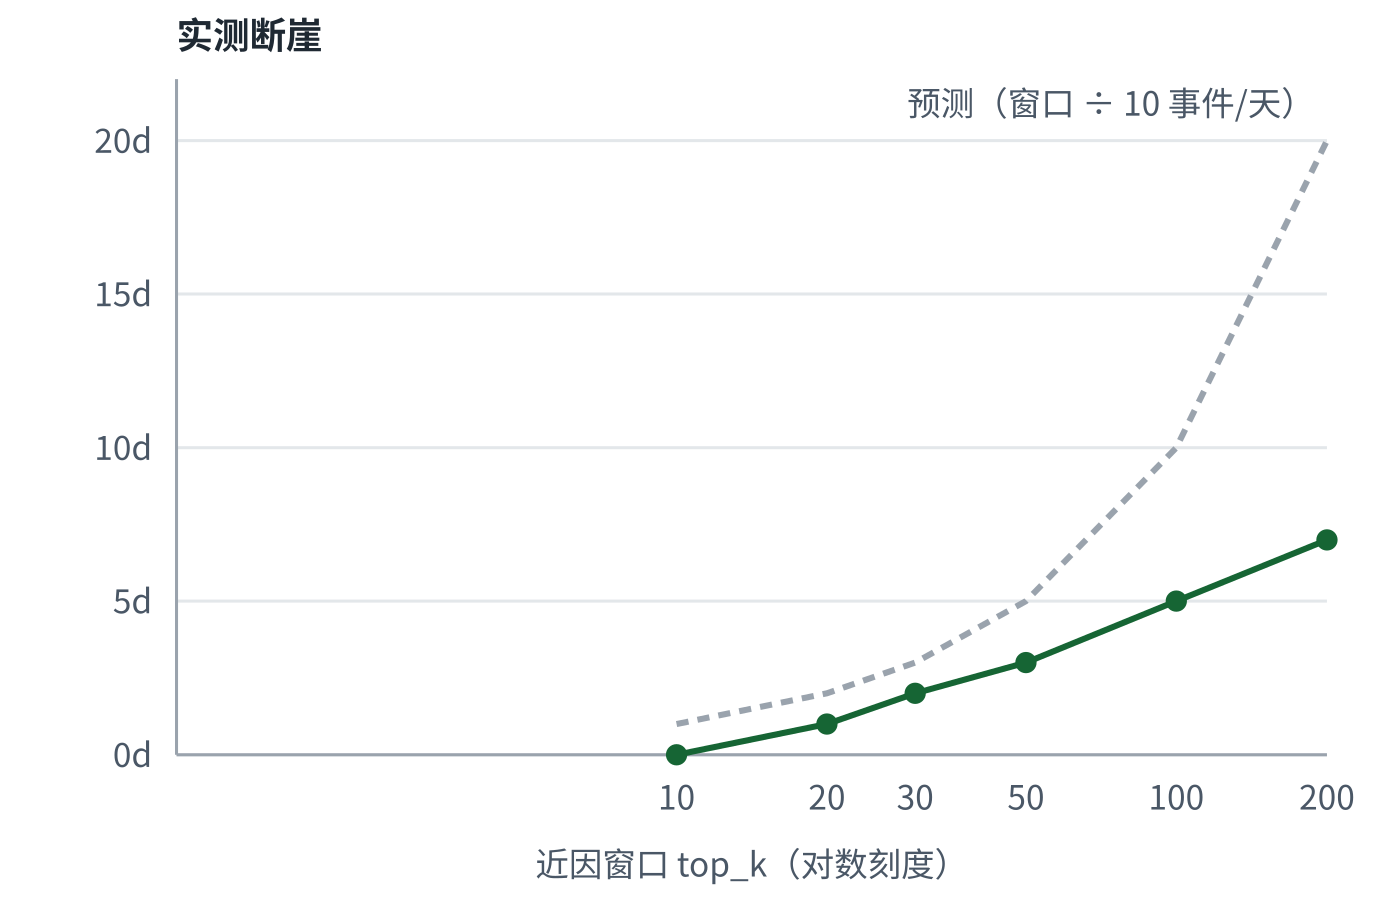
忆时塔分层记忆实测显示:精确回想实现全程100%召回;近因基线仅滞后一天便断崖归零;一次性压缩因转述拆散条目与取值对应关系而全部出错。递归总结的保真度取决于输入多样度,单输入实为复述而非压缩。真实语料中,量化证据与因果机制最先丢失,专有名词存活最久。作者两次测量方法出错,强调须警惕长度假象与抽取歧义。
延伸解读
测量方法错误如何反转结论
作者在评估中两次因测量方法错误得出误导性结论。第一次是长度假象:比较整天摘要与整周摘要时,因目标文本更长,token 更易巧合出现,导致粗层保留率虚高,甚至出现粗层比细层更保真的矛盾结果。第二次是抽取歧义:摘要将多个事实压缩进一句,读取器取首个选项会返回错误答案,使分层后端失分。这些错误提醒我们,评估记忆系统时需警惕文本长度和抽取逻辑带来的偏差。
递归总结的保真度取决于输入多样度
实验显示,递归总结的保真度与输入多样度紧密相关。当输入只有单天摘要时,周摘要几乎逐字复述,保留率高达90%,但这并非压缩无损,而是没有发生压缩。随着输入天数增加,保留率显著下降,如合并4天时数量保留仅21%。因此,评估递归总结器必须按输入多样度分层,否则会将复述误报为成功压缩。
真实语料中信息丢失的规律
在真实部署语料上,量化证据与因果机制最先在摘要中丢失,而专有名词和标识符存活最久。例如,具体数字如244个文件、284 MiB在周摘要中消失,只留下模糊表述;机制描述如“排序比较器”退化为“排序”一词。但充当状态或验收口径的数字常能存活。这一规律提示,依赖摘要进行决策时,需注意关键证据可能已被压缩丢弃。
LLM判定者的局限性
作者使用LLM判定者评估事实存活情况,但核验发现其主张常被推翻,且错误方向一致:夸大缺失。例如,判定者称某天摘要完全略去某组,实际该组完整存在。判定者只能看到摘要形态,无法察觉原始信息,因此其计数不可直接引用。这警示我们,在记忆系统评估中,机械重测比模型判断更可靠,模型判断仅可作方向参考。
Q&A
忆时塔的精确回想和语义回想在实测中召回率表现如何?
精确回想全程保持100%召回,且跨seed零方差;语义回想(天级摘要)整体召回53.1%,周级摘要18.8%,且不随滞后单调下降。
为什么近因基线的召回率会断崖式归零?
近因窗口只保留最近20条记录,当事实滞后超过窗口容量(约2天)时,信息完全不在目标文本中,导致召回率从100%直接跌至0%,这是结构性失效而非逐渐遗忘。
一次性压缩为什么会导致信息全部丢失?
破坏性压缩在转述时拆散了条目与取值的对应关系,导致所有档位召回率为0%;而保守压缩保留引用号与取值配对,召回率100%。100分差距仅由每问11个token的对应关系造成。
递归总结的保真度受什么因素影响?
保真度取决于输入多样度:单输入时周摘要与天摘要逐字节相同(相似度1.0000),实为复述而非压缩;输入天数越多,数量保留率越低(1天90%,≥2天58%),长度比从0.94x降至0.53x。
在真实语料中,哪些信息最先丢失?哪些存活最久?
量化证据与因果机制最先丢失,专有名词与标识符存活最久。例如具体数字(244→101文件)和机制描述(排序比较器)在粗层摘要中消失,而标识符如pkgLabel、@version保留较多。
作者在测量中犯了哪两个错误?如何避免?
错误一:长度假象,比较不同长度文本导致粗层保留率虚高,需限制到同一项目同一窗口;错误二:抽取歧义,摘要中多事实混写导致读取器取错答案,需使用不透明引用号并位置感知读取。
