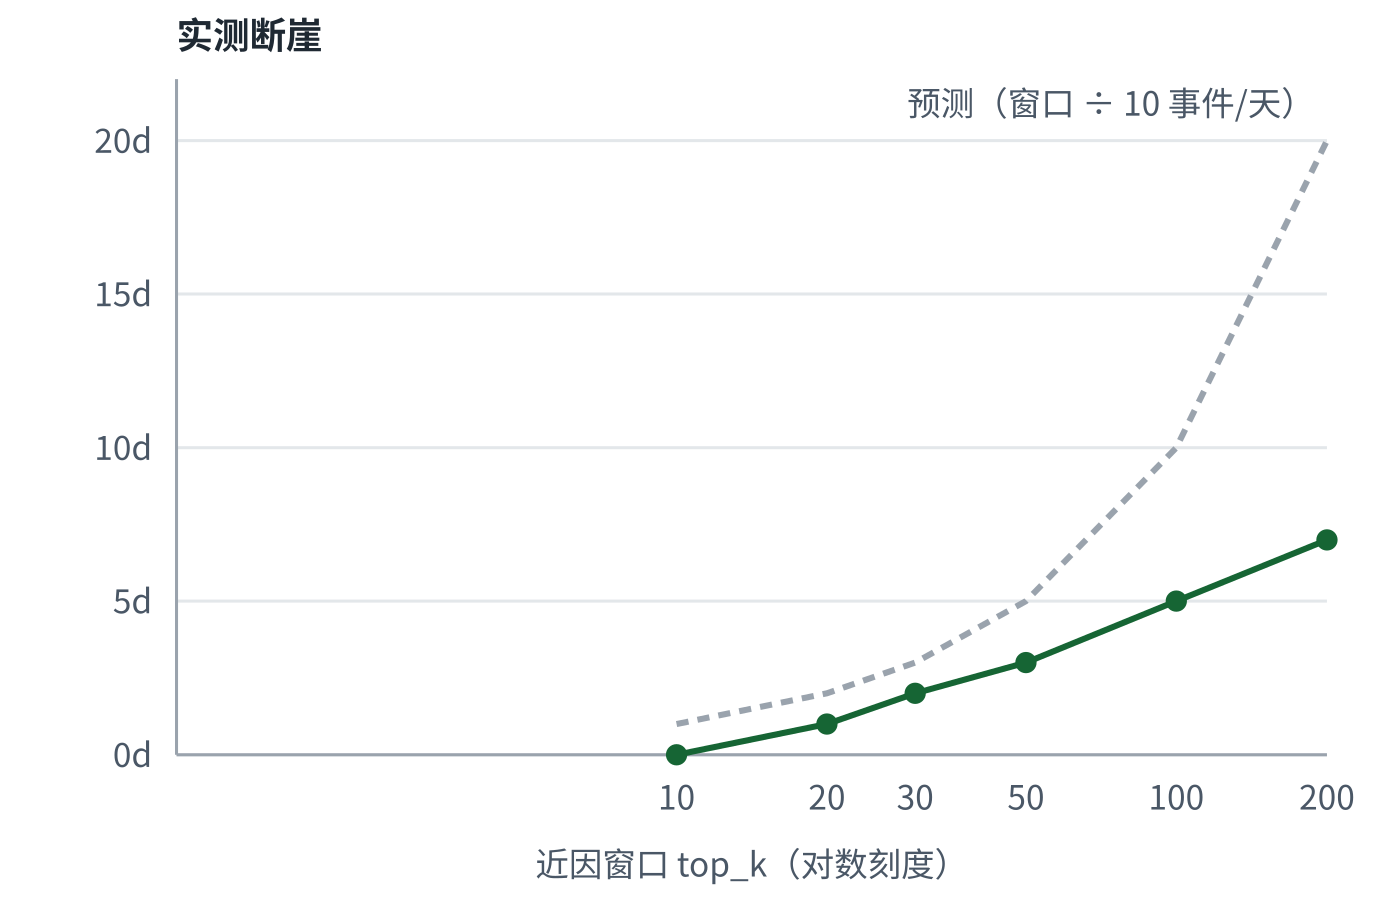
忆时塔分层记忆实测显示:精确回想实现全程100%召回;近因基线仅滞后一天便断崖归零;一次性压缩因转述拆散条目与取值对应关系而全部出错。递归总结的保真度取决于输入多样度,单输入实为复述而非压缩。真实语料中,量化证据与因果机制最先丢失,专有名词存活最久。作者两次测量方法出错,强调须警惕长度假象与抽取歧义。
Amazon S3 Vectors 新增元数据预筛选功能,在相似度搜索前先按元数据过滤,提升筛选查询召回率,高选择性场景下匹配量可达原先5倍。支持 $startsWith 前缀匹配,每向量2KB元数据,单查询最多100个约束,无额外费用且无需重新摄取。适用于法律、金融、媒体及智能体等场景,现有索引可通过 UpdateIndexMode 启用。
搜索效果差时,不应只升级重排序模型。大规模重排序成本高、延迟大,且候选池本身没有好结果时重排序也无能为力。更优方案是将检索设计为多阶段漏斗:先用低成本词法、向量或混合检索生成大量候选,再逐步收窄,最后才用机器学习重排序。该思路同样适用于RAG,需权衡召回率、相关性、延迟与成本。
本文介绍Elasticsearch的基本概念与指标:近实时搜索延迟约1秒;集群由多节点组成,统一进行索引和搜索;节点是集群中的服务器;索引是相同特性文档的集合;文档是最小索引单元,以JSON表示;分片用于突破单机存储限制,副本保障可用性;fielddata用于文本字段内存查询;doc values支持高效聚合;norms存储评分因子;召回率衡量查全,准确率衡量查准。
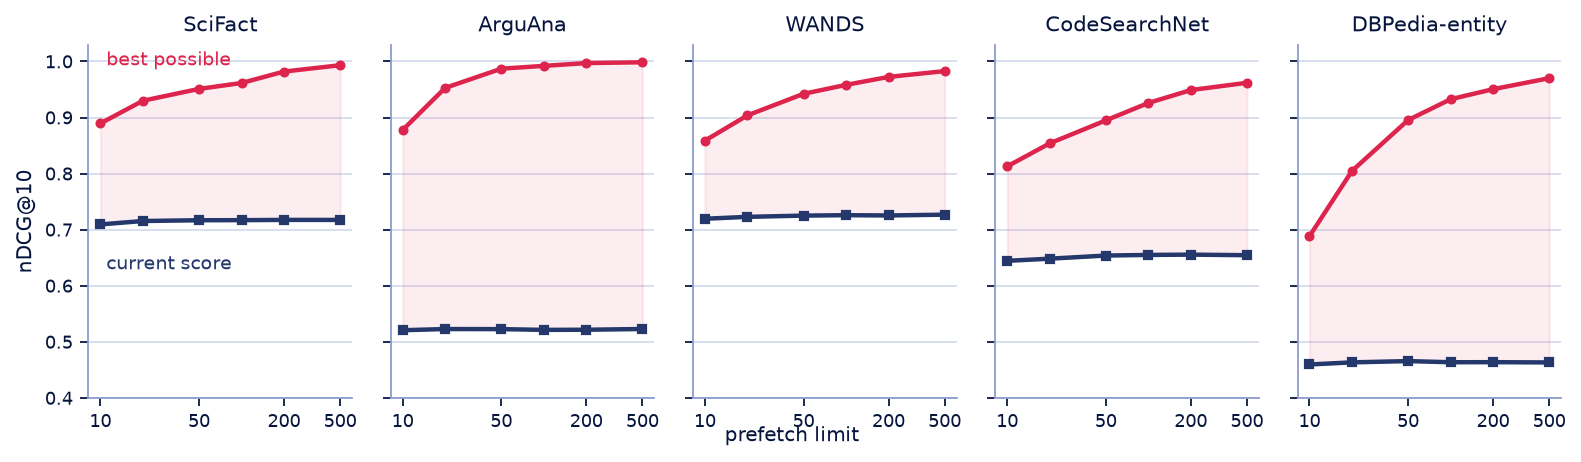
本文讨论检索系统中候选深度(candidate depth)的调优方法。建议先设置基线,测试100-200的limit值,并对比近似搜索与精确搜索的召回率。增加候选可提升最佳可能分数,但需权衡延迟。当RAM受限时,优先考虑量化而非降低深度。hnsw_ef仅在召回率未饱和时调整。最后根据最佳可能分数与当前分数的差距,决定优化排序或检索。
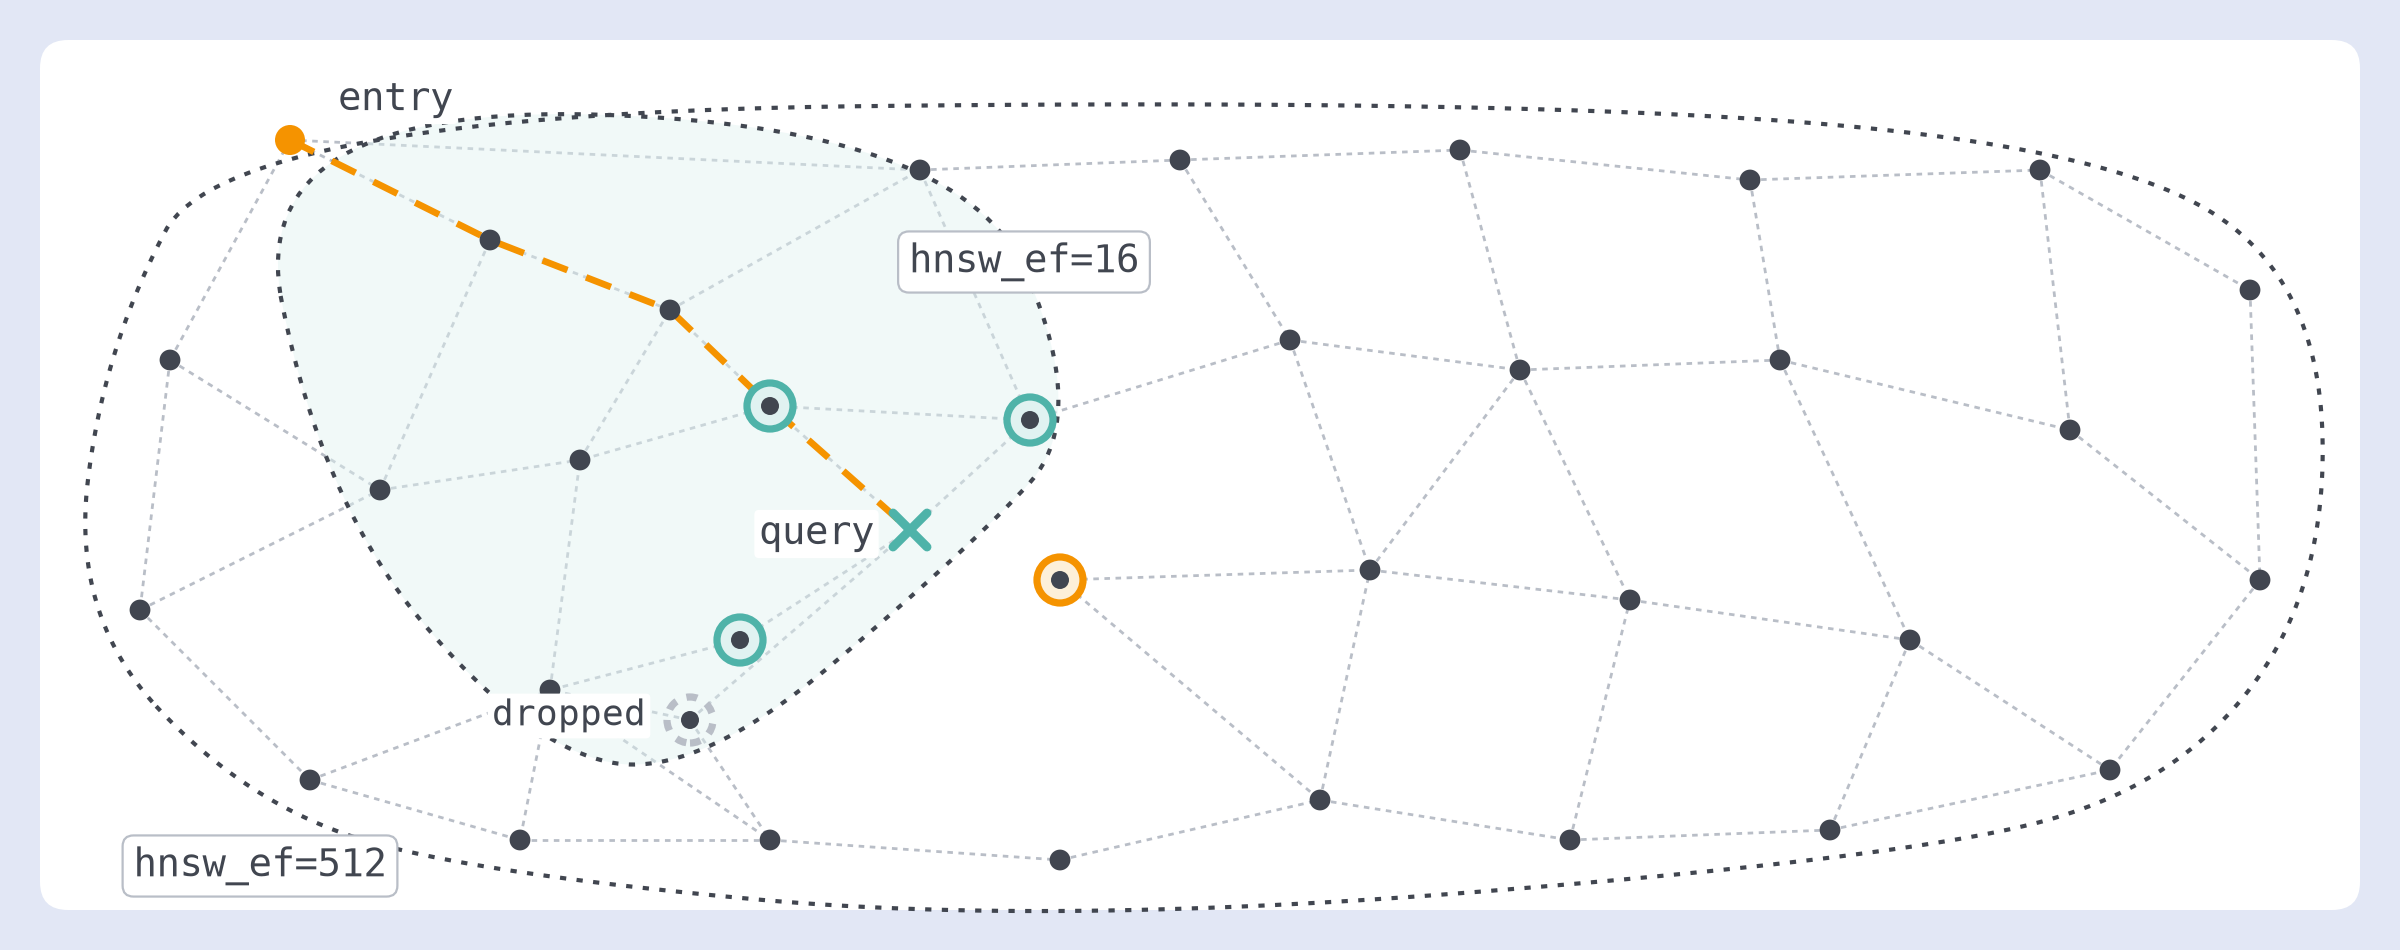
候选深度是检索阶段传给后续排序的候选数,仅当后续阶段能利用额外候选时才有意义。建议初始测试100至200,但需按自身数据验证。提高hnsw_ef仅在召回率仍上升时有效,否则只增延迟。内存受限时优先测试量化,而非降低候选深度。
AI长期运行后记忆衰退,OpenAI通过“梦境”机制在后台整理记忆,合并重复、取代旧事实、综合推论,使召回率从41.5%提升至82.8%。Anthropic、Google等公司跟进,核心理念是主动清理优于无限扩容。记忆管理转向主动遗忘,保留历史痕迹,但综合节奏和版本处理仍待解决。
Elasticsearch使用HNSW算法在每秒15,000个查询下实现0.99的召回率@10。通过量化技术,DiskBBQ在55,000 QPS下达到0.97的召回率,内存占用减少8倍。HNSW通过多层图结构提高查询效率,适合高维数据的近似最近邻搜索。量化方法如标量量化和产品量化进一步压缩内存,提升性能。
本文梳理IVF-PQ向量检索:PQ将向量切分子空间并量化压缩,ADC用查找表估距;IVF先粗聚类缩小候选,再对残差编码。实验表明码长增加可降低MSE,但召回受量化误差限制,nprobe增大后召回进入平台。工程上需按内存、召回与候选数调参,并配合OPQ、重排等优化。
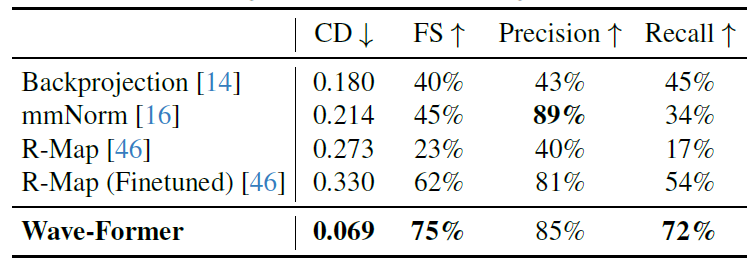
麻省理工学院研究人员提出Wave-Former方法,利用毫米波技术实现高精度三维重建,成功克服传统视觉模型的局限,召回率从54%提升至72%,精度保持在85%。研究成果已发布于arXiv。
构建体育新闻搜索系统时,处理文本与图像的相关性问题。提出了两阶段检索流程:首先使用jina-clip-v2获取候选文档,然后用jina-reranker-m0进行统一排序,从而提升检索效果,最终实现62%的召回率提升。
精确率和召回率是评估分类模型性能的关键指标。精确率衡量预测为正的项目中正确的比例,适用于垃圾邮件检测和医疗诊断;召回率衡量实际正例的识别数量,适用于疾病和欺诈检测。两者共同优化模型的准确性和覆盖率。
本研究利用基于变换器的自然语言处理系统,成功从美国法典中自动提取法定义,精确率达到96.8%,召回率为98.9%。该技术显著提升了法律信息的可及性和理解力。
评估AI应用的准确性指标,如精确度、召回率和F1分数,是理解模型表现的关键。通过使用标记数据集进行测试,可以优化API提取器的性能,并平衡精确度与召回率,以减少错误标记和漏标真实端点。
本研究提出了WebLists基准,涵盖200个数据提取任务,展示了现有大型语言模型和网页代理的局限性。通过BardeenAgent框架,实现了66%的召回率,显著提升了网页数据提取的效率和准确性。
Elasticsearch 9.0和8.18版本发布,提供更快的BBQ(更好的二进制量化),速度比OpenSearch快5倍。新算法提升了召回率和吞吐量,支持多种语义搜索模型,简化API,改善开发者体验。
MicroNN是一种在低资源环境中进行设备端向量搜索的数据库,支持实时更新和混合搜索查询。它在受限内存下高效运行,能在7毫秒内检索前100个最近邻,召回率达到90%。
Llama-4在长上下文处理上表现不佳,召回率低于60%。Fiction.LiveBench测试显示其在理解复杂关系和逻辑预测方面存在困难。RAG(检索增强生成)因精准性和实时性成为更优选择。未来结合大模型与RAG的优势,将更有效解决业务问题。
垃圾信息在现代通信中持续存在。本文利用SMS垃圾信息数据集,通过数据挖掘技术分析和预测垃圾信息模式。采用逻辑回归进行分类,K均值聚类探索数据结构。结果显示,逻辑回归的准确率为89%,但召回率较低,表明模型在识别垃圾信息时存在漏检。未来可通过集成方法和深度学习提高召回率。
北京大学彭宇新教授团队研究了多轮组合图像检索,提出FashionMT数据集和MAI模型,解决了历史上下文缺失和数据规模限制的问题。实验结果显示,MAI在FashionMT基准上的召回率提升了8%,有效优化了多模态检索性能。
完成下面两步后,将自动完成登录并继续当前操作。