

用 RAGAs(检索增强生成评估)评估 RAG(检索增强型生成)应用 [译]
内容提要
RAGAs是评估检索增强生成(RAG)应用的框架,可从检索器和生成器两个组件层面量化评估性能。其核心指标包括上下文精准度、上下文召回率、真实性和答案相关度,评分范围0到1。RAGAs利用大语言模型进行无参考评估,降低人工标注成本,仅上下文召回率需标准答案。文章演示了搭建基础RAG流程并用RAGAs评估的完整步骤,帮助定位改进方向。
延伸解读
组件级评估:定位问题的关键
RAGAs 将评估拆分为检索器和生成器两个组件,分别用上下文精准度、上下文召回率评估检索质量,用真实性和答案相关度评估生成质量。这种拆分让开发者能明确问题出在检索还是生成环节。例如,若上下文召回率低,说明检索器漏掉了关键信息;若真实性低,则生成器可能产生了与上下文不符的内容。组件级评估避免了整体评分掩盖局部缺陷,为针对性优化提供依据。
无参考评估的代价与局限
RAGAs 主要依赖大语言模型进行无参考评估,仅上下文召回率需要人工标注的标准答案。这大幅降低了评估成本,但文章也指出,这种方法的偏差问题引发讨论。由于评估本身由 LLM 完成,其判断可能受模型自身知识或偏见影响,导致评分不完全可靠。因此,在实际应用中,无参考指标适合快速迭代和趋势监控,但对关键决策仍需结合人工审核或标准答案验证。
从评分到行动:指标的实际解读
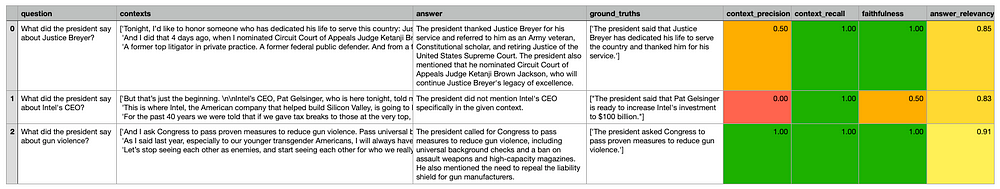
文章示例中,第二个问题的上下文精准度较低,提示检索到的多数上下文不相关,可尝试减少检索数量以降低噪声;同时该问题的真实性评分仅为 0.5,说明生成答案与上下文事实不符。这些具体分数直接指向可操作的调优方向,如调整检索策略或优化提示模板。RAGAs 的价值不仅在于给出分数,更在于将分数转化为改进线索,帮助开发者形成“评估-调整-再评估”的闭环。
Q&A
RAGAs 是什么?它主要用来做什么?
RAGAs(检索增强生成评估)是一个用于评估检索增强生成(RAG)流程性能的框架。它提供必要的工具,帮助在组件层面(检索器和生成器)对 RAG 流程进行量化评估,以定位改进方向。
RAGAs 评估需要准备哪些数据?哪些是必须的?
RAGAs 评估需要四种数据:question(用户查询)、answer(RAG 生成的答案)、contexts(检索到的相关上下文)和 ground_truths(标准答案)。其中 ground_truths 是唯一需要人工标注的信息,且仅在评估 context_recall 指标时才必须;如果不关注该指标,则只需准备 question 即可。
RAGAs 的四个核心评估指标分别是什么?各衡量什么?
四个核心指标是:上下文精准度(衡量检索上下文中相关信息的比例)、上下文召回率(评估是否检索到回答问题所需的全部相关信息)、真实性(衡量生成答案的事实准确度,基于上下文中的正确陈述比例)和答案相关度(评估生成答案与问题的关联程度)。所有指标评分范围在 0 到 1 之间,分数越高表示性能越好。
RAGAs 如何降低评估成本?它依赖人工标注吗?
RAGAs 最初设计为无参考评估框架,利用大语言模型(LLM)进行评估,无需人工标注的标准答案,从而降低人工标注成本。但框架后续扩展了需要真实标签的指标(如 context_recall 和 answer_correctness),其中 context_recall 需要 ground_truths。总体而言,RAGAs 仅需少量人工数据,成本低、效率高。
如何使用 RAGAs 评估一个基础的 RAG 流程?请简述步骤。
步骤包括:1)安装所需 Python 包(langchain、openai、weaviate-client、ragas)并设置 OpenAI API 密钥;2)搭建基础 RAG 流程(加载文档、分块、生成嵌入、存储向量数据库、定义检索器和提示模板、整合 LLM);3)准备评估数据(question 和 ground_truths 配对,通过推理得到 answer 和 contexts,转换为 Dataset);4)从 ragas.metrics 导入指标,使用 evaluate() 函数传入数据集和指标(如 context_precision、context_recall、faithfulness、answer_relevancy)进行评估,结果可转为 Pandas DataFrame 查看。
RAGAs 评估结果中的 context_relevancy 和 faithfulness 分数如何帮助改进 RAG 应用?
context_relevancy 反映检索上下文的相关性与噪声比,若分数低(如第二个问题检索到大量不相关上下文),可尝试调整检索上下文的数量以降低噪声。faithfulness 衡量生成答案的事实准确性,若分数低(如第二个问题答案错误声称总统未提到英特尔 CEO,得分为 0.5),可针对生成器进行优化。这些指标帮助定位问题组件并指导调优。
