行组控制、更快的 S3 读取、页脚缓存:Hardwood 1.1.0.Beta2 发布
内容提要
Hardwood 1.1.0.Beta2 发布,该开源库用于读写 Apache Parquet 文件。新版增强写入器,支持显式控制行组边界、跳过坏记录、列与偏移索引及布隆过滤器;读取器大幅提速,优化 S3 远程读取、查询执行和字典编码访问;新增页脚缓存 API 和按字典 ID 访问。共解决 165 个问题。
延伸解读
写入器控制增强:行组边界与容错
Hardwood 1.1.0.Beta2 允许通过 endRowGroup() 显式控制行组边界,例如按月份划分事件数据,使查询特定月份时只读取对应行组,避免混合。同时,tryWriteRow() 可跳过不符合模式的记录(如 REQUIRED 字段为 null),返回 Rejected 而不中断写入,close() 仍会发布已接受的记录。若写入抛出异常,close() 会丢弃输出,abort() 可主动放弃。这些改进提升了写入的灵活性和容错性。
读取性能优化:S3 与查询执行
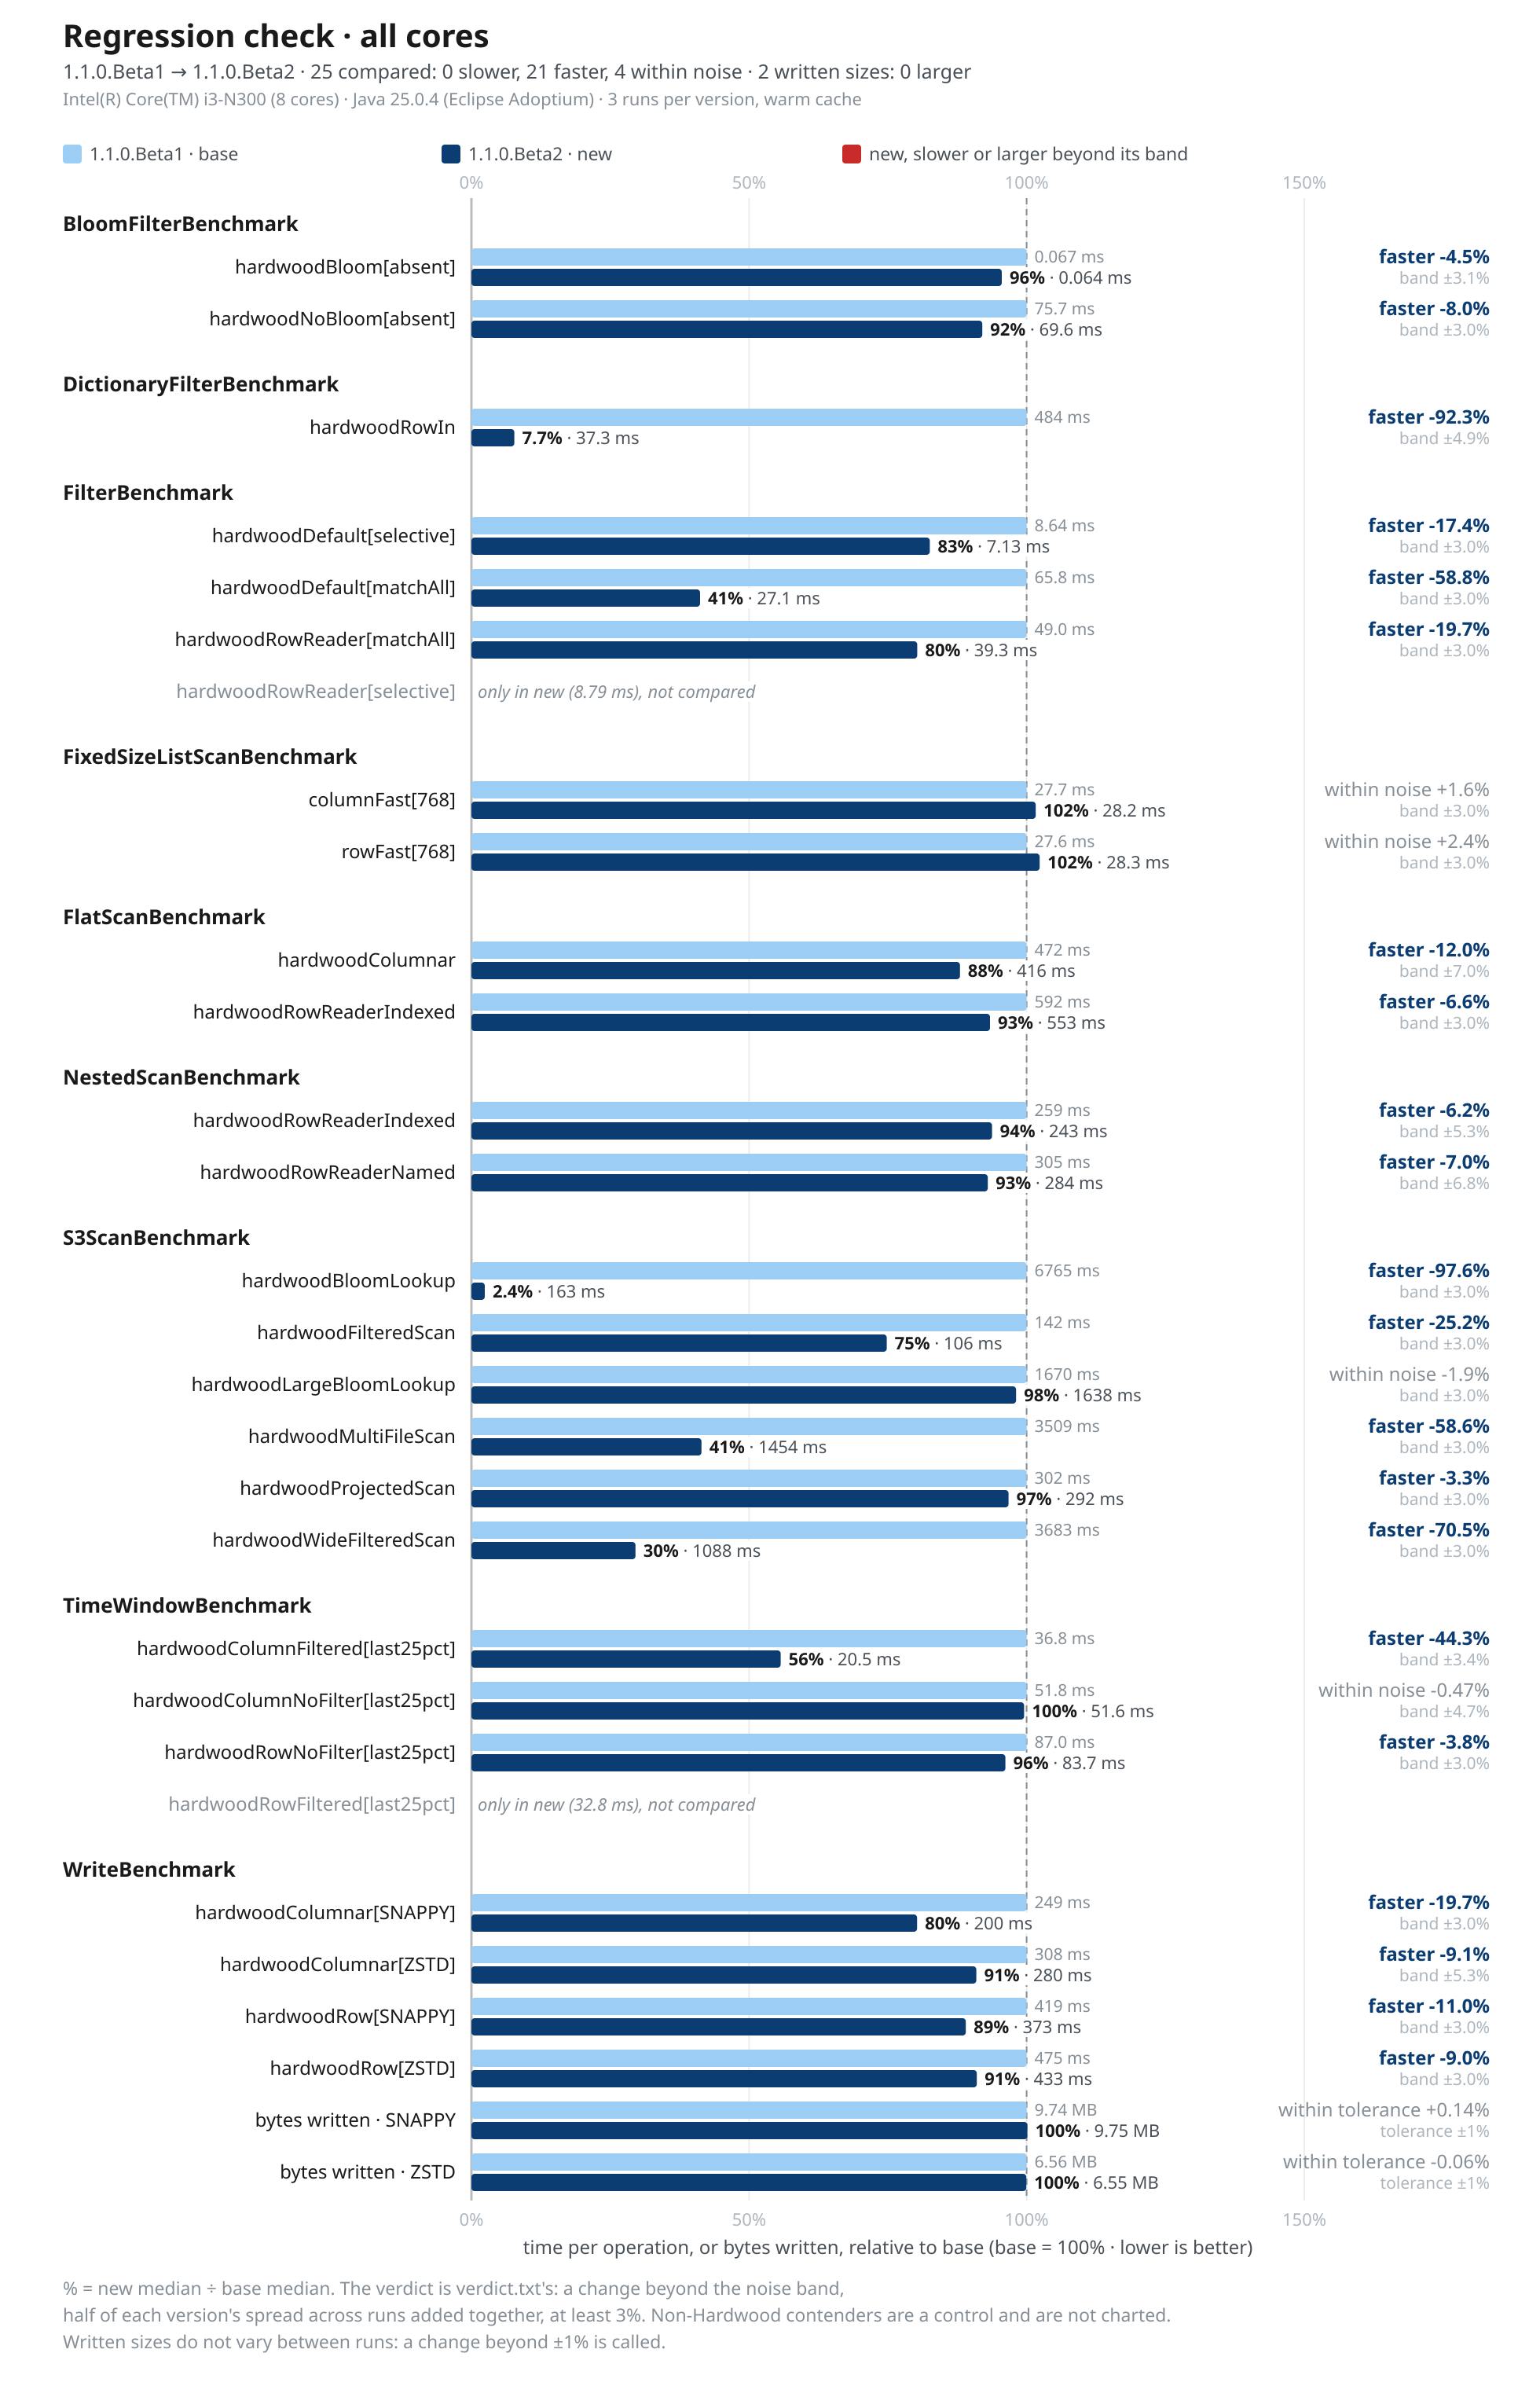
针对远程对象存储(如 S3),读取器通过合并请求加载布隆过滤器、仅获取投影列的页索引、预取下一行组首列块、延迟打开多文件等方式,显著减少读取时间。查询执行方面,当过滤列不在投影中且行组统计证明所有行匹配时,会跳过该列;字典编码列的谓词在字典空间执行,避免逐行比较。基准测试显示 25 个场景中 21 个更快,例如 S3 上的布隆过滤器查找从 6.8 秒降至 163 毫秒。
页脚缓存与字典 ID 访问
新增 MetadataSource 扩展点,支持缓存和复用 Parquet 文件页脚,避免重复解析和 S3 请求。缓存以文件标识(如 ETag)为键,读取前会校验标识和长度,过期条目抛出 StaleMetadataException。该 API 尚属实验性。此外,字典编码的字符串/二进制列可通过 getDictionaryIds() 按 ID 访问,例如统计每个站点的测量数时,用数组按字典 ID 计数,仅对每个字典条目解析一次名称,提升处理速度。
Q&A
Hardwood 1.1.0.Beta2 是什么?它主要用来做什么?
Hardwood 1.1.0.Beta2 是一个用于读写 Apache Parquet 文件的开源库。它提供了新的写入器功能、显著的性能提升、页脚缓存 API 以及基于字典 ID 的访问等特性。
Hardwood 1.1.0.Beta2 在写入器方面有哪些新功能?
写入器新增了显式控制行组边界(通过 endRowGroup())、跳过坏记录(通过 tryWriteRow())、支持列和偏移索引以及布隆过滤器。此外,还提供了 abort() 方法用于放弃待处理的写入。
Hardwood 1.1.0.Beta2 如何提升从 S3 读取 Parquet 文件的性能?
读取器通过以下方式优化 S3 远程读取:合并请求加载多个列和行组的布隆过滤器;仅获取投影列的页索引,且一个请求覆盖多个行组;预取下一个行组的第一个列块;多文件读取时按需打开文件,避免首次结果时间随文件数增长。
Hardwood 1.1.0.Beta2 的页脚缓存 API 如何使用?
通过新的 MetadataSource 扩展点,可以自定义页脚缓存逻辑。例如,实现一个基于文件标识(如 URI 和 ETag)的内存缓存,将 MetadataSource 安装到 HardwoodContext 上,然后打开读取器时即可复用缓存的页脚。注意该 API 是实验性的,可能会变化。
Hardwood 1.1.0.Beta2 中基于字典 ID 的访问有什么优势?
对于字典编码的字符串和二进制列,可以直接通过字典 ID 访问,而不是解码每行的值。这可以避免重复解码和比较,显著提升处理速度,例如在统计每个字典项的行数时,只需在字典条目级别解析一次名称。
Hardwood 1.1.0.Beta2 解决了多少个问题?性能提升的示例有哪些?
该版本共解决了 165 个问题。性能基准测试显示,在 25 个场景中有 21 个更快,其余 4 个在噪声范围内。例如,在 S3 上进行布隆过滤器查找的时间从 6.8 秒降低到 163 毫秒。
