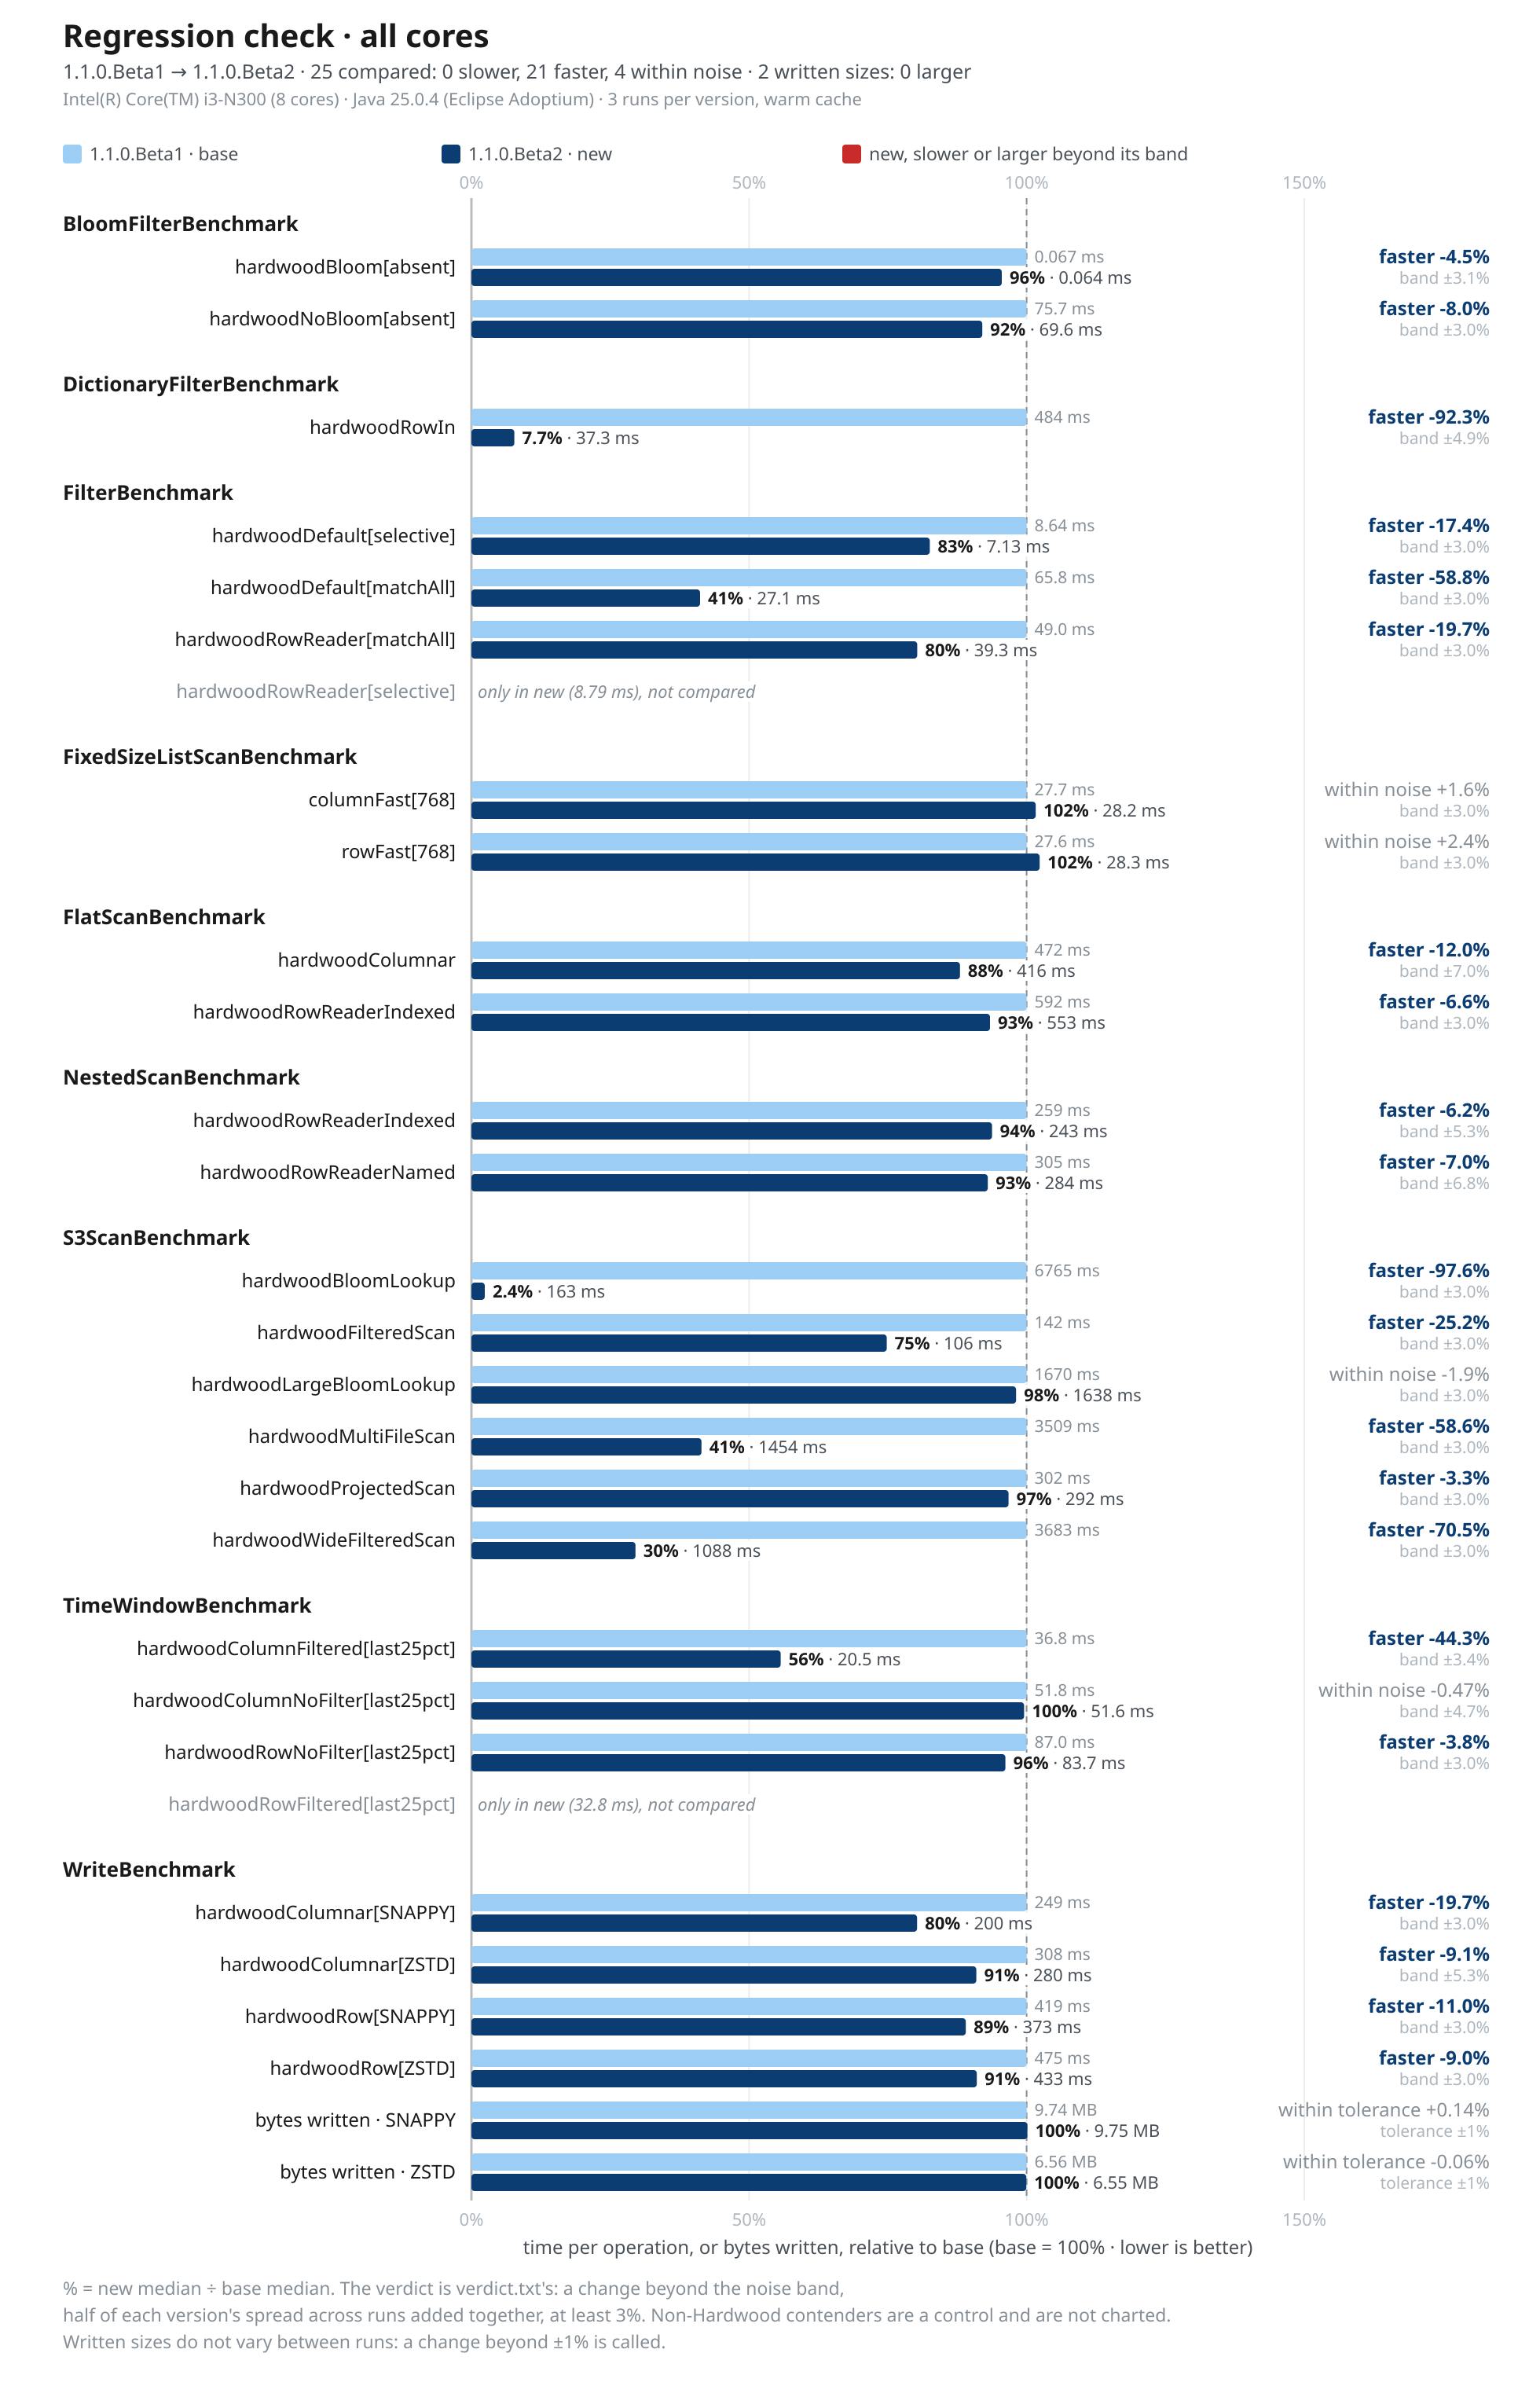
Hardwood 1.1.0.Beta2 发布,该开源库用于读写 Apache Parquet 文件。新版增强写入器,支持显式控制行组边界、跳过坏记录、列与偏移索引及布隆过滤器;读取器大幅提速,优化 S3 远程读取、查询执行和字典编码访问;新增页脚缓存 API 和按字典 ID 访问。共解决 165 个问题。
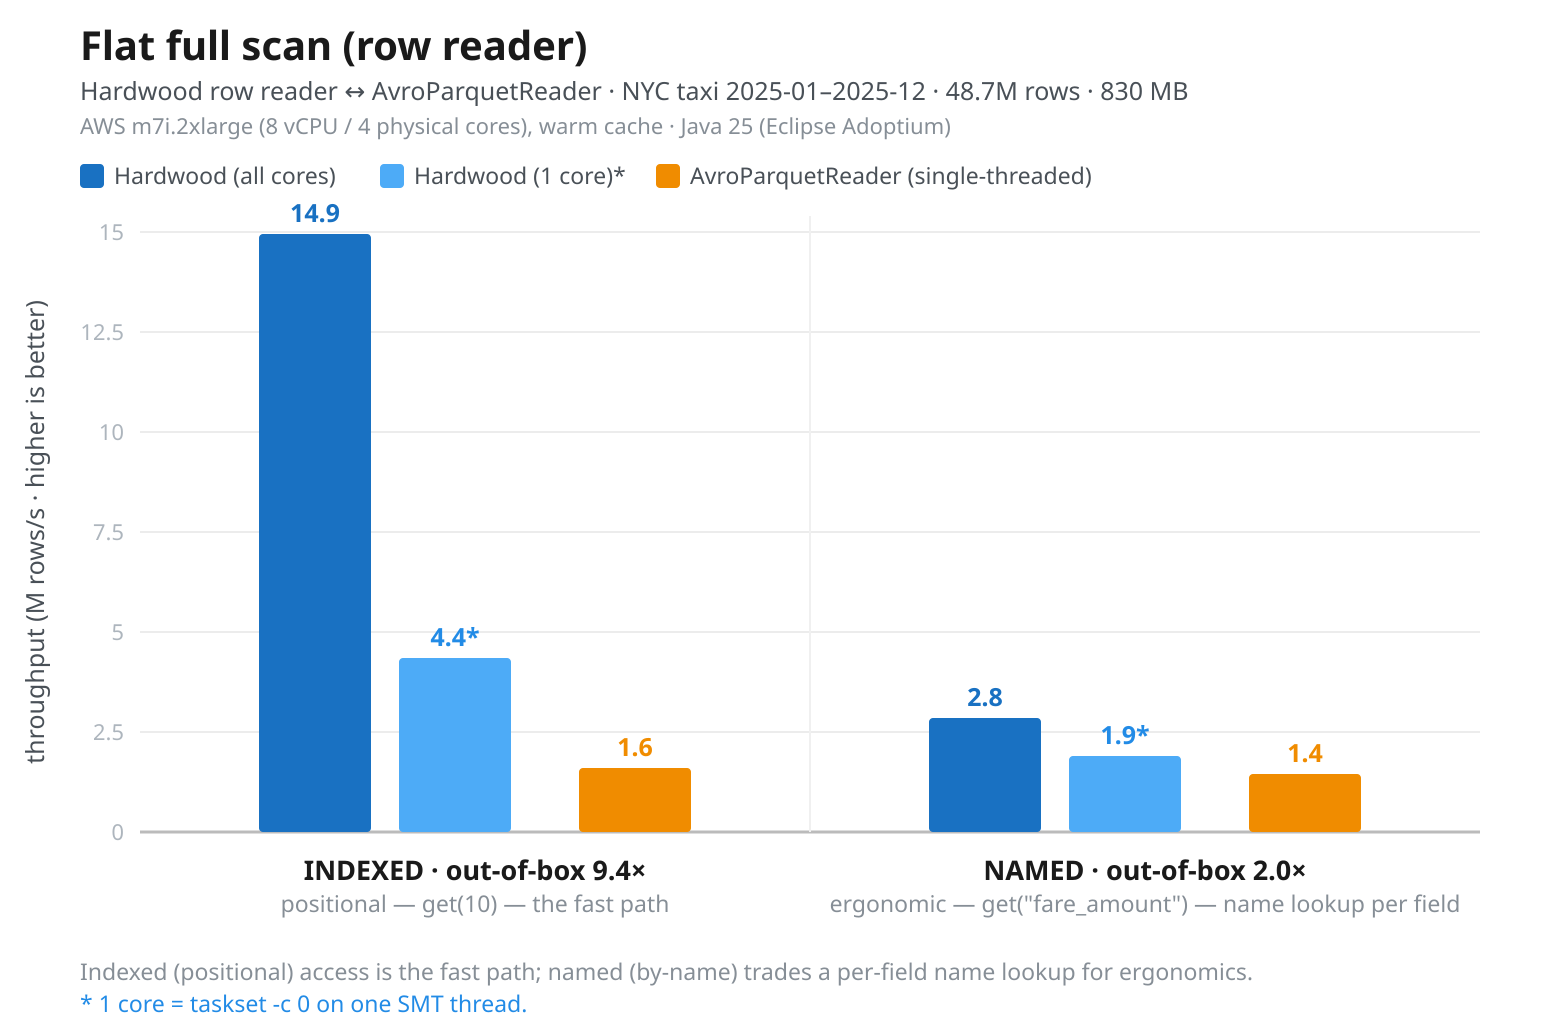
Hardwood是一个为JVM开发的新Parquet库,专注于快速读取Apache Parquet文件,支持多线程和无强制依赖。1.0版本已发布,兼容Java 21及以上,开源并可从Maven Central获取。它支持多种列类型和压缩方案,提供行读取和列读取两种API,适合不同的使用场景。未来版本将增加写入支持和性能优化。
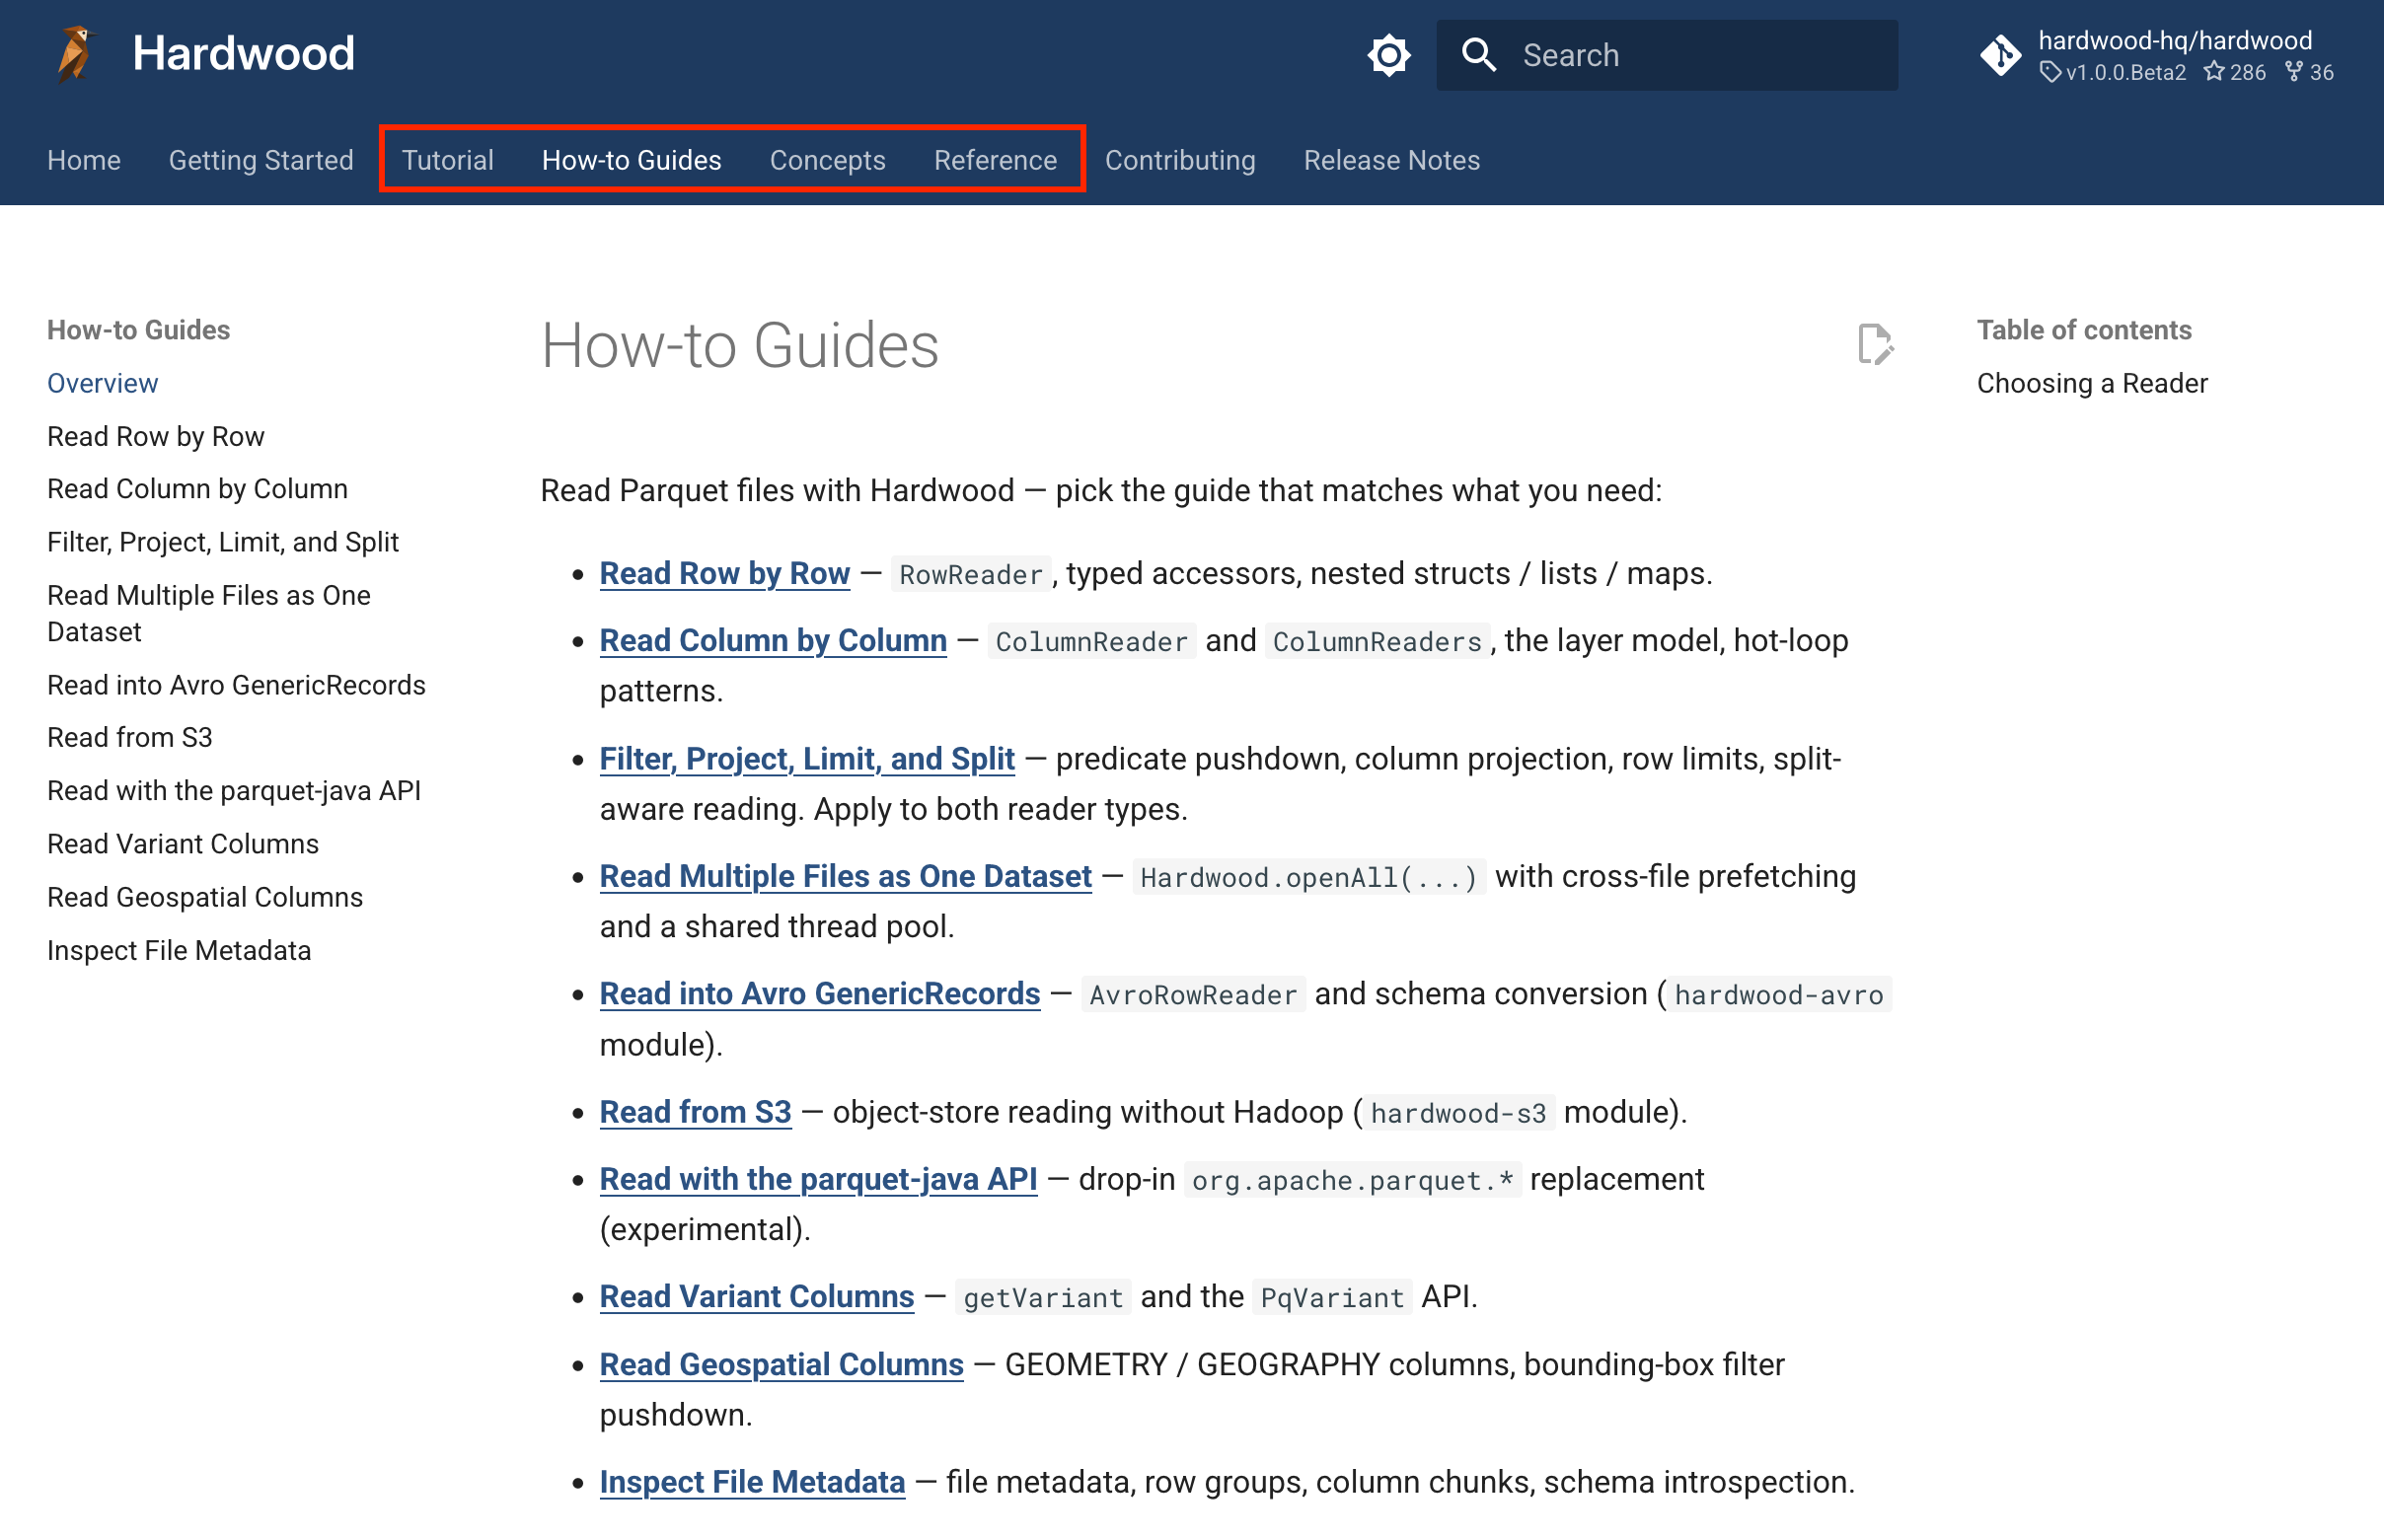
Hardwood 1.0.0.CR1发布,改进了Apache Parquet文件的列式访问API,支持GEOMETRY/GEOGRAPHY列类型。新增RowReader和ColumnReader API,优化了可选和重复列的检索。文档结构重组,便于用户学习和使用。解决了50个问题,预计1.0正式版将在一周内发布。
消费者对食品标签的期望发生了显著变化,75%的美国购物者要求全面信息,近三分之二的人更仔细查看标签。尽管监管机构在更新标签要求,领先零售商通过数据提取和分析技术提升透明度,以满足消费者需求。自动化食品标签读取帮助商家更好地支持顾客的健康需求。
使用JavaScript构建二维码生成器和读取器的方法,可以通过goqr.me的API生成指定内容和尺寸的二维码。示例代码展示了如何在HTML/JS项目中使用该API生成二维码。
IMA E-COMMERCE部门通过Cognex的In-Sight视觉系统和DataMan条码读取器,提高了订单交付效率和可持续性。基于AI的检测系统确保包装完整性,减少塑料使用,符合环保要求。双方将继续合作开发物流自动化解决方案。
Anki的笔记数据存储在collection.anki2文件中,可以用SQLite或Python的sqlite3模块连接数据库查看。文中提供了一个Python程序,通过Flask实现远程检索功能,支持导出CSV文件,并在网页上显示结果。用户需调整数据库和媒体文件路径。
在Spring Batch中,自定义读取器和写入器用于处理批处理作业中的记录输入和输出。自定义读取器负责解析数据并传递给批处理进行进一步处理,自定义写入器负责将处理后的数据写入目的地。示例场景是构建一个Spring Batch应用程序来处理来自GeeksforGeeks的文章,需要自定义阅读器和编写器来处理自定义的JSON格式和数据库存储。在Spring Batch作业配置中,需要创建自定义阅读器和编写器,并配置作业和处理步骤。最后,通过调度程序或命令行界面运行作业,并进行测试和调试。
完成下面两步后,将自动完成登录并继续当前操作。