

脑波解码:向着实时重现视觉感知迈进 [译]
内容提要
Meta与巴黎高师团队提出基于脑磁图(MEG)的视觉解码新方法,结合预训练图像嵌入、端到端训练的MEG模块和预训练图像生成模块,通过对比学习与回归训练。结果显示,MEG解码器在图像检索任务上比传统线性解码器提升7倍,前5准确率约70%,并能生成与所见图像类别一致的图像。MEG时间分辨率高,有望实现实时视觉解码,但空间分辨率低,难以还原轮廓、阴影等低级特征。
延伸解读
MEG与fMRI的取舍:时间分辨率换空间分辨率
文章指出,fMRI时间分辨率约0.5 Hz,难以用于实时场景;MEG时间分辨率高达约5000 Hz,但空间分辨率仅厘米级,传感器约300个,远低于fMRI的约10万体素。这导致MEG解码主要捕捉高级语义特征,而轮廓、阴影等低级特征难以还原。读者需注意,实时性提升是以牺牲空间细节为代价的,两者在应用上各有侧重。
检索与生成:两种解码路径的实用差异
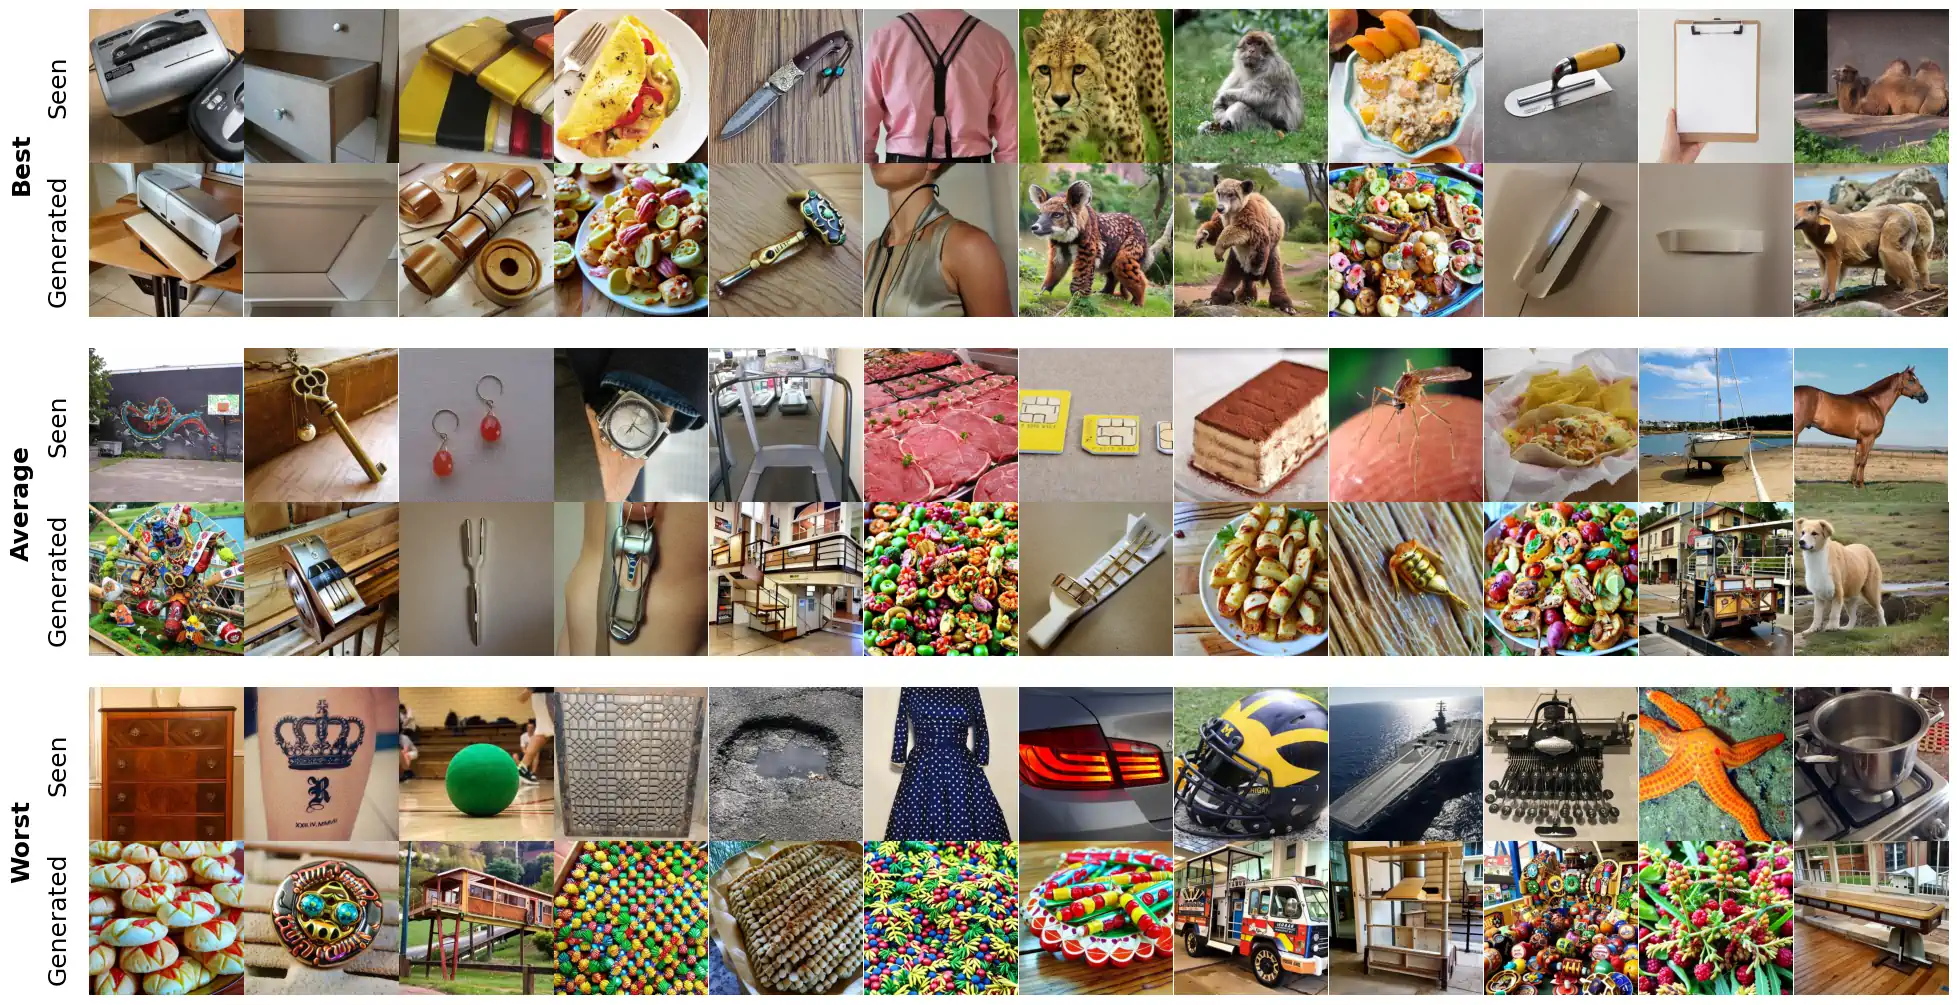
检索任务要求候选集中存在真实图像,模型从中找出匹配项;生成任务则直接根据MEG信号预测潜在表示并驱动扩散模型生成图像。检索在“小”测试集上前5准确率约70%,但在更接近真实场景的“大”测试集上降至约13%。生成图像虽类别一致,但细节不足。这表明检索指标可能高估实际解码能力,生成质量仍受限于MEG信号的信息量。
预训练模型的选择影响解码性能
实验比较了多种图像嵌入,发现监督学习(VGG-19)和图文对齐(CLIP)模型表现最佳,自监督DINOv2在图像消失后阶段表现突出。线性岭回归基准的准确率远低于端到端训练的深度卷积网络,后者提升约7倍。这提示预训练表征的质量与训练方式对解码效果至关重要,但文章也指出,是否微调生成模块或融合多种特征仍需进一步研究。
伦理与实时应用:隐私保护是技术前提
文章强调,非侵入式解码在感知任务上表现较好,但在想象任务或受试者进行干扰任务(如倒着数数)时准确性大幅下降。这意味着获取受试者同意不仅是法律义务,也是技术上的必要条件。此外,实时解码有望帮助脑损伤患者沟通,但当前MEG方法仍处于实验室阶段,距离临床实时应用还有距离,需开放且经同行评审的研究标准。
Q&A
为什么用MEG而不是fMRI来做实时视觉解码?
fMRI时间分辨率低(约0.5 Hz),每两秒才能获取一幅大脑活动图像,难以用于实时场景;而MEG时间分辨率极高(约5000 Hz),能追踪神经活动的动态变化,更适合实时解码。
这个MEG视觉解码模型是怎么工作的?
模型包含三个模块:从图像中提取预训练嵌入、端到端训练的MEG模块、预训练图像生成模块。MEG模块通过对比学习(CLIP损失)和回归(MSE损失)训练,将MEG信号对齐到图像嵌入空间,进而用于检索或生成图像。
MEG解码在图像检索任务上的准确率有多高?
在小型测试集上,MEG解码器的前5准确率约70%(如VGG-19达70.33%),比传统线性解码器提升7倍;在更复杂的大测试集上准确率约13%,但仍显著优于随机水平。
MEG解码生成的图像效果如何?能还原细节吗?
生成的图像在类别层面与真实图像一致,但难以还原轮廓、阴影等低级特征。定量指标(如PixCorr、SSIM)低于fMRI,主要因为MEG空间分辨率低(厘米级),而fMRI可达毫米级。
MEG解码视觉信息有哪些主要局限性?
主要局限有三:一是空间分辨率低,难以解码低级视觉特征;二是方法依赖多个预训练模型,仅通过端到端学习对齐MEG信号;三是解码性能仍受限于MEG信号本身的信息量。
这项技术未来能用在哪些实际场景?
最直接的应用是帮助因脑损伤而沟通困难的患者,通过实时解码视觉感知辅助交流;此外,生成式解码方法能直观预测大脑视觉处理过程,有助于理解视觉系统工作机制。
