小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI

中国联通研究团队在AAAI 2026上发布了HiMo-CLIP模型,解决了长文本图像检索中的语义层级和单调性问题。该模型通过动态特征提取和对齐机制,显著提高了长短文本的检索精度,性能优于现有模型。

让大模型学会“高维找茬”,中国联通新研究解决长文本图像检索痛点|AAAI 2026 Oral

量子位 量子位 · 2025-12-01T08:49:46Z
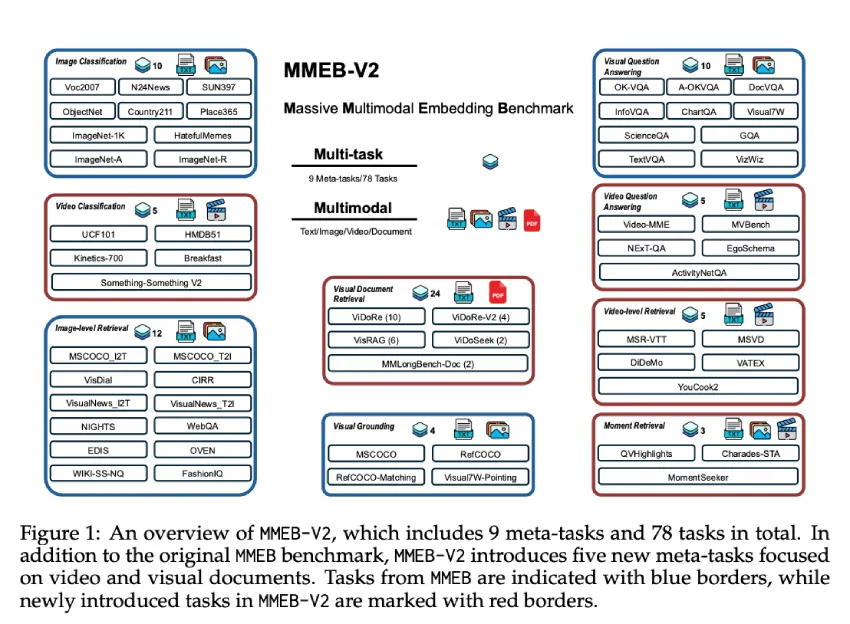
VLM2Vec-V2:用于跨图像、视频和视觉文档进行多模态嵌入学习的统一计算机视觉框架

VLM2Vec-V2是一种新型多模态嵌入模型,旨在统一图像、视频和视觉文档检索。基于MMEB-V2基准,支持多种输入模态,采用Qwen2-VL作为骨干,具备动态分辨率和多模态嵌入特性,提升了对比学习的稳定性。实验结果表明,该模型在多模态任务中表现优异。

VLM2Vec-V2:用于跨图像、视频和视觉文档进行多模态嵌入学习的统一计算机视觉框架

实时互动网 实时互动网 · 2025-07-28T02:56:16Z
如何掌握向量数据库

向量数据库专为存储和搜索高维向量而设计,改变了处理非结构化数据的方式,适用于推荐系统和图像检索等应用。它们通过计算向量间的距离,快速找到相似数据。常见的向量数据库包括Milvus、Pinecone和Weaviate,支持与机器学习工作流的无缝集成。理解向量嵌入是使用这些数据库的基础。

如何掌握向量数据库

The New Stack The New Stack · 2025-04-28T13:00:26Z
FocalLens:指令调优实现零-shot条件图像表示

FocalLens是一种条件视觉编码方法,通过自然语言指令生成不同的图像表示,能够更好地突出视觉特征,提升图像检索和分类任务的性能,平均提高5到10分。

FocalLens:指令调优实现零-shot条件图像表示

Apple Machine Learning Research Apple Machine Learning Research · 2025-04-14T00:00:00Z
构建视频内容搜索与分析的RAG系统

本文介绍了如何利用Amazon Bedrock、Transcribe和Aurora PostgreSQL将视频内容转化为可搜索的向量,通过提取视频帧和音频转录生成多模态嵌入,实现自然语言查询,支持图像和文本检索,提升用户体验。

构建视频内容搜索与分析的RAG系统

DEV Community DEV Community · 2025-04-10T21:04:13Z
基于强化学习的多模态标签排名:一种新方法

本文提出了一种基于强化学习的多模态标签相关性排名方法,旨在提高图像和文本等多模态输入下标签排名的准确性和效率,可能改善图像检索和内容推荐等应用。

基于强化学习的多模态标签排名:一种新方法

DEV Community DEV Community · 2025-04-07T22:55:40Z

本文提出了一种新方法Fwd2Bot,用于大型视觉语言模型(LVLM)中视觉令牌的高效压缩。该方法通过双向前传训练,实现了几乎无损的压缩效果,显著提升了生成任务的压缩率,并在图像检索与组合性任务上达到了新的最先进性能。

Fwd2Bot: LVLM Visual Token Compression with Bidirectional Bottleneck

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-27T00:00:00Z

本研究提出了ImageScope框架,通过集体推理和语言组合特性,统一语言指导图像检索(LGIR)任务,显著提升了检索的准确性和可靠性。实验结果显示,ImageScope在六个数据集上优于现有基线。

ImageScope: Unifying Language-Guided Image Retrieval through Collective Reasoning with Large Multimodal Models

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-13T00:00:00Z

本研究提出了一种结合手绘素描和文本描述的复合查询接口,以解决非母语者在命名特定物体时的困难。通过使用CSTBIR数据集和STNET模型,显著提升了图像检索效果,帮助用户更有效地查找难以识别的物体及其复杂交互。

Composite Sketch + Text Queries for Retrieving Objects with Elusive Names and Complex Interactions

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-12T00:00:00Z

本研究提出了一种模态反转方法,解决了CLIP等多模态模型中仅使用文本或图像编码器的低效问题,显著提升了图像检索性能,并缓解了模态内不对齐现象。

Bridging the Gap: Revealing Intra-Modal Misalignment in CLIP through Modal Inversion

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-06T00:00:00Z

本研究提出了一种基于形状的单一物体分类集成方法,旨在解决图像标注和检索中的分类问题。通过分层分类框架,缩小语义差距,实现多类别图像分类。研究表明,Bagging分类器在分类单一物体图像时表现最佳,分类准确率从20%提升至99%。

Ensemble Method Classifiers for Shape-Based Single Object Classification

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-16T00:00:00Z
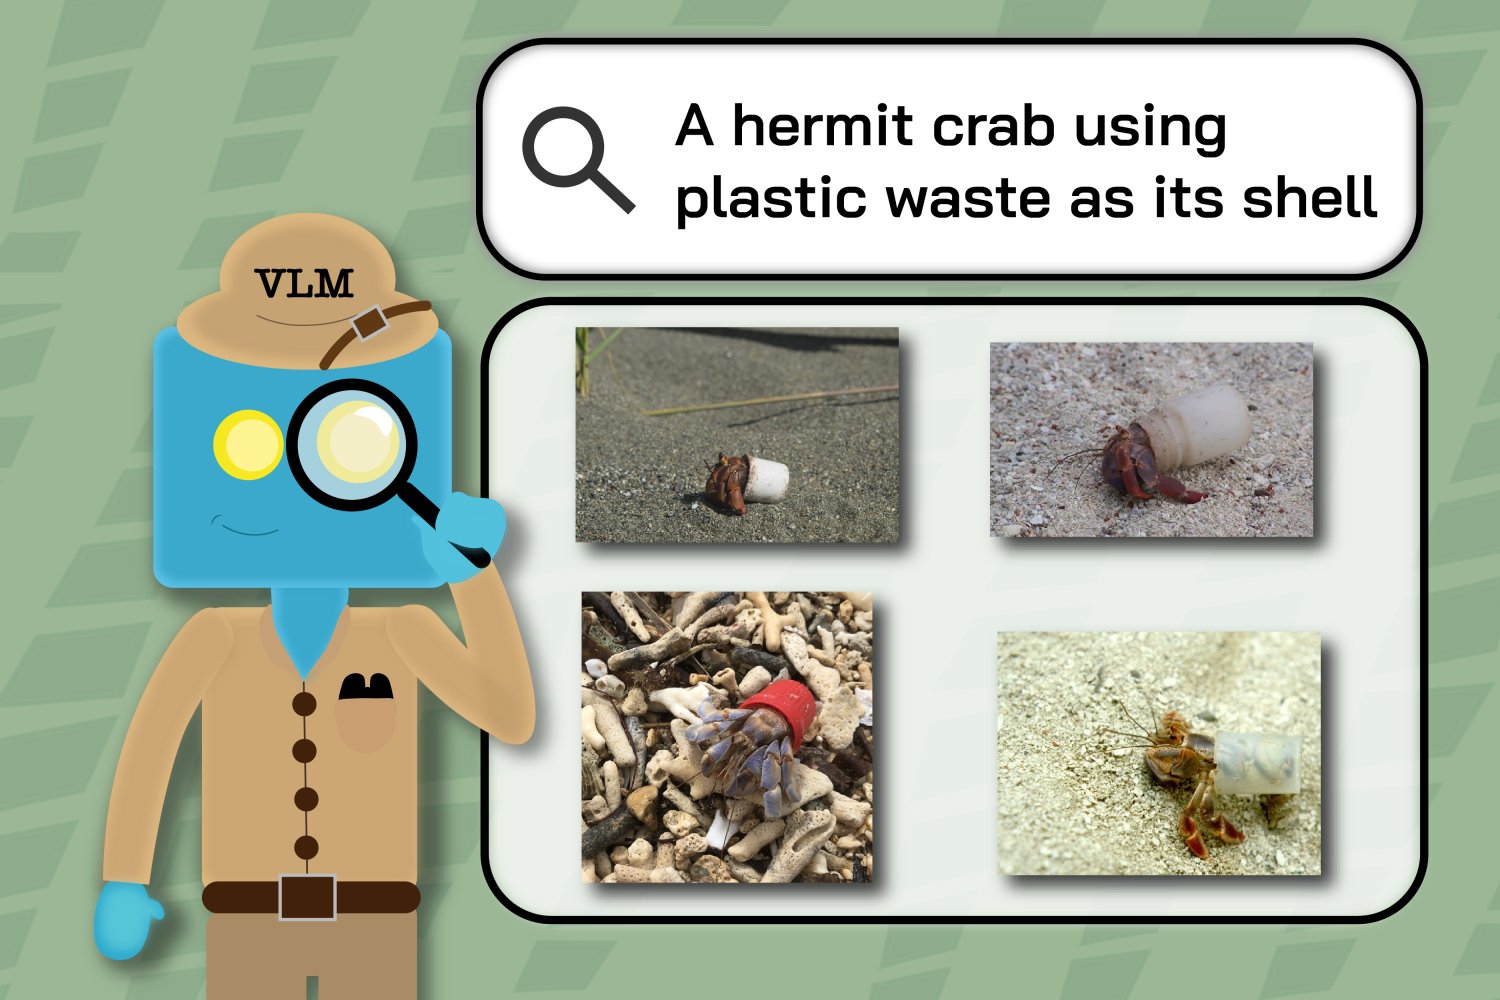
生态学家发现计算机视觉模型在检索野生动物图像时的盲点

研究人员评估了多模态视觉语言模型(VLMs)在自然图像数据集中的图像检索能力。尽管大型VLMs在简单查询中表现良好,但在复杂且需专业知识的查询中仍显不足。研究指出,VLMs需要更多领域特定的训练数据,以提升对科学术语的理解和图像检索的准确性。

生态学家发现计算机视觉模型在检索野生动物图像时的盲点

MIT News - Artificial intelligence MIT News - Artificial intelligence · 2024-12-20T22:00:00Z

本研究提出了一种双重变换方法,克服了传统图像检索在高维空间中的性能限制。通过端到端训练,结果表明在异构空间中的匹配显著提高了图像检索的准确性,尤其在复杂数据集上效果显著。

相异空间中的图像检索方法

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-11T00:00:00Z

本研究提出了一种新学习范式,解决了图像理解模型在视觉层次学习中的不足。该模型在无明确层次标签的情况下,能够在双曲空间中编码多级视觉层次,显著提升图像检索的层次能力。

通过双曲嵌入学习视觉层次

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-11-26T00:00:00Z

本研究提出了一种基于显著性图的不变Krawtchouk矩的图像检索方法(SM-IKM),通过显著区域检测与多阶特征结合,显著提高了检索的准确性和效率。实验结果显示,该方法优于现有技术。

Image Retrieval Method Based on Saliency Maps: Application of Invariant Krawtchouk Moments

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-11-13T00:00:00Z
通过Hacktoberfest开启开源之旅!

参加2024年Hacktoberfest让我收获颇丰,完成了四个拉取请求并获得Holopin徽章。虽然起初对开源开发感到困惑,但我通过挑战提升了前端开发和问题解决能力,创建了Medium克隆模板,开发了基于文本查询的图像检索模型并优化了算法。我从初学者成长为自信的贡献者,激发了对开源的热情。

通过Hacktoberfest开启开源之旅!

DEV Community DEV Community · 2024-11-02T09:32:08Z

本文提出了一种新的开放世界持续视觉表征学习方法DPaRL,通过动态生成提示增强模型对未见类别的泛化能力。实验结果表明,DPaRL在开放世界图像检索基准上表现优越,Recall@1提升4.7%,有效应对动态开放世界环境中的持续学习挑战。

DPaRL:耶鲁+AWS出品,开放世界持续学习场景的新解法 | ECCV'24 - 晓飞的算法工程笔记

晓飞的算法工程笔记 晓飞的算法工程笔记 · 2024-11-01T01:21:00Z

本文介绍了视觉对话任务,提出了一种基于视觉的通用测试方法和新的聊天数据收集协议。研究利用多种编码器和解码器,超越了复杂基准线,展示了“视觉聊天机器人”的性能。同时,介绍了交互式图像检索方法和新数据集PhotoChat,促进了图像文本建模研究,解决了有趣的现实问题。

ChatSearch:通用对话图像检索的数据集和生成检索模型

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-10-24T00:00:00Z

本文介绍了一种基于深度卷积网络的特征提取方法,能够有效迁移到其他任务,提升视觉挑战的表现。研究提出了多种数据集提炼技术,如DataDAM和DREAM+,显著提高了图像到文本检索的准确率,并降低了训练成本。同时,UDD方法增强了合成数据集的信息性,解决了深度学习中的数据存储和计算成本问题,取得了优异的实验结果。

在复杂场景中强调判别特征的数据集蒸馏

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-10-22T00:00:00Z

本文探讨了多模态transformer模型在语言和视觉任务中的应用,重点研究了零样本图像检索的影响因素。提出了i-Code V2和Emu2等模型,展示了多模态预训练的强大性能。instruct-imagen模型通过多模态指导实现图像生成,Anole展示了高效的图像-文本生成能力。最后,Show-o模型结合自回归和离散扩散建模,展现了在多模态理解与生成任务中的潜力。

Janus:解耦视觉编码以实现统一的多模态理解与生成

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-10-17T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码