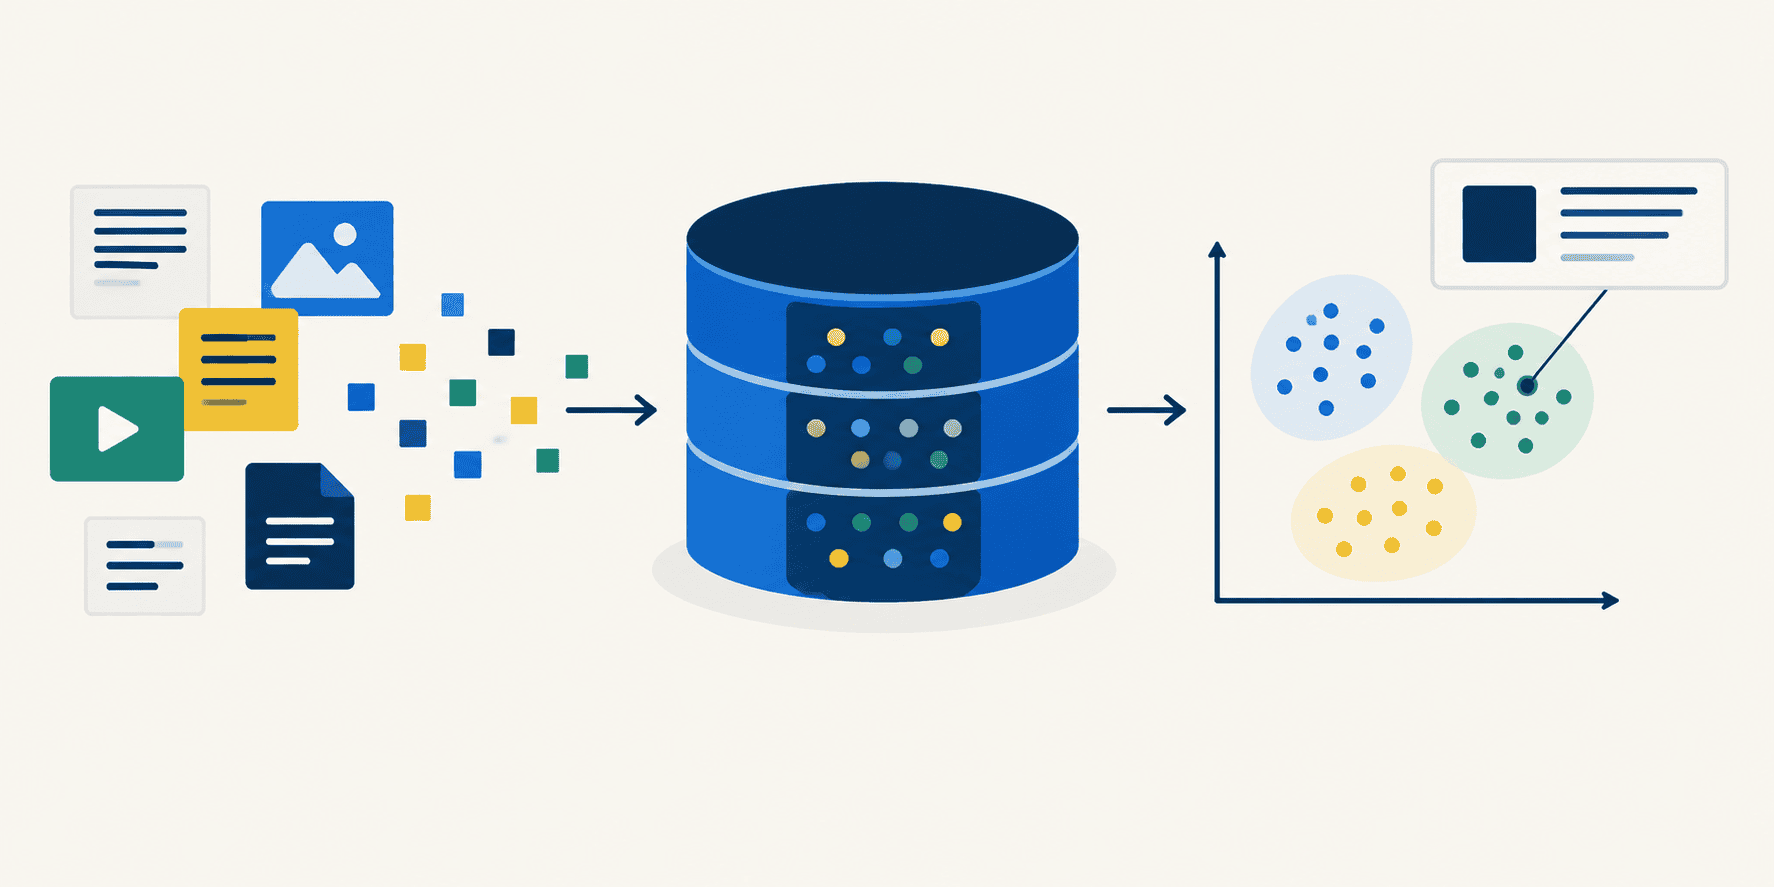

从零开始,十步轻松构建并理解向量数据库
内容提要
本文介绍如何用 Python 和 NumPy 从零分十步构建向量数据库:将文档编码为定长向量,实现按语义而非关键词检索,并加入元数据过滤、输入校验和持久化。通过余弦相似度暴力搜索演示检索开销随语料规模线性增长,指出十万条以上排序开销增大,百万级需采用 HNSW、IVF 等近似索引。核心是归一化后点积即余弦相似度,该设计在 25 条到 2500 万条文档间保持不变。
延伸解读
向量索引的固定开销与可预测性
文章指出,无论文档是六个词还是六页,编码后都变成相同的384维向量,每个向量占1536字节。这意味着索引大小只与文档数量有关,与文档长度无关。这种固定开销让向量索引的存储和扫描成本变得可预测,也解释了为什么向量数据库能高效处理海量文本。
元数据过滤:弥补纯语义检索的盲区
纯向量检索可能返回语义相似但主题不符的结果,例如用生物学问题检索到漫画中关于线粒体的段落。文章通过where参数演示了元数据过滤如何排除这类干扰。过滤在排序前执行,因此即使请求k=5,若过滤后只剩1条,也只会返回1条,不会用不相关文档填充。
暴力搜索的扩展瓶颈与优化时机
文章实测显示,暴力搜索的扫描和排序耗时随文档数线性增长。在10万条时,排序开始超过扫描;到百万条时,扫描约25毫秒,全排序约90毫秒。此时可用np.argpartition找top k(约10毫秒),再往上则需要HNSW、IVF等近似索引,以少量精度换取速度。
持久化与模型一致性
保存索引时,向量存入.npy文件以紧凑加载,文本和元数据存入.json便于阅读。加载时,load()会拒绝由不同模型构建的索引。因为嵌入向量只有相对于生成它的模型才有意义,混用不同模型的向量会导致检索结果完全错误,而非轻微偏差。
Q&A
向量数据库和传统关键词搜索有什么本质区别?
向量数据库按语义而非关键词检索。它把文档和查询都编码成向量,通过比较向量方向(余弦相似度)来找到意思相近的结果,即使查询和文档没有共享任何单词也能匹配。
从零构建一个向量数据库需要哪些步骤?
文章用十步构建:1. 环境设置;2. 构建索引(编码文档);3. 首次搜索;4. 无共享词的搜索;5. 解读分数;6. 元数据过滤;7. 过滤窄于k的情况;8. 输入校验;9. 保存与加载;10. 扩展性分析。
向量数据库中的相似度分数如何解读?
分数是余弦相似度,范围在-1到1之间,越高表示越相似。但向量搜索总会返回k个结果,即使没有相关文档,因此需要设置分数下限来过滤低质量结果。
元数据过滤在向量搜索中起什么作用?
元数据过滤通过where参数只保留元数据匹配的文档,用于排除语义相似但主题不符的结果。例如,搜索细胞能量时,过滤topic为bio可以排除关于Thor的漫画文档,尽管后者向量相似度很高。
向量数据库的暴力搜索如何随数据规模扩展?
暴力搜索的扫描和排序开销随文档数量线性增长。在10万条时扫描约3.73ms、排序约8.90ms;百万条时扫描约25ms、排序约90ms。超过10万条后排序开销开始超过扫描,此时可考虑np.argpartition或近似索引。
什么时候应该使用近似索引(如HNSW、IVF)?
当文档数量达到百万级时,暴力搜索的排序开销变得显著(约90ms),此时应使用HNSW、IVF等近似索引,以少量精度换取速度。
向量数据库的持久化是如何实现的?
通过save()方法将向量保存为.npy文件(紧凑、加载快),文本和元数据保存为.json文件(可读)。load()方法会拒绝加载由不同模型构建的索引,因为嵌入向量只有相对于生成模型才有意义。
为什么向量数据库需要输入校验?
输入校验防止常见错误,如传入单个字符串而非列表(会被拆分成字符)或元数据数量与文本不匹配。add()方法通过抛出TypeError或ValueError来保持文档、元数据和向量一一对应,避免索引损坏。
