


大语言模型重复调用会重复计费,可通过缓存避免:先对请求、上下文、模型设置等做哈希精确匹配,未命中再用向量相似度语义检索,命中后回填精确缓存。需按场景设阈值和过期时间,实时数据、个性化及创意任务不宜缓存。实测可省约六成调用成本。
社交媒体平台正将推荐系统从基于互动信号转向语义检索,以对抗点击诱饵。LinkedIn统一为单一语言模型检索器,Meta保留多模型漏斗结构,YouTube则采用生成式检索生成视频ID。三者均利用嵌入匹配用户与内容,改善冷启动问题,但各有权衡:统一简化维护,专业化便于调控,生成式扩大覆盖但可能产生无效ID。
选择memory-lancedb-pro的原因包括:混合检索提高精度,智能提取和遗忘机制优化记忆管理,以及便捷的数据导入与迁移。Pro版支持更精准的语义检索和自动分类,适合需要高效记忆管理的用户。
苹果音乐推出了一种多语言语义检索系统,旨在提升搜索质量,特别是对拼写错误和跨语言查询的响应。该系统基于305M参数的双编码器模型,经过多目标训练优化。在线测试显示,整体转化率提升2.28%,无结果率减少86%,尾部查询转化率提升7.93%,证明了语义检索在困难查询中的有效性。
微软在.NET 11 Preview 4中强调向量搜索是AI开发的核心,结合EF Core和MCP Server模板,提升了语义检索和API调用的标准化。EF Core支持向量搜索,简化了AI应用开发,MCP为AI模型提供统一的工具调用接口。这些进展使.NET开发者能够更高效地构建AI应用。
现代人工智能系统越来越依赖多模态数据,尤其是图像理解。MySQL HeatWave GenAI使得在SQL工作流中直接实现图像理解成为可能,通过生成文本描述并转化为向量嵌入,提供可解释的语义检索。这种方法降低了基础设施成本,简化了AI系统的构建,使其更易于理解和管理。
2026年6月11日,Qdrant将在旧金山举办第二届Vector Space Day,主题包括AI基础设施、搜索相关性和语义检索。活动将包括深度讨论、快速演讲和社交时光,并举行全球黑客马拉松,鼓励创新的向量搜索应用。
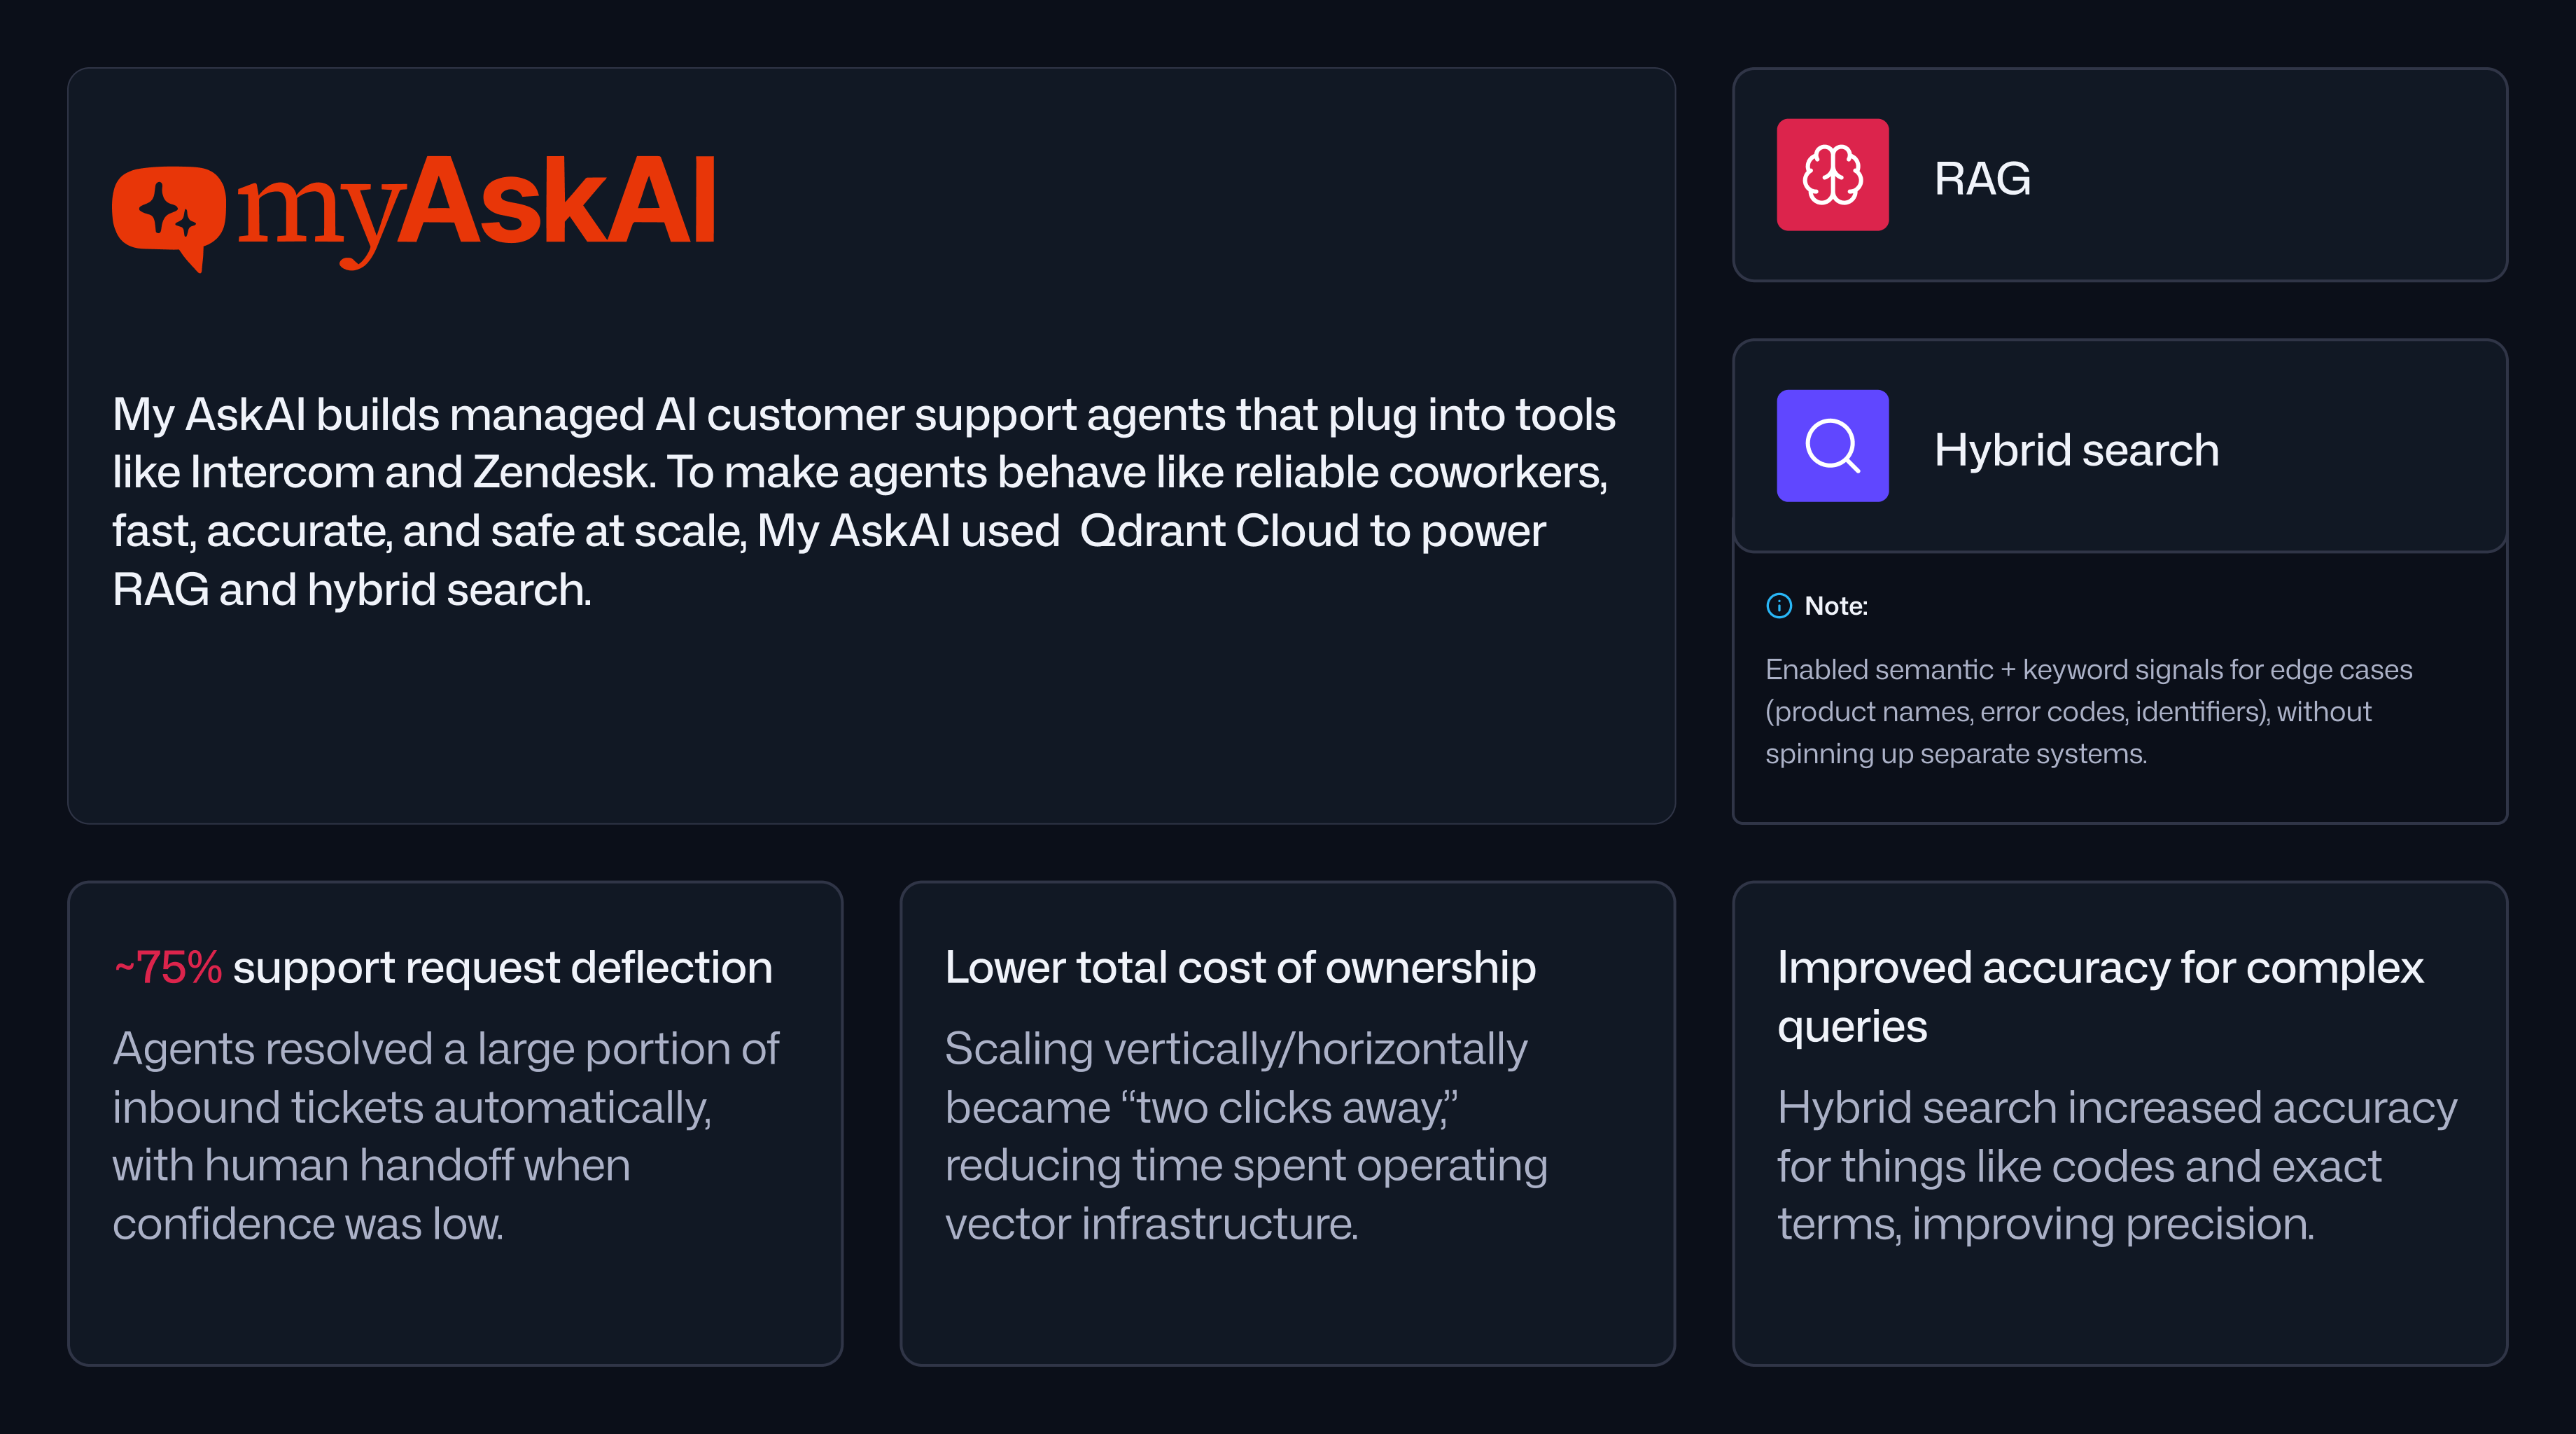
My AskAI开发了一个AI客服代理平台,旨在自动处理大部分支持请求,并在必要时转交给人类。该平台基于Qdrant Cloud,支持语义检索和混合搜索,以提高准确性和速度。未来将实现自学习功能,通过监控人类代理的响应不断更新知识库。
RAG系统通过语义检索为大模型提供知识补充,但存在上下文断裂和理解局限。相比之下,基于文件系统的检索方式使大模型能够主动探索知识,提升数据交互灵活性,尽管面临token消耗和安全性挑战,这种方法更符合大模型的发展趋势。
检索增强生成(RAG)结合MongoDB Atlas和Cohere Command R+,为开发上下文相关的AI应用提供解决方案。该架构涵盖文档处理、向量存储、语义检索和基于检索信息生成答案,确保生成的回答准确且相关,帮助开发者构建高效、可扩展的AI系统。
RAG-MCP框架通过语义检索优化大语言模型的工具调用,显著降低提示词负担。测试结果显示,RAG-MCP在令牌使用、准确率和响应时间上均优于全工具MCP,分别减少67%、提高6.3%和缩短26.7%。该架构在复杂场景中仍需优化,未来可探索多模态工具描述和自适应检索策略。
本文探讨了知识库技术及其局限性,强调RAG(检索增强生成)在大模型获取实时信息和专业知识中的重要性。RAG通过检索相关信息并生成答案,提升模型的回答能力。文章介绍了RAG的实现步骤,包括知识库整理、语义检索和增强生成,并提到GraphRAG作为一种高级方案,尽管构建和使用成本较高,但能克服传统RAG的局限性。
本研究提出RAG-MCP框架,旨在解决大型语言模型在使用外部工具时的提示膨胀和选择复杂性问题,并通过语义检索提升工具选择的准确性。
未来的AI搜索将依赖嵌入和重排序模型,以提升信息检索的准确性。MongoDB Atlas正在整合Voyage AI的先进模型,优化语义检索,满足医疗、法律和金融等行业的需求,确保开发者高效获取相关信息。
本研究提出了一种新方法SRA-CL,通过语义检索增强对比学习,解决序列推荐中的数据稀疏问题,实验结果在多个数据集上表现优异。
RAG(检索增强生成)并非真正的检索工具,其“R”部分依赖语义检索,导致搜索结果数量有限,通常仅为3到10条,且可能来自同一文档,这对研究者造成限制。微软的新AI搜索功能支持自然语言检索,标志着语义检索的普及。
该论文提出了一种新的法律文本语义检索方法,并评估了多种解决方案。针对文本片段的相关性检测,提出了改进策略,并展示了专门化法律领域语言模型的成果。
谷歌发布了最新的AI模型Gemini,LlamaIndex全面支持Gemini的文本和多模态版本。Gemini在多个基准测试中表现优异,超越GPT-4。LlamaIndex提供文本完成、聊天和流式处理等功能,并推出了语义检索器API,用于高质量检索,结合LlamaIndex组件创建高级RAG管道。
本文介绍了如何使用Qdrant的Universal Query API构建研究论文发现系统。该系统结合密集语义、稀疏关键词和ColBERT重排序,帮助研究人员高效检索论文。通过创建包含多种向量类型的论文集合,系统实现智能过滤和并行检索,提高研究发现的准确性和效率。
本文讨论了如何评估Qdrant中的语义检索质量,重点在于嵌入质量和近似最近邻(ANN)算法的影响。通过比较近似搜索与精确搜索的结果,可以计算检索的精度。HNSW算法的参数可调,增加精度的同时也会增加延迟和内存需求。Qdrant提供内置的精确搜索模式,适合评估ANN算法的性能。
完成下面两步后,将自动完成登录并继续当前操作。