


如何调优Qdrant中的混合搜索
内容提要
本文介绍Qdrant混合搜索的调优方法:混合搜索融合稠密与稀疏检索结果,需先用nDCG@10验证融合是否优于单一检索;RRF仅用排名,DBSF利用分数分布,二者需在标注数据上对比;k值决定排名权重衰减,应按每查询相关文档数选择;权重最后调,并在留出查询上验证以避免过拟合。
延伸解读
融合并非总是优于单一检索
文章在五个数据集上对比了稠密、稀疏和默认RRF融合的nDCG@10,发现融合在四个数据集上优于较好的单一检索,但在DBPedia-entity上,稠密检索单独得分0.4677,而融合仅0.4638,反而落后。因此,在调优前应先验证融合是否真的带来提升,而不是默认假设混合搜索一定更好。
RRF与DBSF的选择取决于数据
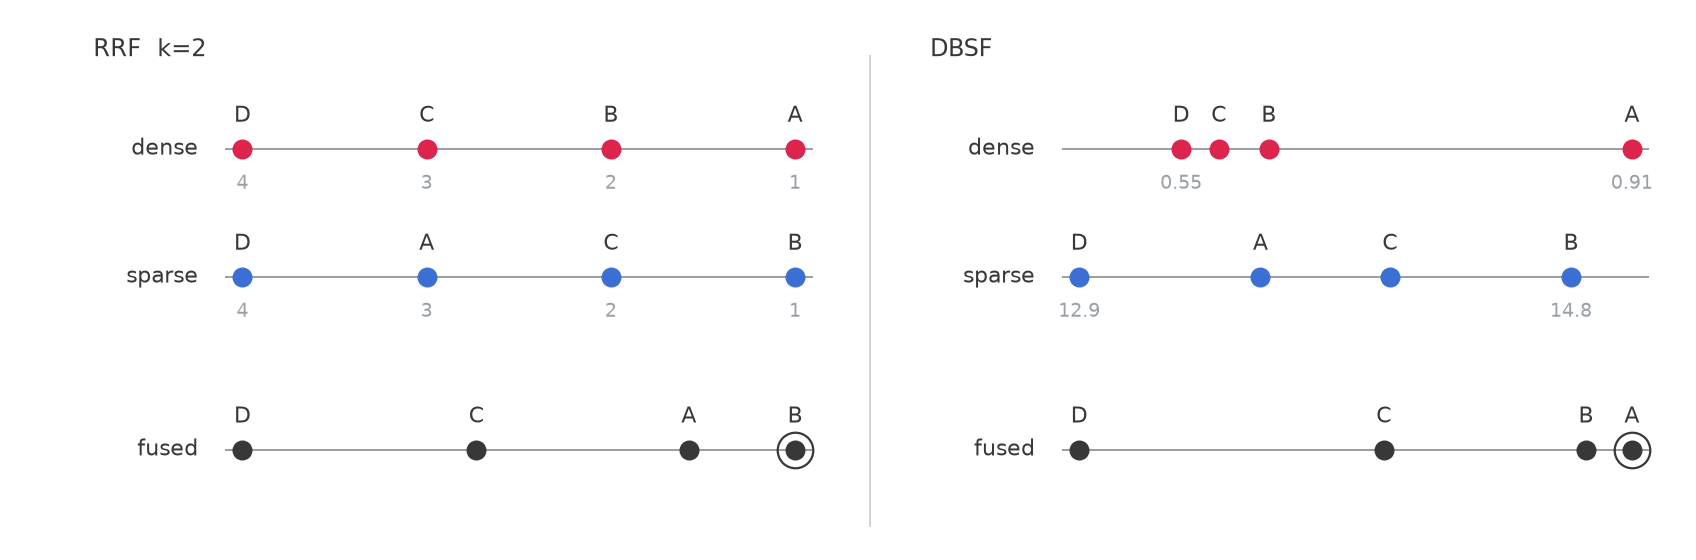
RRF仅利用排名位置,忽略分数差距;DBSF则利用分数分布,将两个列表的分数重新缩放后相加,能保留领先幅度。文章在五个数据集上对比,DBSF在三个数据集上显著优于默认RRF,但在两个数据集上差异不显著。因此,应使用标注数据对比两者,而非盲目选择。
k值应根据每查询相关文档数选择
RRF中的k决定排名权重的衰减速度:k越小,排名靠前的文档权重越高;k越大,两个预取都出现的文档更受重视。文章建议,若每查询相关文档数约1,最佳k在2或5附近;若相关文档数达数十或数百,最佳k在20或61附近。调参时可先尝试对应区间的k值。
权重调优需在确定k后进行
权重对为每个预取提供乘数,且是绝对值,因此(1,2)和(2,4)效果不同。文章强调,权重应在k确定后调整,因为权重对仅对测试时的k有效。例如在WANDS数据集上,k=5时(2,4)优于等权,但k=61时等权反而更好。权重方向不能仅凭单一预取的得分判断,需通过标注数据选择。
Q&A
Qdrant混合搜索调优前需要做哪些检查?
调优前应使用预调优检查来验证索引状态并设置带标签的基线。具体包括确认索引状态正常,并准备一个标注好的查询集作为评估基准。
如何验证混合搜索的融合结果比单一检索更好?
在调优前,比较稠密检索、稀疏检索和默认RRF(k=2,等权重)的nDCG@10。如果融合的nDCG@10高于两者中较好的一个,则融合有效。注意在DBPedia-entity数据集上融合可能不如稠密检索,因此需要在自己的标注数据上测量。
RRF和DBSF有什么区别?如何选择?
RRF仅使用候选在每个预取列表中的排名位置,忽略分数差距;DBSF将两个列表的分数重新缩放后相加,保留分数差距的大小。选择取决于数据,应在标注查询集上对比两者。在五个数据集中,DBSF在三个上显著优于默认RRF,但有两个数据集结果不明确。
在Qdrant中如何根据查询的相关文档数量选择RRF的k值?
k值决定排名权重的衰减速度。根据标注查询集中每个查询的相关文档数:如果平均约1个相关文档,最佳k为2或5;如果有数十或数百个,最佳k为20或61。建议在1、2、5、20、61这几个值上扫描k,并保持等权重。
调优混合搜索时,权重应该如何调整?
权重应最后调整,因为权重对仅在特定k值下有效。先确定k,然后在选定的k下扫描几组权重对。权重是绝对乘数,例如(1,2)和(2,4)不同。等权重也是可能的最佳结果。权重为0.0时,该预取的所有文档保留但得分为0,排在融合列表底部。
如何确认调优后的混合搜索配置在未见过的查询上仍然有效?
使用留出查询验证:将查询集分为选择集和留出集,在选择集上选出的配置需在留出集上保持增益。同时计算每查询增益的bootstrap置信区间,只有当区间排除零且留出集上增益保持时,才可发布该配置。否则保留默认配置也是合理选择。
