

实现一个linux初版的git
内容提要
文章讲解用Linux实现初版Git的原理:通过哈希跟踪文件变化,用commit标记仓库状态,并借助.git目录中的HEAD、index、objects、refs等存储管理;commit由tree和blob组织,tree表示目录,blob表示文件。作者还对比了云风游戏资源仓库与Git的区别,并建议不要用C语言实现。
延伸解读
Git 核心机制:哈希与提交
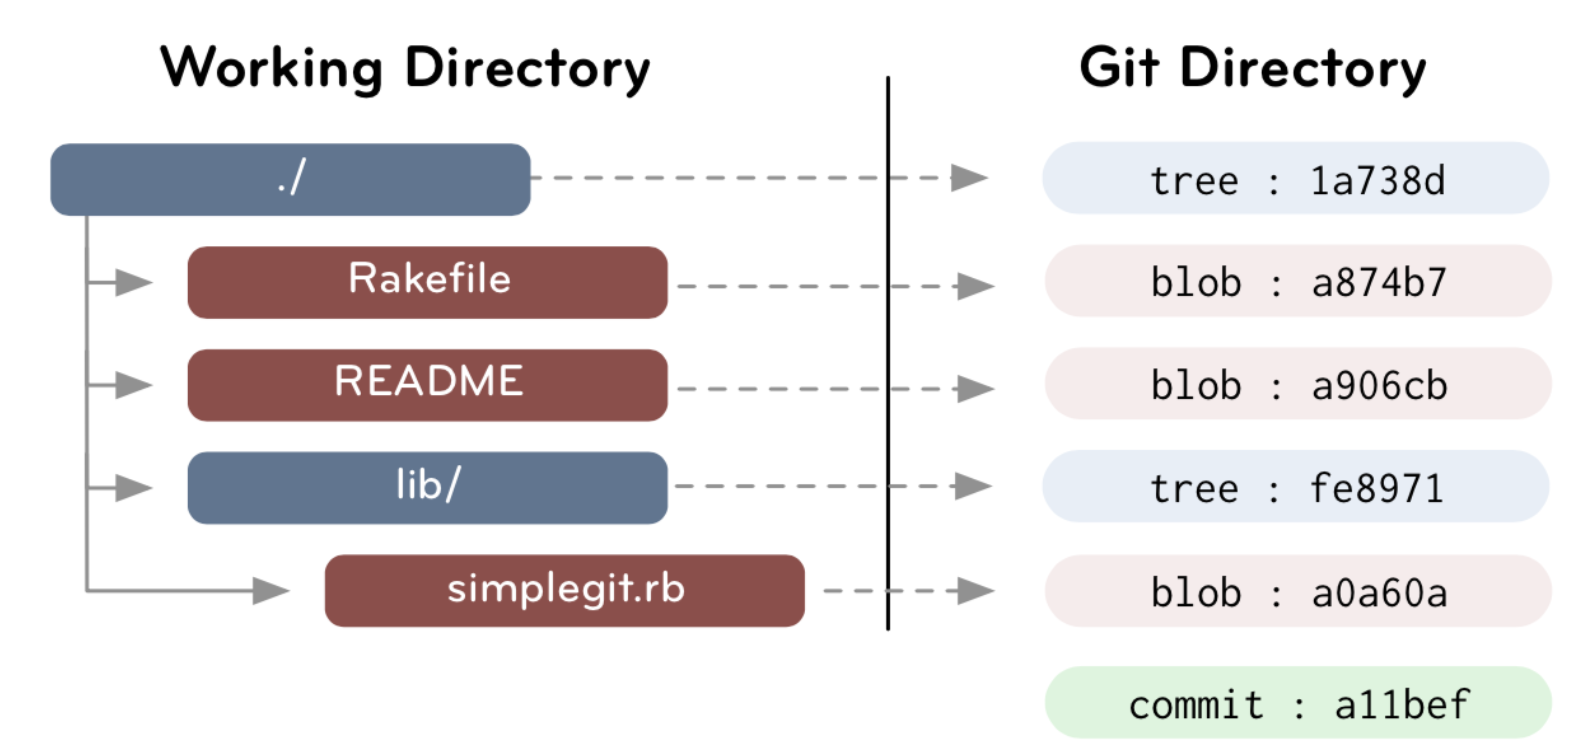
文章指出 Git 通过哈希跟踪文件变化,用 commit 标记仓库状态。每个文件内容经 SHA-1 计算得到唯一哈希,作为对象存储于 .git/objects 中。commit 则记录当前仓库的完整状态,包含指向 tree 的指针,tree 表示目录,blob 表示文件。这种设计使得 Git 能高效检测变化并恢复任意版本,tag 和 branch 本质只是 commit 的别名。
.git 目录结构解析
文章详细展示了 .git 目录下的关键文件:HEAD 指向当前分支或标签,refs/heads 存储各分支的最新 commit ID,refs/tags 存储标签。objects 目录以哈希前两位为子目录名,后 38 位为文件名,存储所有对象。新建分支只需在 refs/heads 下创建文件并写入 commit ID;新建 commit 则更新 HEAD 所指分支的文件内容。这种设计简洁而高效。
与云风资源仓库的对比
文章对比了云风的游戏资源仓库与 Git 的区别。云风的仓库用于单向同步,客户端按需从服务器拉取缺失的哈希对象,无需本地记录全量版本状态。而 Git 支持双向同步,需要本地组织 commit、切换离线版本,并将变更推送到上游。因此 Git 的本地存储更复杂,需维护完整的版本历史,而云风方案更轻量,适合特定场景。
实现建议:避免使用 C 语言
作者强烈建议不要用 C 语言实现初版 Git。他结合自身经验指出,用 C 处理文件读写、内容解析、哈希计算、序列化与反序列化以及链表操作时异常繁琐,开发体验差。虽然 Git 本身用 C 编写,但对于学习或快速原型,选择更高级语言能大幅降低复杂度,聚焦于理解版本控制的核心原理而非底层细节。
Q&A
Git 是如何跟踪文件变化的?
Git 通过比较文件的哈希值来判断文件是否发生变化。在初始化仓库后,它会记录所有需要跟踪的文件内容,之后通过哈希对比来检测修改。
Git 中的 commit 有什么作用?
commit 用于标记仓库的当前状态,将当前 repository 的状态存储起来。通过 commit 可以恢复到任意历史状态,git tag 和 git branch 本质上都是给 commit 起别名。
Git 的 .git 目录下有哪些关键文件和文件夹?
.git 目录包含 HEAD(指向当前分支或标签)、index(暂存区)、objects(存储文件内容,按 SHA1 哈希分目录存放)、refs(包含 heads 和 tags,分别存储分支和标签的 commit ID)等。
Git 中的 tree 和 blob 分别代表什么?
Tree 代表文件夹(目录),可以包含 blob 或其他 tree;Blob 代表文件内容。它们共同组织 commit 中的文件层级关系。
云风的游戏资源仓库与 Git 的主要区别是什么?
云风的仓库用于单向同步(Client 到服务器),客户端只需 key-value 数据库存储文件哈希和内容,无需记录全量版本状态;而 Git 是双向同步(Client 与 GitHub),需要本地组织 commit、支持离线操作并将变更同步到上游。
作者对用 C 语言实现 Git 有什么建议?
作者强烈建议不要用 C 语言实现 Git,因为 C 语言在读写文件、解析内容、序列化/反序列化对象以及组织链表操作时非常繁琐和困难。
