


FastEmbed:Qdrant的高效Python库用于嵌入生成
内容提要
FastEmbed是一个高效的Python库,旨在简化文本嵌入生成。它通过量化模型和ONNX Runtime实现快速嵌入,支持多种文本模型,适合大规模数据处理,提升性能和速度。
延伸解读
FastEmbed 的定位与优势
FastEmbed 专注于文本嵌入生成,通过量化模型和 ONNX Runtime 实现快速推理。与 PyTorch 或 TensorFlow 相比,它避免了复杂的依赖,安装时间短,内存和磁盘占用低。默认模型 BAAI/bge-small-en-v1.5 在速度和准确性之间取得平衡,适合生产环境。其设计目标是在 CPU 上高效运行,无需 GPU 或 CUDA 驱动,降低了部署门槛。
使用前缀提升检索效果
FastEmbed 支持在文本前添加“query”或“passage”前缀,以区分查询和段落。这一设计继承自 BAAI/bge 系列模型,能优化嵌入生成:查询前缀使嵌入更适合相似度比较,而段落前缀则增强上下文理解。虽然省略前缀也可运行,但为了更精准的检索结果,建议明确指定。
处理长文本的策略
FastEmbed 的默认模型上下文窗口最大为 512 个 token。对于超过此限制的文本,文章建议采用池化策略,例如将文档分块后取嵌入的平均值,以获得单个向量。这种方法参考了 SBERT 论文的推荐,能有效处理长文档,同时保持嵌入质量。
与 Qdrant 集成的便捷性
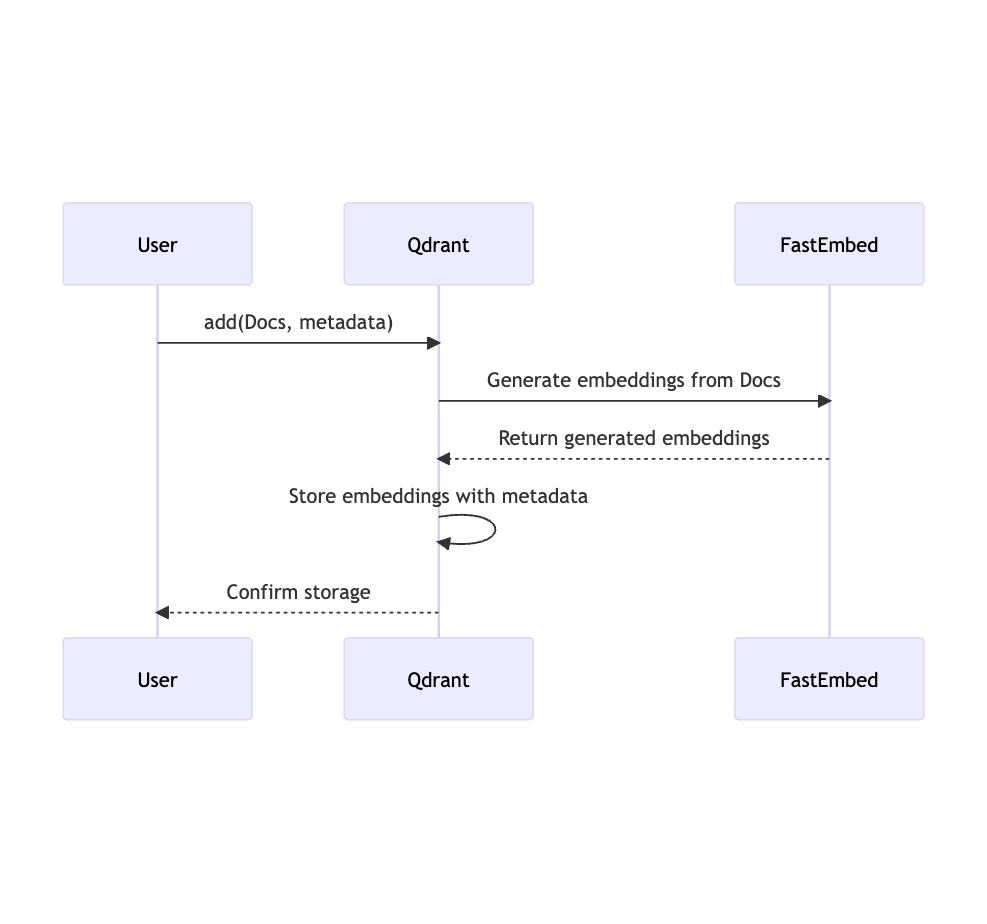
FastEmbed 与 Qdrant 向量数据库无缝集成,简化了嵌入生成、存储和检索的流程。通过 qdrant-client[fastembed] 安装后,用户只需几行代码即可添加文档并执行查询。Qdrant 的量化技术结合 FastEmbed 的轻量设计,能处理大规模数据集并保持低延迟,适合企业级应用。
Q&A
FastEmbed是什么?
FastEmbed是一个高效的Python库,旨在简化文本嵌入生成,支持多种文本模型。
FastEmbed如何提高嵌入生成的速度和效率?
FastEmbed通过量化模型和ONNX Runtime实现快速嵌入,避免复杂的依赖关系,提升性能。
使用FastEmbed生成文本嵌入的代码示例是什么?
可以使用三行代码:documents = [...]; embedding_model = DefaultEmbedding(); embeddings = list(embedding_model.embed(documents))。
FastEmbed的默认模型是什么?
FastEmbed的默认模型是BAAI/bge-small-en-v1.5,平衡了速度和准确性。
如何将FastEmbed与Qdrant结合使用?
用户需安装Qdrant Client和FastEmbed库,然后初始化Qdrant Client并添加文档,最后执行查询。
FastEmbed的安装要求是什么?
FastEmbed的安装要求包括onnx、onnxruntime、tqdm、requests和tokenizers等,且依赖关系较少。
