


Lucy如何利用Qdrant为280多万份SEC和DART文件构建可信来源检索层
内容提要
Lucy为金融AI构建数据基础设施,将SEC和韩国DART的280多万份监管文件转为可检索数据。其RAG系统采用Qdrant的混合搜索、元数据过滤和量化技术,在FinanceBench上Recall@10达94.7%,仅靠检索即提升答案准确率0.16,使开源小模型表现超过依赖网络搜索的前沿模型,且答案可溯源至原始文件。
延伸解读
检索层独立价值:0.16准确率提升的启示
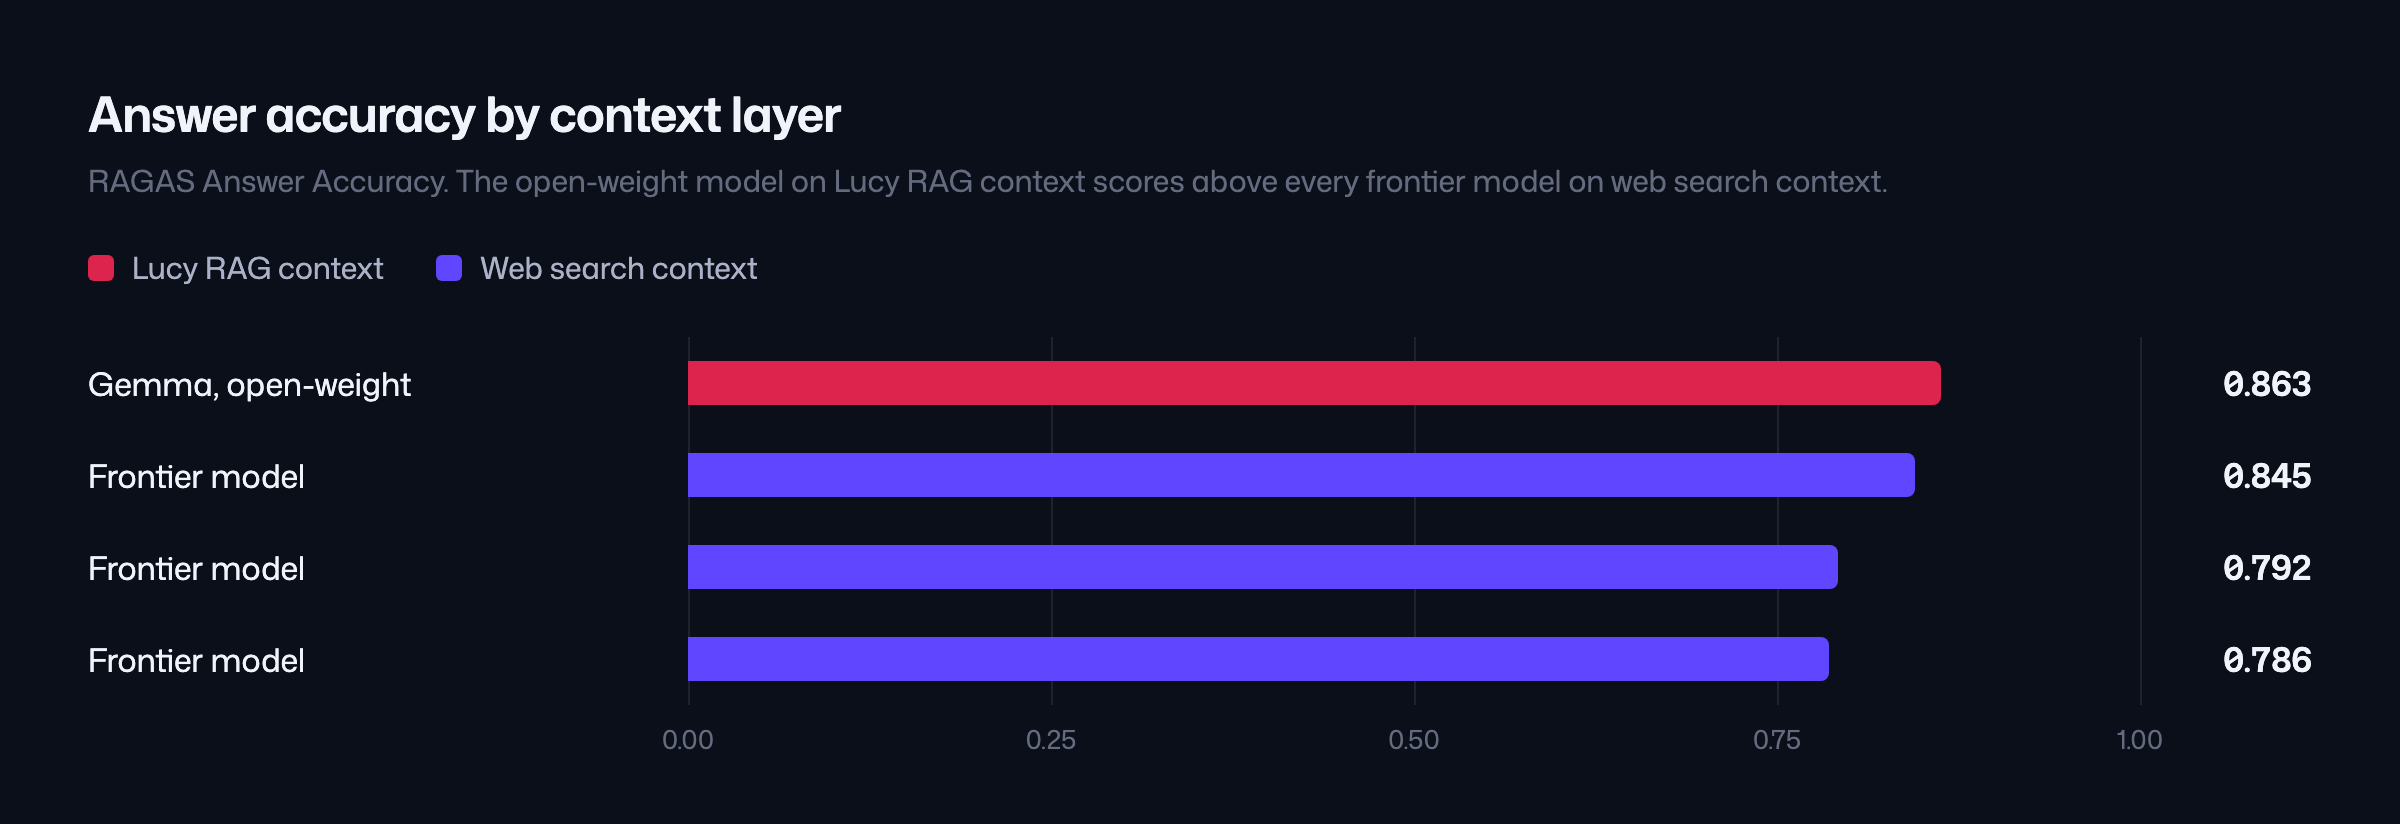
在固定答案模型(Claude Fable 5)的前提下,仅将上下文从通用网络搜索替换为Lucy RAG,RAGAS答案准确率从0.792提升至0.952,增益0.160完全来自检索层。这表明在金融问答场景中,优化检索质量可能比升级大模型更有效,且成本更低。对于构建RAG系统的团队,应优先投资于数据质量、混合搜索和元数据过滤,而非盲目追求更大参数模型。
量化压缩的权衡:2-bit与4-bit的选择依据
Lucy在10-K语料上测试4-bit TurboQuant,内存从约52GB降至10.7GB(4.9倍压缩),混合检索的Recall@20仅变化+0.2%,MRR+0.1%,nDCG@20-0.1%,几乎无损。基于此,对韩文DART文件采用更激进的2-bit量化,因为韩文分词产生更多块,压缩收益更大;而SEC文件保守使用4-bit。这提示量化策略需按语料特性调整,稀疏检索可弥补稠密向量的压缩损失。
生产环境教训:按文件类型分集合避免性能退化
初期将所有SEC文件类型存入单一集合,并在块文本前添加元数据前缀,小规模可行。但随着覆盖扩大,检索延迟上升2-3倍,召回率下降。Lucy将数据按文件类型拆分集合,并将元数据移至索引化payload字段(如accession_number、chunk_type、item_key),使延迟和召回随语料增长同步改善。这提醒我们,向量数据库的集合设计需随规模演进,避免元数据污染向量空间。
多车道检索架构:精度与召回的平衡
Lucy RAG通过四个车道执行混合查询:窄车道用章节过滤保证精度,宽车道作为召回安全网,XBRL车道针对财务数字提升表格排名,伴随车道处理引用文件。各车道返回最多60个候选,经RRF融合后取前20块。实测1517次搜索平均32ms,p50为16ms。宽车道因过滤最宽松而最慢(平均42ms),但正是其宽泛性保障了召回。这种设计在延迟与效果间取得了可量化的平衡。
Q&A
Lucy 为什么选择 Qdrant 作为其检索层?
Lucy 选择 Qdrant 是因为它满足了 SEC 和 DART 检索工作负载的三个特定需求:1) 过滤:Qdrant 的 payload 过滤在查询内部应用结构化信号(如公司、CIK、表格类型等),使过滤和向量搜索一起执行,而不是事后修剪候选列表;2) 搜索:Qdrant 的混合搜索同时支持密集向量和稀疏向量,Lucy 使用倒数排名融合(RRF)合并排名列表;3) 成本:原生量化保持索引占用小,分布式架构和分片支持水平扩展。
Lucy RAG 在 FinanceBench 上的检索性能如何?
Lucy 的检索层在 FinanceBench 上达到 Recall@5 为 93.4%,Recall@10 为 94.7%,nDCG@10 为 0.771,MRR 为 0.774。在 FinQABench 上,Recall@5 为 83.1%,Recall@10 为 89.6%,nDCG@10 为 0.762,MRR 为 0.745。
Lucy 的 RAG 系统如何路由查询?
查询首先通过路由器确定用户所指的公司和文件,检查目录数据库,解析实体和 CIK,并通过 SEC accession number 或 DART listing number 固定确切文档。如果问题模糊,路由器会要求用户澄清。然后路由器将元数据过滤器(公司、表格类型、日期范围、文档 ID)传递给 Qdrant。检索在四个通道中运行:窄通道(带部分过滤器的聚焦多查询)、宽通道(更广泛的搜索作为召回安全网)、XBRL 通道(仅用于财务报表问题)、伴随通道(当文件通过引用并入另一文件时)。每个活跃通道返回最多 60 个候选,用 RRF 融合、去重,最终将前 20 个块传递给答案模型。
Lucy 在生产环境中如何部署 Qdrant?
Lucy 自托管 Qdrant。生产环境有 12 个集合,约 5225 万个密集向量和相同数量的稀疏向量。SEC 语料使用 OpenAI text-embedding-3-small(1536 维)和 BM25 稀疏检索;DART 语料使用 Upstage solar-embedding-2(1024 维)和 BM25。SEC 使用 4 位量化,DART 使用 2 位量化。团队最初将所有 SEC 文件类型存储在一个集合中,随着规模扩大延迟增加 2-3 倍且召回下降,后来按文件类型拆分集合并将元数据移至索引 payload 字段。整个系统由不到 10 名工程师运营。
Lucy 使用量化技术对检索质量有何影响?
Lucy 在 10-K 语料上评估了 TurboQuant:4 位量化将内存占用从约 52 GB 降至 10.7 GB,减少 4.9 倍。质量影响很小:仅密集检索时 Recall@20 下降 0.8%,MRR 下降 0.3%,nDCG@20 下降 0.6%;混合检索(密集+BM25,RRF)时 Recall@20 上升 0.2%,MRR 上升 0.1%,nDCG@20 下降 0.1%。混合检索基本不变,因为稀疏侧弥补了密集侧的压缩损失。因此 Lucy 在 DART 文件上使用 2 位量化,在 SEC 文件上使用更保守的 4 位。
Lucy 的检索层如何提升答案准确性?
在固定答案模型(Claude Fable 5)的情况下,仅改变上下文层,RAGAS 答案准确性从使用通用网络搜索上下文的 0.792 提升到使用 Lucy RAG 上下文的 0.952,提升 0.160,这完全归因于检索。此外,一个开源 Gemma 模型与 Lucy RAG 配对后,得分超过了所有使用网络搜索上下文的前沿模型。
