
大语言模型有金鱼般的记忆吗?
内容提要
大语言模型无持久记忆,每次API调用均为无状态。对话中的“记忆”实为应用层在每次请求时重新发送历史消息、摘要或检索结果。上下文窗口是容量有限、成本随对话增长的临时工作记忆。为扩展记忆,应用常用滑动窗口、对话摘要、结构化提取、向量检索和用户画像等技术;跨会话记忆仍需将信息重新注入上下文。
延伸解读
模型无状态,记忆靠应用重建
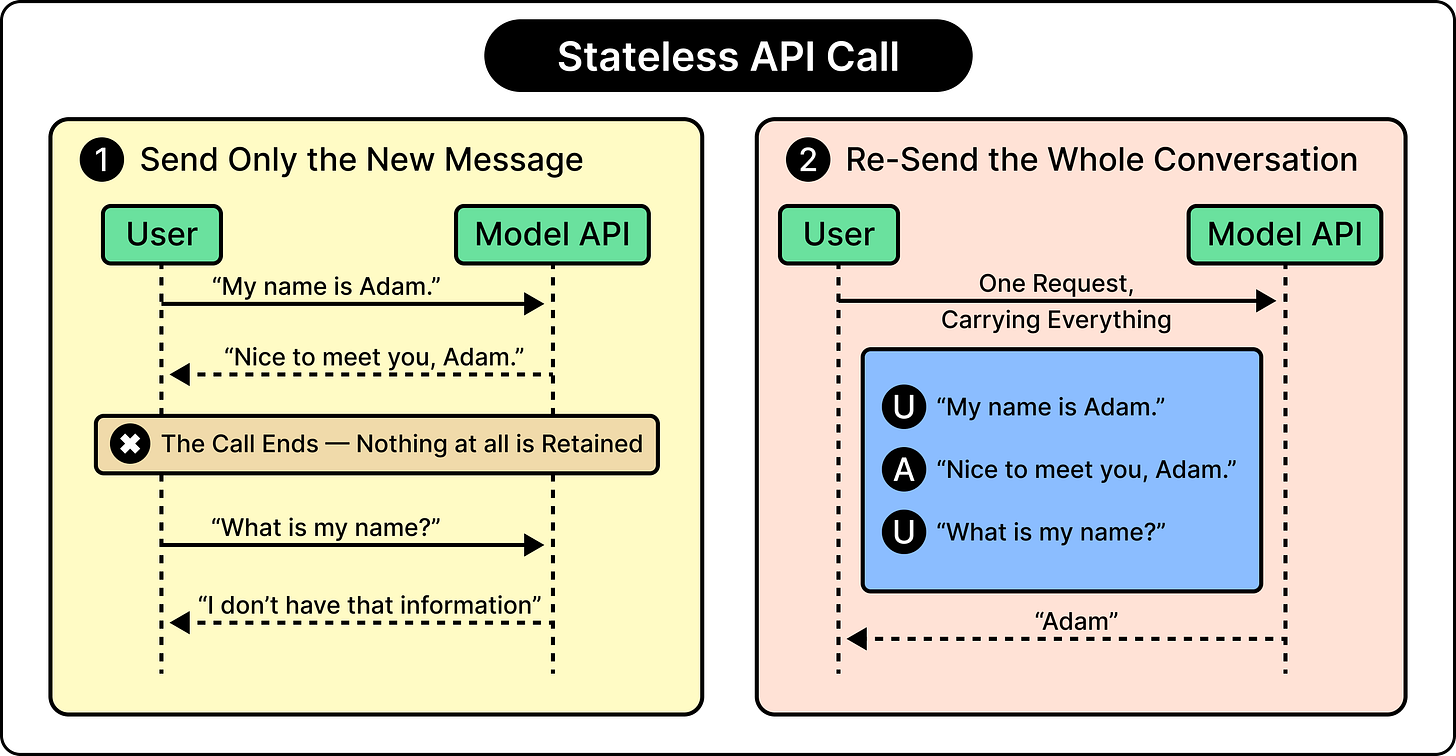
文章强调,大语言模型本身没有持久记忆,每次API调用都是无状态的。对话中看似“记得”之前的内容,其实是应用层在每次请求时重新发送历史消息、摘要或检索结果。模型只处理当前输入中的文本,不会自动更新权重或保存个人经历。因此,理解LLM记忆的关键在于区分模型与围绕模型的应用架构。
上下文窗口是有限的工作记忆
上下文窗口是模型生成当前回复时能考虑的全部信息,包括系统指令、历史消息、检索文档等。它容量有限,且随着对话增长,成本和延迟都会上升。文章指出,即使窗口很大,也可能出现“上下文腐烂”,即信息过多导致模型难以区分重要事实。因此,上下文窗口既是容量限制,也是注意力管理问题。
扩展记忆的常用技术及其权衡
为突破上下文限制,应用常组合使用滑动窗口、对话摘要、结构化提取、向量检索和用户画像。滑动窗口简单但会丢失旧信息;摘要压缩高效但有损,可能扭曲原意;结构化提取适合精确事实,却难以处理叙事细节;向量检索能语义召回,但可能检索到无关或过时内容。这些技术各有取舍,通常需要搭配使用。
跨会话记忆仍需重新注入上下文
跨会话记忆指信息在一次对话结束后仍能影响后续对话。实现上,应用会在对话中识别持久信息,存入用户或项目级记忆库,并在新对话开始时检索相关记忆,再将其插入当前上下文。关键一步是:新的模型调用仍需要这些记忆被显式放入输入中。模型不会自动携带个人经验,记忆质量高度依赖周边架构。
Q&A
大语言模型本身有持久记忆吗?
没有。大语言模型通常没有个人或持久的记忆,每次API调用都是无状态的。模型不会像人类那样记住对话,它只是接收当前输入的信息。
为什么大语言模型能记住之前的对话内容?
因为围绕模型构建的应用程序在每次请求时重新发送历史消息、摘要或检索结果。应用程序负责存储消息、维护摘要、检索相关记忆和用户画像,并将这些信息放入当前上下文中,从而让模型看起来有记忆。
上下文窗口在LLM中扮演什么角色?
上下文窗口是模型的临时工作记忆,容量有限,包含系统指令、当前消息、历史消息、检索文档、工具描述等。它像一张桌子,模型只能处理放在上面的内容。一旦空间耗尽,必须移除、压缩或替换信息。
长对话为什么会变得昂贵且缓慢?
因为每次请求都需要处理不断增长的对话历史,导致输入token数量增加,从而增加成本和延迟。例如,10轮对话可能处理约55K token,而可见对话仅约10K token。
有哪些技术可以扩展LLM的记忆?
常用技术包括滑动窗口、对话摘要、结构化实体提取、向量存储检索和长期用户画像。这些技术通常组合使用,以管理上下文窗口内的信息。
跨会话记忆是如何实现的?
跨会话记忆通过将信息存储在外部记忆库中,并在新对话开始时检索相关记忆并插入到当前上下文中来实现。关键步骤是应用程序必须将记忆信息重新注入新对话的上下文。
