

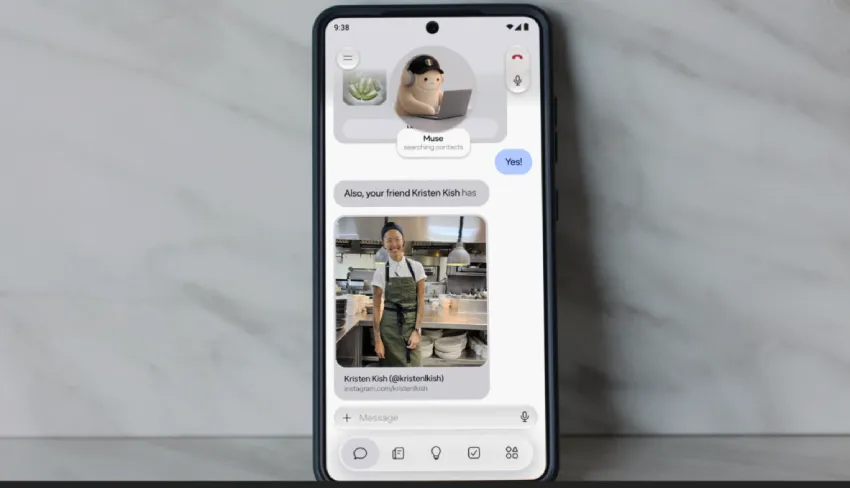

Meta 为 Muse 带来实时语音与表情虚拟形象
内容提要
Meta于2026年11月5日在美国Muse应用上线实时语音对话与表情虚拟形象,覆盖移动端、网页端和Mac。语音支持即时回复、打断及后台并行处理任务,可用于梳理想法、规划行程、面试排练等;虚拟形象随语气同步表情手势,提供数百种声音。技术上,Meta将语音与虚拟形象统一为流式系统,通过蒸馏把生成评估从120次降至2次,实现约870毫秒延迟、单块GB200支持12路并发,并加入不可见水印。语音功能后续将登陆AI眼镜与Muse Charm。
延伸解读
语音与虚拟形象统一流式系统的意义
Meta将语音与虚拟形象整合为同一套流式系统,语音模型生成的token同时驱动音频解码和虚拟形象生成,从而保持声音、唇动与表情同步。这种设计避免了分别处理语音和视觉可能带来的延迟与不一致,是实时对话体验流畅的关键。文章指出,虚拟形象模型消费同一数据流,说明系统层面的统一而非简单拼接。
蒸馏优化如何支撑实时交互
为达到实时性,Meta通过蒸馏将每块视频生成的评估次数从120次降至2次,削减约60倍,同时声称较好保留教师模型质量。这使得从用户话轮结束到同步语音+视频响应首字节延迟约870毫秒,单块GB200支持12路并发。这些数据表明,实时虚拟形象的服务成本与响应速度是工程优化的重点,而非单纯模型规模。
水印与年龄限制的防护考量
生成的虚拟形象视频包含持久、不可见的Meta Video Seal水印,且不增加实时延迟。这有助于标识AI生成内容,但文章未说明水印的检测方式或防篡改能力。此外,Muse仅面向18岁及以上用户,研究示例并非都反映应用内可用虚拟形象。读者需注意,演示能力与实际上线功能可能存在差异。
从应用到设备的扩展仍待验证
语音对话计划登陆AI眼镜与Muse Charm,后者是口袋大小、专为语音交互设计的设备。文章将眼镜端访问描述为免手操作,但未提供具体时间表或技术细节。当前实时语音与虚拟形象仅在美国地区移动端、网页端和Mac上线,设备版本仍处计划阶段。能否将同一会话体验延伸至不同形态设备,是下一个待解问题。
Q&A
Meta 的 Muse 应用什么时候在美国上线实时语音和虚拟形象功能?
Meta 于 2026 年 11 月 5 日宣布,实时语音对话与表情虚拟形象在美国地区的 Muse 应用中上线,覆盖移动端、网页端与 Mac。
Muse 的实时语音对话支持哪些交互方式?
Muse Realtime Voice 提供即时语音回复,允许用户打断智能体,并且智能体可以在对话进行的同时在后台继续处理任务,使讨论与委派的工作并行推进。
Muse 的虚拟形象是如何与语音同步的?
语音模型生成携带内容与表达方式的语音 token,音频解码器把 token 转为语音,虚拟形象模型消费同一数据流来生成视觉表演,从而保持声音、唇动与表情同步。虚拟形象是一个音频驱动的 Diffusion Transformer,条件输入包括 token 流、参考素材和滚动窗口的近期视频 latent,生成短小的因果视频块,每块的最新 latent 为下一块提供运动上下文。
Meta 如何降低虚拟形象生成的延迟?
Meta 通过蒸馏把每块的生成从 120 次带引导的教师模型评估减少到 2 次无引导的学生模型评估,相当于 60 倍的削减,同时较好地保留了教师模型的质量。最终实现从用户话轮结束到同步语音+视频响应的首字节约 870 毫秒延迟。
Muse 的实时虚拟形象在服务容量上有什么表现?
其优化使服务容量相对两步 BF16 基线提升八倍,并可在单块 GB200 上支持 12 路并发实时视频生成会话。
Muse 的虚拟形象视频有哪些安全防护措施?
生成的虚拟形象视频包含持久、不可见的 Meta Video Seal 水印,且不会增加实时延迟。此外,Muse 仅面向 18 岁及以上用户。
Muse 的语音功能未来会扩展到哪些设备?
Meta 表示,语音对话也将很快登陆 AI 眼镜与 Muse Charm。AI 眼镜端将提供免手操作访问,而 Muse Charm 是一款口袋大小的设备,专为与 Muse 语音交互而设计。
