


优化大型语言模型的性能和可扩展性
内容提要
大型语言模型(LLMs)在自然语言处理中扮演重要角色,但性能和可扩展性需要优化。优化性能可采用提示工程、检索增强生成和微调等技术。优化可扩展性可使用模型修剪、量化和蒸馏等技术。负载平衡、模型分片和缓存等技术也有助于提高性能和可扩展性。掌握这些技术可实现更准确、高效和可扩展的LLMs应用。
延伸解读
优化不是线性流程,需按问题类型选择技术
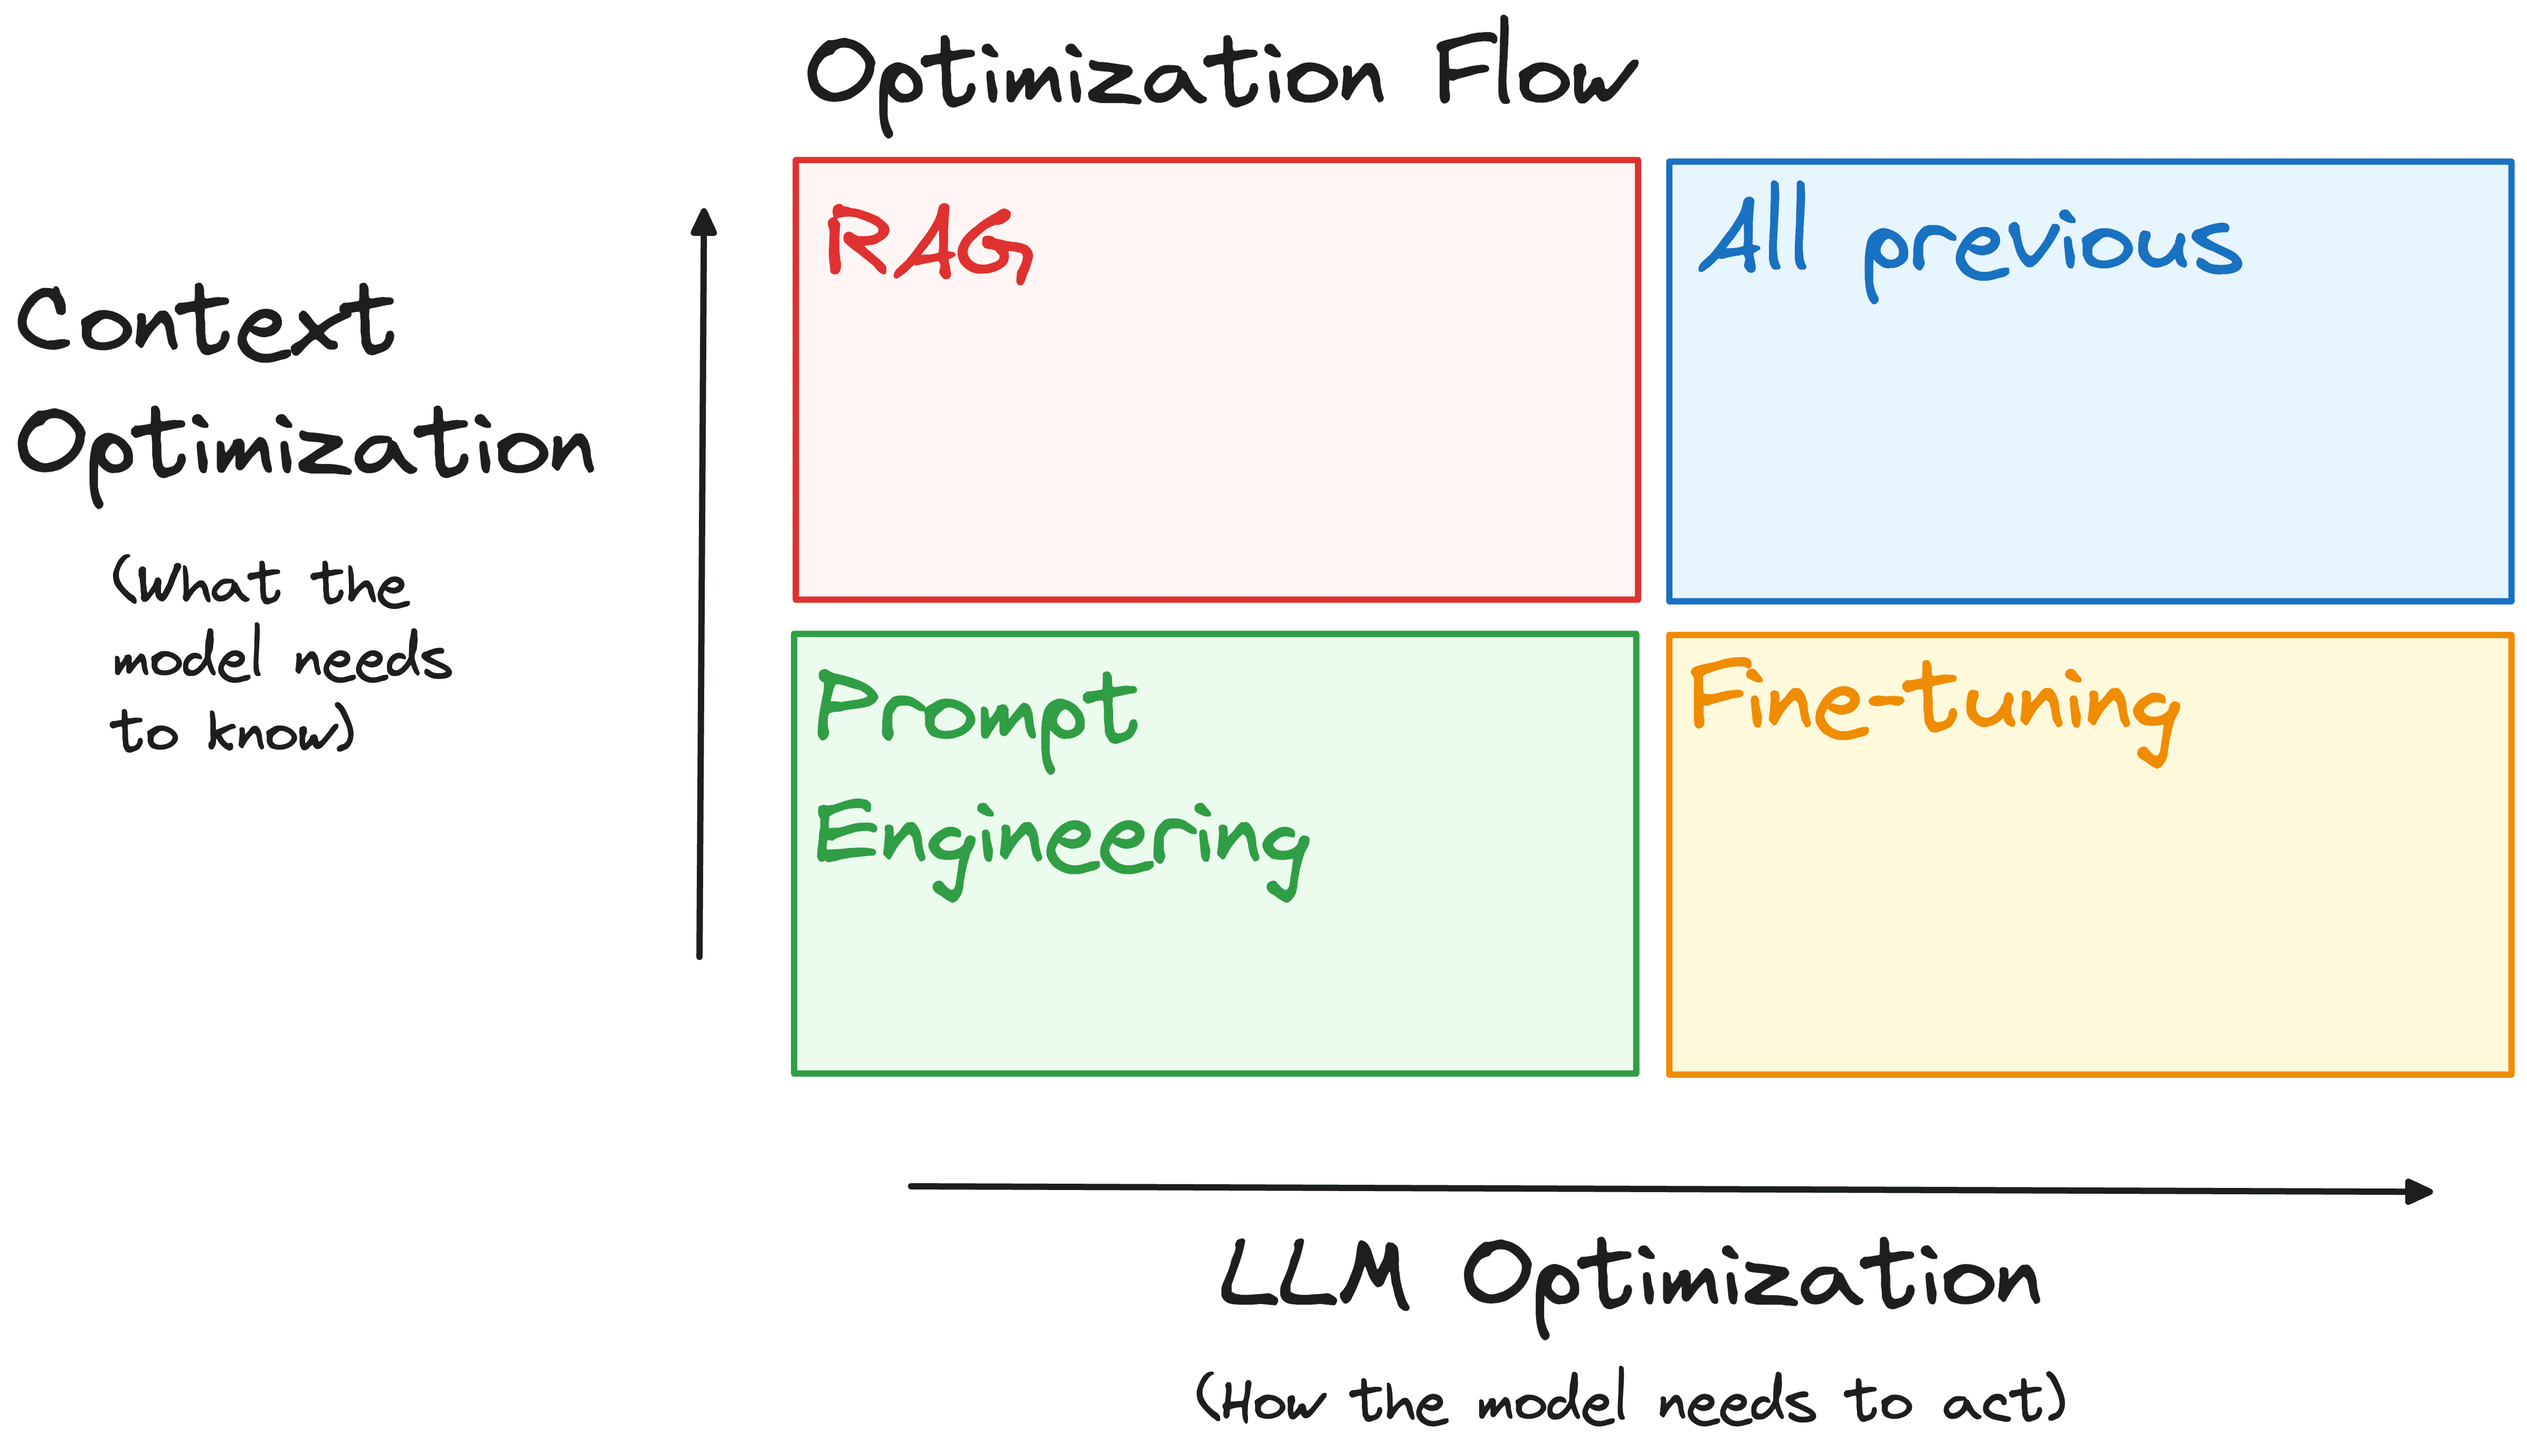
文章指出,优化LLM时常见的误区是认为提示工程、检索增强生成和微调必须按固定顺序进行。实际上,应根据问题性质从两个维度入手:如果模型缺乏正确信息或知识,应优先进行上下文优化;如果模型输出不正确、风格或格式不符,则应进行模型优化。这种分类方法能帮助开发者更高效地选择合适的技术组合。
推理阶段是性能优化的关键战场
文章强调,推理时间是LLM应用的核心挑战。以GPT-3为例,其1750亿参数相当于700GB的float32数据,运行需要大量内存和计算资源。因此,模型修剪、量化和蒸馏等技术能显著减少资源消耗。量化可将权重从32位浮点降至16位或8位,提升内存效率和推理速度;蒸馏则让小模型模仿大模型,如DistilBERT在保留97%语言理解能力的同时,速度提升60%,体积减小40%。
可扩展性依赖负载均衡、分片与缓存
当LLM应用从少量用户扩展到大规模使用时,可扩展性成为关键。文章提出三种主要技术:负载均衡通过水平扩展(如增加实例并用Kubernetes管理)或垂直扩展(升级CPU和内存)来分配请求;模型分片将模型分割到多个设备上并行处理,降低延迟,并支持GPU、TPU等异构硬件;缓存则存储频繁查询的结果,减少重复计算,尤其适合重复性高的场景。这些技术共同保障系统在高负载下仍能稳定运行。
Q&A
如何优化大型语言模型的性能?
可以通过提示工程、检索增强生成和微调等技术来优化大型语言模型的性能。
大型语言模型面临哪些主要挑战?
主要挑战包括准确性、资源消耗、延迟和可扩展性。
什么是模型修剪?
模型修剪是通过去除非必要参数来减少模型大小,从而降低计算负载。
如何提高大型语言模型的可扩展性?
可以通过负载平衡、模型分片和缓存等技术来提高可扩展性。
量化技术在大型语言模型中有什么作用?
量化技术将高精度变量转换为低精度格式,以提高内存效率和推理速度。
微调在大型语言模型优化中有什么重要性?
微调是修改基础模型以更好地适应特定任务的过程,能够提高模型在特定领域的准确性。
