


神经网络的结构
内容提要
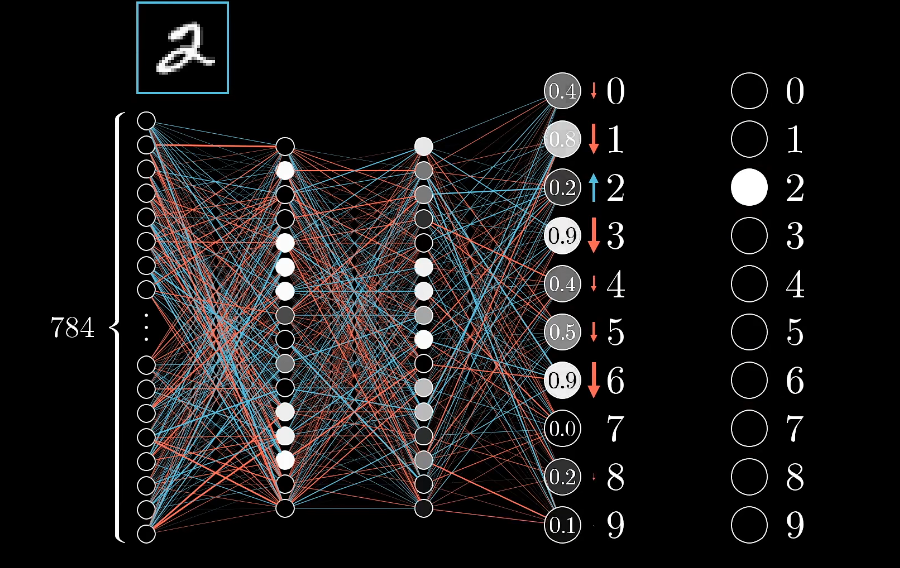
本文以识别28×28手写数字为例介绍神经网络结构:输入层784个神经元,含两层隐含层,输出层10个神经元代表0-9。神经元激活值由权重、偏置和激活函数计算。训练采用梯度下降法,通过代价函数衡量误差,利用反向传播算法求梯度,不断调整权重和偏置以降低代价,提升识别准确率。
延伸解读
从像素到概率:网络如何“看见”数字
输入层784个神经元对应28×28像素的灰度值,值越大像素越白。输出层10个神经元的激活值在0到1之间,表示网络认为图像是某个数字的可能性。中间两层隐含层各16个神经元,是示例中的选择,并非固定规则。这种结构属于经典的多层感知器,适合入门理解神经网络的基本运作方式。
权重与偏置:可调节的“旋钮”
每个连接都有权重,表示上层神经元对下层的影响强度;每个下层神经元还有偏置,决定加权和需要多大才能让神经元有意义地激发。加权和经过激活函数(如Sigmoid)映射到0到1之间,得到激活值。训练就是调整这些参数,使网络输出更接近目标。
梯度下降与反向传播:如何找到调整方向
代价函数衡量输出与目标的差距,梯度下降通过计算梯度并沿负方向小步调整参数来降低代价。反向传播则高效计算这个梯度:从输出层开始,根据每个样本的期望变化,逐层向前传递对激活值的敏感度,最终得到所有权重和偏置的偏导。实际中常用随机梯度下降,将数据分组计算近似梯度,以降低计算量。
激活函数的选择与常见疑问
早期常用Sigmoid将加权和映射到0到1,后来发现ReLU效果更好。但ReLU的输出并不限于0到1,这可能会让读者困惑。文章指出这一点,但未深入解释原因。理解不同激活函数的特性,有助于在实际中做出合适选择。
Q&A
神经网络中神经元和激活值是什么?
神经元可以看作一个装有数字的容器,通常值在0到1之间。激活值就是神经元中装的值,表示该神经元的兴奋程度。例如,输入层神经元的激活值对应图片像素的灰度值,输出层神经元的激活值表示网络认为输入图像属于某个数字的可能性。
神经网络如何从输入层计算到输出层?
神经网络通过层间连接计算激活值。每一层的每个神经元与上一层的所有神经元相连,每条连接有一个权重。计算时,将上一层的激活值与对应权重相乘后求和,再加上偏置,然后通过激活函数(如Sigmoid或ReLU)映射,得到该神经元的激活值。这个过程从输入层逐层传递到输出层。
梯度下降法是如何训练神经网络的?
梯度下降法通过不断调整权重和偏置来最小化代价函数。首先随机初始化所有参数,然后计算代价函数对每个参数的梯度(即负梯度方向),沿着负梯度方向按学习率步长更新参数,循环迭代,使代价逐渐降低,从而提高网络识别准确率。
反向传播算法的作用是什么?
反向传播算法用于高效计算代价函数对所有权重和偏置的梯度。它基于链式法则,从输出层开始,逐层反向计算代价对每层激活值的敏感度,进而求出对权重和偏置的偏导数。这些梯度用于梯度下降法更新参数,以最小化代价函数。
什么是随机梯度下降?
随机梯度下降是梯度下降的一种变体,用于提高计算效率。它不每一步都使用全部训练样本计算梯度,而是将训练数据打乱分成小批量,每次用一个小批量计算梯度并更新参数。这样得到的梯度是真实梯度的近似,但计算量大大降低。
神经网络中常用的激活函数有哪些?
常用的激活函数包括Sigmoid和ReLU(线性整流函数)。早期多使用Sigmoid将加权和映射到0到1之间,后来发现ReLU效果更好。ReLU的定义是f(x)=max(0, x),它不会将输出限制在0到1之间,但能缓解梯度消失问题,加速训练。
