

Sora技术报告 视频生成模型作为世界模拟器 笔记
内容提要
OpenAI的视频生成模型Sora能够生成高保真度、各异的视频,使用视觉补丁作为表示形式,并通过变压器架构进行操作。它能够根据文本提示生成视频,接受现有图像或视频作为输入,并具有一些有趣的模拟能力。扩大视频模型的规模是构建物理世界通用模拟器的有前景的路径。
延伸解读
技术路线:从语言模型到视觉补丁
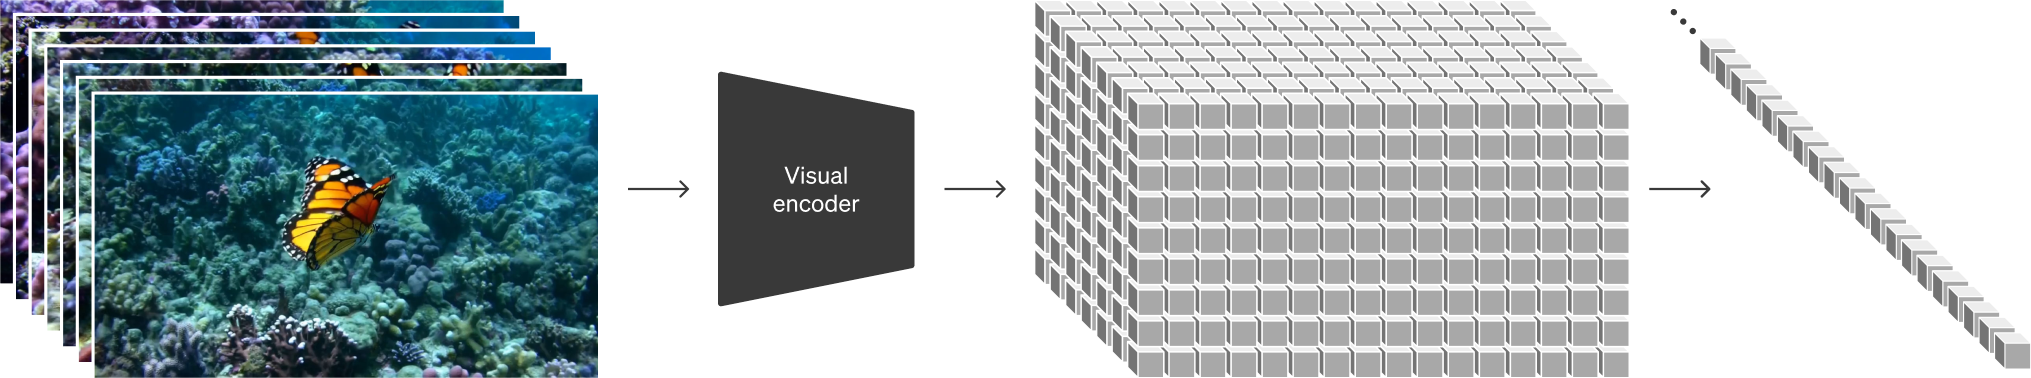
Sora的核心思路是将视频压缩为低维潜在空间中的时空补丁,再通过Transformer架构处理。这与大型语言模型将文本转化为token的方式类似,作者指出这体现了OpenAI将视觉数据“token化”的一贯策略。视觉编码器可能借鉴了I3D等视频理解模型,而压缩网络则类似于Stable Diffusion中的VAE,在潜在空间进行扩散生成。
扩散模型与灵活采样
Sora是一个扩散模型,通过预测原始干净补丁来训练,接收噪声补丁和文本条件信息。与以往将视频调整到固定尺寸不同,Sora在原生大小的数据上训练,支持可变持续时间、分辨率和宽高比。这种灵活性改善了构图和画面布局,使生成视频更自然。作者认为这类似于CLIP的大规模训练,但具体机制仍需更多论文验证。
模拟能力与局限
Sora展现出3D一致性、长期连贯性和对象持久性等新兴模拟能力,能模拟简单交互和数字世界(如《我的世界》)。这些能力纯粹是尺度现象,没有明确的归纳偏差。然而,Sora仍存在局限,如无法准确模拟玻璃破碎等物理过程,长时间样本中可能出现不连贯或对象自发出现。这表明视频模型扩展是通向通用模拟器的有前景路径,但并非终点。
Q&A
Sora是什么?它有什么主要特点?
Sora是OpenAI的视频生成模型,能够生成高保真度、时长和分辨率各异的视频,最长可达一分钟。它使用视觉补丁作为表示形式,通过变压器架构操作,可根据文本提示生成视频,并接受现有图像或视频作为输入。
Sora是如何处理视频数据的?
Sora将视频压缩成低维潜在空间,并将表示分解为时空补丁。它通过训练一个降低视觉数据维度的网络,在压缩的潜在空间内进行训练和生成视频,同时训练解码器将潜在表示映射回像素空间。
Sora在视频生成方面有哪些扩展能力?
Sora能够根据文本提示生成视频,接受图像或视频作为输入进行编辑,在时间上向前或向后扩展视频,连接两个视频进行插值过渡,还能生成分辨率高达2048x2048的图像。
Sora展示了哪些模拟能力?
Sora展示了3D一致性、长期连贯性和对象持久性,能够模拟与世界简单交互(如画家留下笔触、吃汉堡留下咬痕),还能模拟数字世界,例如零样本控制《我的世界》中的玩家。
Sora目前有哪些局限性?
Sora不能准确模拟许多基本物理过程,如玻璃破碎;某些交互(如吃食物)不总是产生正确的对象状态变化;长时间样本中可能出现不连贯或对象自发出现等故障模式。
Sora的技术路线对构建世界模拟器有何意义?
OpenAI认为,扩大视频生成模型的规模是构建物理世界通用模拟器的一个有前景的路径。Sora的能力表明,视频模型的持续扩展有望开发出模拟物理和数字世界及其中的对象、动物和人的高性能模拟器。
