


TUI如何借助Amazon Bedrock为100多个团队规模化开展威胁建模
内容提要
TUI安全团队仅4人,却需服务100多个产品团队,人工威胁建模每次耗时4–6小时,每月仅能完成3–4次。团队借助Amazon Bedrock(Claude Sonnet 4.5)与AgentCore构建智能体工作流,通过元数据筛选标准(上下文缩减94%)、自校正威胁生成与联网搜索缓存实现自动化威胁建模。上线后单次评估时间最多减少70%,月处理量增至10–12次,威胁识别达40–60个,标准应用100%一致,并已在全公司推广。
延伸解读
元数据筛选:小团队应对大知识库的关键
TUI最初尝试将全部192项安全标准直接放入提示词,但内容超限且模型难以遵循指令。转而采用元数据驱动选择:为每份标准预生成关键词、组件类型、STRIDE类别和相关性评分,运行时仅加载最相关的16项标准,上下文从338KB降至21KB,缩减94%。这一做法比RAG更可预测、易调试,尤其适合标准数量有限且部分强制适用的场景。对于知识库规模可控的团队,元数据筛选是值得优先考虑的上下文管理策略。
自校正工作流如何提升威胁识别数量与一致性
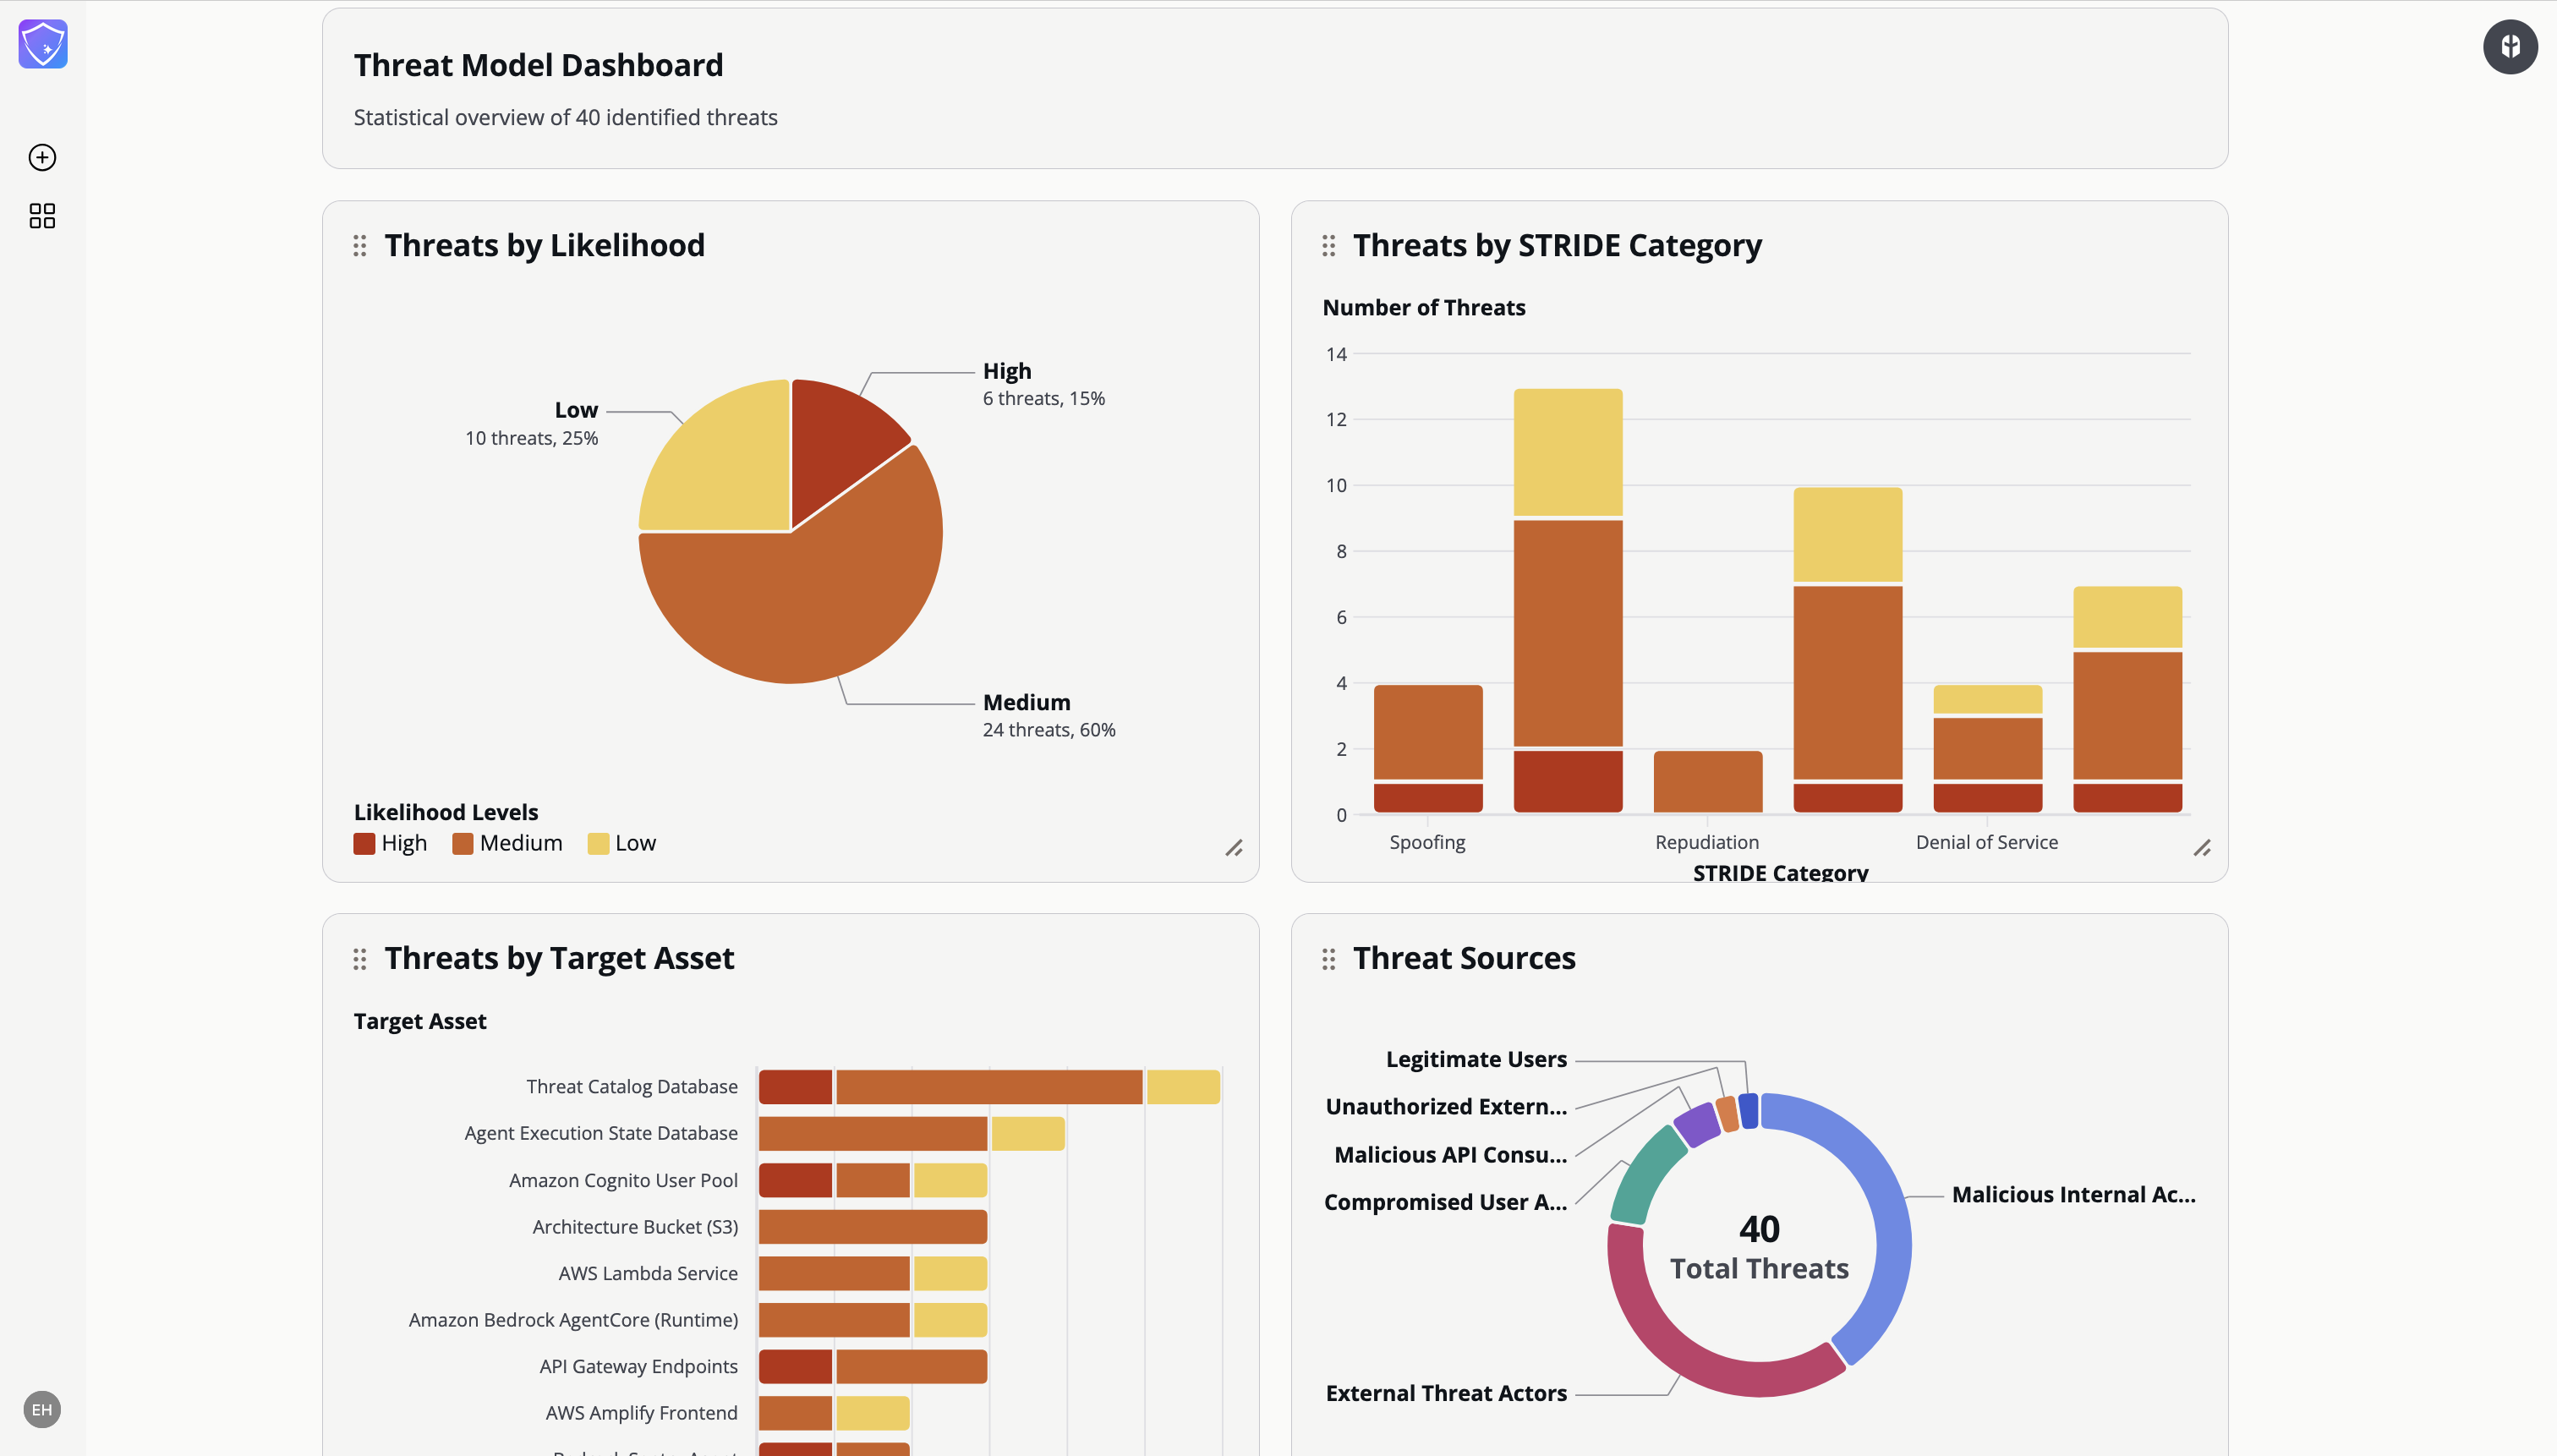
威胁生成节点采用ReAct模式,智能体可自主调用添加、删除、读取威胁目录和运行差距分析四类工具。系统设置工具预算:三次生成后强制进行差距分析,并验证威胁目录非空、覆盖全部六类STRIDE、至少执行一次差距分析。这种“生成-审查-补缺”的循环模拟人类专家工作方式,使单架构威胁数从人工的30–40个提升至40–60个,同时确保标准应用100%一致。
联网搜索与缓存设计兼顾时效与效率
为弥补内部标准未覆盖的技术,工作流对架构中识别的每项技术生成两个搜索查询,分别针对已知问题和加固最佳实践,并限定OWASP、NIST、CWE等权威来源。查询仅使用组件名称,不包含架构细节或客户数据。S3缓存设置7天TTL,键基于排序后的组件名哈希,避免模型生成描述波动影响命中率。实际缓存命中率达70–80%,命中时响应低于100毫秒,远快于实时搜索的2–3秒。
人工对比节点:校准风险评分的反馈闭环
系统包含可选的SME对比节点:工程师上传人工威胁评估PDF,工作流提取威胁、归一化风险等级,并与AI生成威胁做语义匹配。当双方对同一威胁的严重性评级不一致时,系统标记差异并展示双方评级及专家理由。这一机制不仅提供人工复核入口,还能长期校准系统的风险评分,暴露AI持续高估或低估的领域。对于希望引入AI辅助但保留专家判断的团队,这种设计提供了可操作的信任建立路径。
Q&A
TUI的安全团队规模多大,为什么需要自动化威胁建模?
TUI安全团队只有4名工程师,却要服务100多个数字产品团队。人工威胁建模每次耗时4–6小时,每月仅能完成3–4次,导致大量积压,无法将威胁建模设为所有新服务的强制要求。
TUI的AI威胁建模系统用了哪些AWS服务?
系统使用Amazon Bedrock(Claude Sonnet 4.5)进行威胁分析,Amazon Bedrock AgentCore runtime托管智能体工作流,AWS Lambda做后端计算与LangGraph编排,DynamoDB管理状态,S3存储架构图与缓存,Amplify托管React前端,Cognito做认证。
TUI如何解决将全部安全标准加载到提示词中的问题?
最初尝试加载全部192项标准(338KB)失败,因超出令牌限制且模型混淆。后来改为元数据驱动选择:为每份文档预生成关键词、组件类型、STRIDE类别和相关性分数,运行时模型仅从约60KB元数据中选出最相关的16项标准,上下文从338KB降至21KB,减少94%。
威胁生成节点如何实现自我校正?
该节点采用ReAct模式的LangGraph子图,智能体拥有添加威胁、删除威胁、读取威胁目录、运行差距分析四个工具,自主决定调用顺序。生成初始威胁后对照TUI标准自我审查,经过三次生成调用后强制进行差距分析,验证节点检查威胁目录非空、覆盖全部六类STRIDE、至少执行一次差距分析,不通过则反馈并循环。
系统如何利用网络搜索获取最新威胁情报?
针对架构中识别的每项技术(如Keycloak、Kong、Redis),系统生成两个搜索查询:已知问题和加固最佳实践,目标为OWASP、NIST、CWE等权威来源。调用前检查S3缓存(7天TTL),仅使用技术组件名称,不包含架构细节或客户数据。缓存命中率达70–80%,命中时响应低于100毫秒,而实时搜索需2–3秒。
上线后TUI的威胁建模取得了哪些量化效果?
单次评估时间最多减少70%,月处理量从3–4次增至10–12次(增长300%),标准应用100%一致,每个架构识别40–60个威胁(人工为30–40个)。系统在PoC移交后30天内投入生产,并已推广为所有团队的强制要求。
系统如何与人工专家评估进行对比验证?
工作流包含可选节点,工程师上传人工创建的威胁评估PDF,系统用Claude提取威胁、将风险评级归一化为LOW/MEDIUM/HIGH/CRITICAL,并通过语义相似度与AI生成的威胁匹配。当AI与专家对严重性判断不一致时,系统标记差异并显示双方评级及专家理由,用于校准风险评分。
