


生产环境中的向量搜索:扩展、高可用与调优指南
内容提要
向量搜索生产环境部署要点:合理配置内存与索引,热数据常驻内存、冷数据落盘,并创建有效载荷索引;大规模导入时可暂停HNSW索引以加速;集群至少三节点、副本数不低于2,并做好分片均衡;定期备份并测试恢复;启用TLS、RBAC与最小权限;持续监控延迟与资源,避免常见配置陷阱。
延伸解读
内存分层:热数据常驻,冷数据落盘
文章强调,生产环境中向量索引若超出内存,会频繁触发磁盘读取,导致延迟飙升。Qdrant v1.19 起,可为稠密向量、HNSW 索引、量化向量、载荷及载荷索引分别设置内存参数:pinned 常驻内存、cached 启动时预热、cold 留在磁盘。早期版本则用 on_disk 和 memmap_threshold 实现类似效果。合理分层能减少查询时的磁盘访问,平衡性能与成本。
大规模导入:暂停 HNSW 索引以加速
当导入海量数据时,若保持 HNSW 索引开启,每次插入都会触发全量索引更新,导致 CPU 飙升、服务超时。文章建议在大批量上传期间暂时禁用 HNSW 索引构建,待数据全部插入后再一次性重建。同时可增加索引线程、使用批量写入、在低峰期调度索引,并注意 indexed_only 参数可能带来的最终一致性权衡。
高可用与扩展:至少三节点、副本数不低于2
生产集群应至少使用三个节点,以提供故障转移和法定人数,避免单点故障。副本因子至少设为2,确保数据冗余和读写可用性。扩展时需注意分片均衡,避免热点分片导致单节点过载。新增节点后,应重新分片以均匀分布数据,防止内存溢出。此外,生产环境应与开发/测试集群隔离,避免资源争抢。
备份与安全:定期测试恢复,启用 TLS 和 RBAC
灾难恢复应使用完整备份而非快照,并定期测试恢复流程,避免版本不匹配或数据不完整。安全方面,生产环境必须启用 TLS/HTTPS 加密传输,并配置基于角色的访问控制(RBAC),遵循最小权限原则。使用作用域 API 密钥或 JWT 令牌,避免服务过度授权。同时,持续监控延迟、资源使用和索引速度,以便及早发现瓶颈。
Q&A
生产环境部署向量搜索时,如何优化内存和索引配置以提升搜索性能?
确保热数据集常驻内存,冷数据可移至磁盘。自Qdrant v1.19起,可为每个结构(密集向量、HNSW索引、量化向量、载荷、载荷索引)设置内存参数:pinned(永久驻留内存)、cached(启动时预热到磁盘缓存)、cold(留在磁盘直到读取)。早期版本使用on_disk和memmap_threshold。同时,为所有用于过滤或排序的字段创建载荷索引,避免全扫描。
大规模导入数据时,如何加速索引过程?
在大规模上传期间,可以禁用HNSW索引构建,待所有记录插入后一次性重建索引。考虑使用专门的摄取管道,批量写入并在低流量时段调度索引。如果无低流量窗口,可调整indexing_threshold以平衡更新与索引。其他方法包括:增加索引线程(超过16核时)、使用批量进程(50-60个并发进程)、批量查询以减少网络往返。
如何为向量搜索集群设计高可用架构?
至少使用3个节点以确保故障转移,减少停机风险。设置副本数至少为2,以容忍节点故障而不丢失可用性。将生产环境与开发/测试环境隔离,使用独立集群避免资源竞争。遵循Raft协议维护数据一致性。
向量搜索生产环境如何备份和恢复数据?
对于灾难恢复,应使用完整备份而非快照。快照主要用于在集群间移动数据,而备份用于恢复整个集群状态。定期设置快照或备份,并始终测试恢复过程。对于大型部署,将备份存储在节点外或远程仓库,并确保恢复带宽充足。保留索引配置(如量化设置或HNSW参数)以避免恢复后版本不匹配。
生产环境向量搜索需要哪些安全措施?
启用TLS/HTTPS加密传输中的数据,配置客户端与数据库及集群节点间的安全通信。设置基于角色的访问控制(RBAC),通过作用域API密钥或JWT令牌限制权限,遵循最小权限原则。避免过度授权,确保只有必要权限。
如何监控和调优生产环境中的向量搜索性能?
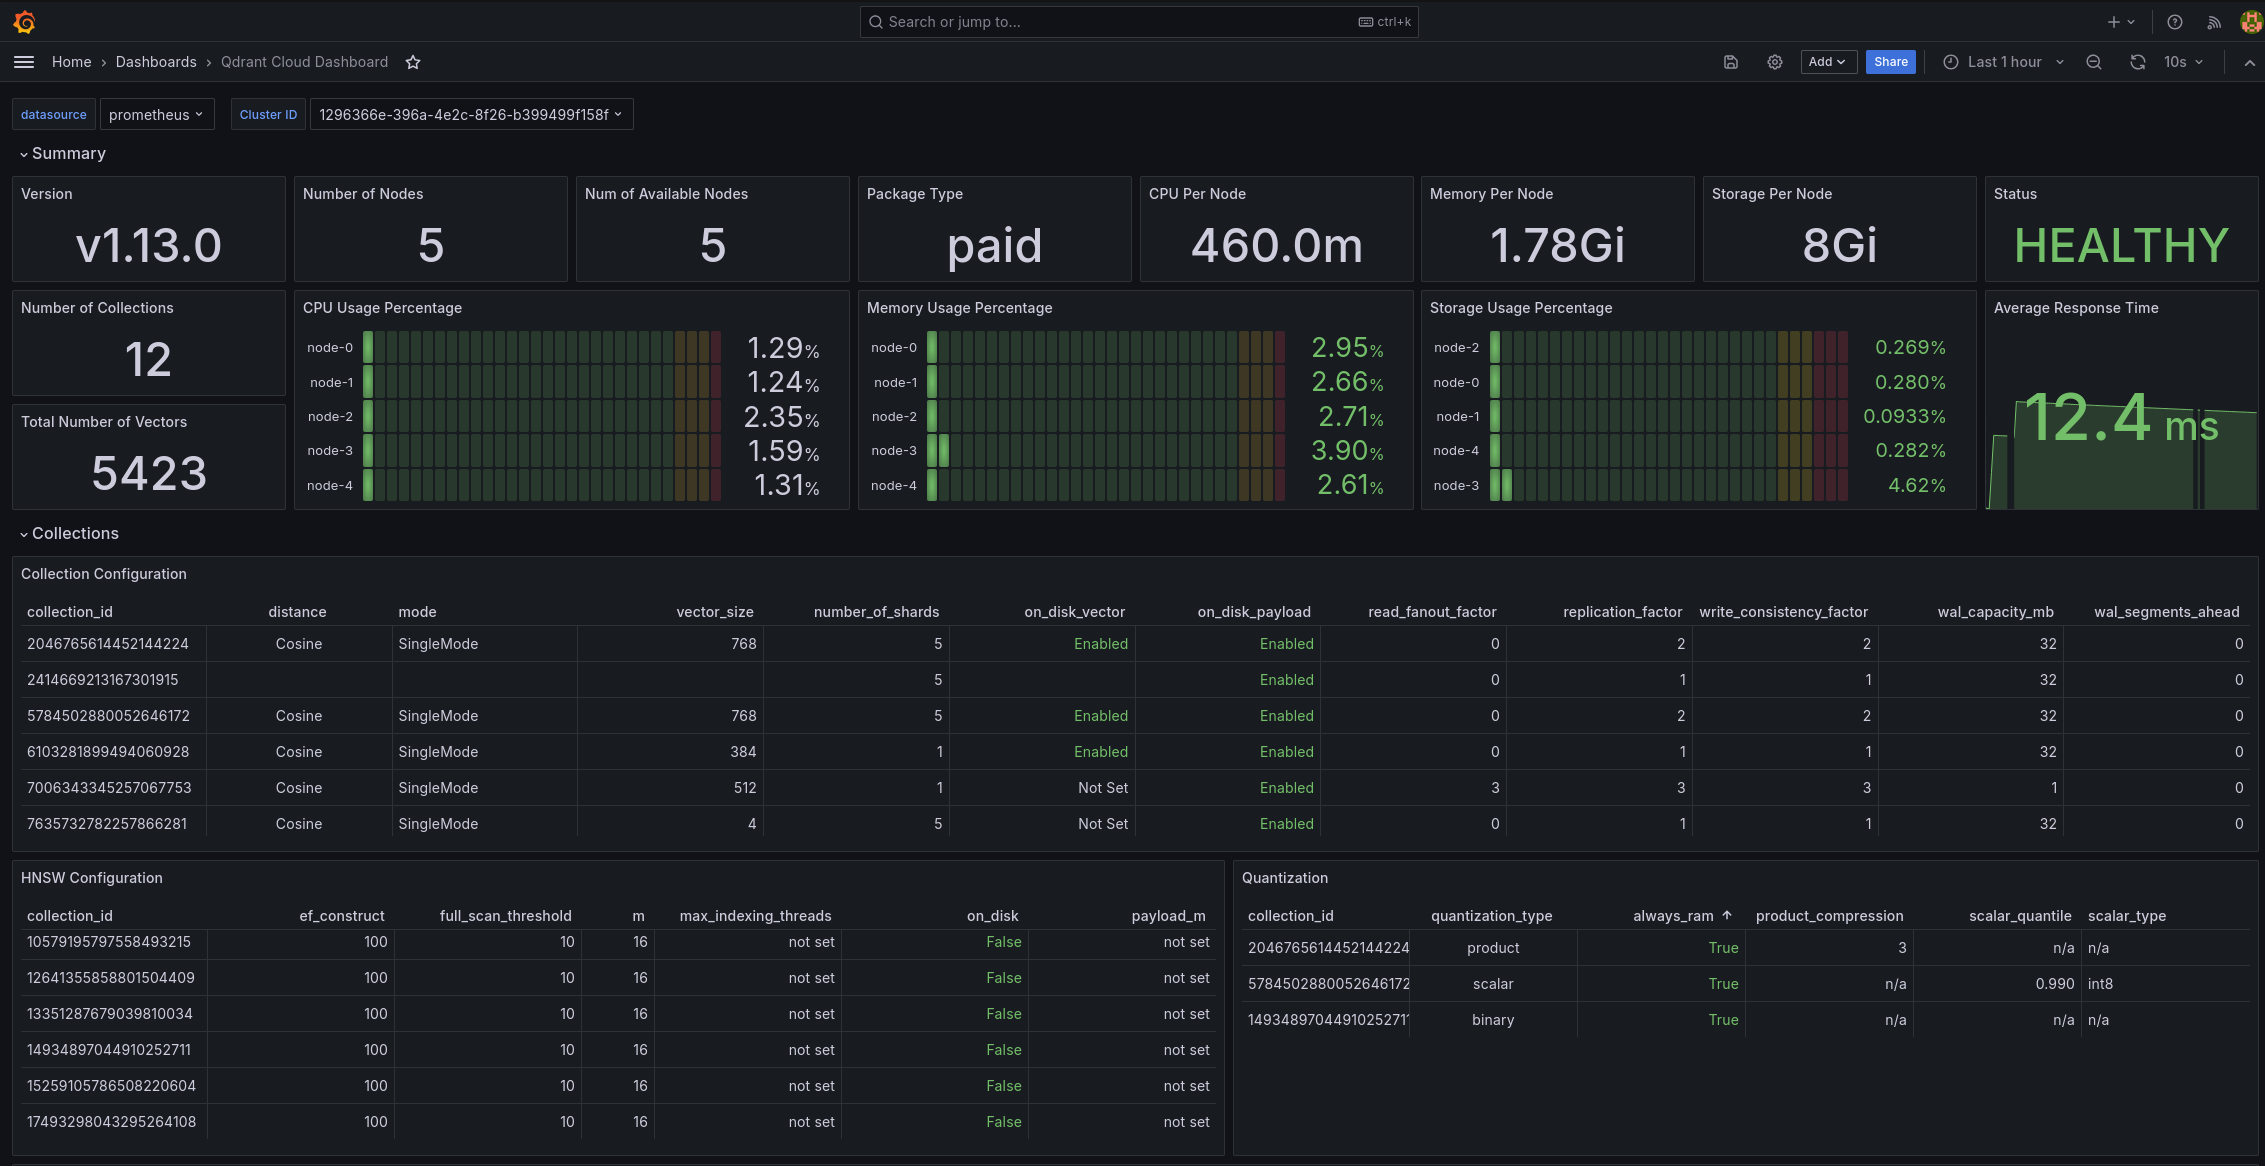
启用遥测和监控,跟踪延迟、吞吐量和优化统计。关注P99延迟而非平均延迟,监控CPU、内存、磁盘I/O和索引速度。使用真实数据或历史数据进行负载测试,逐步增加流量至预期生产负载。测试冷启动行为,建立基线。结合读写操作(如80%读20%写)模拟真实负载。
