
在生产环境 Scikit-LLM 流水线中监控嵌入漂移
内容提要
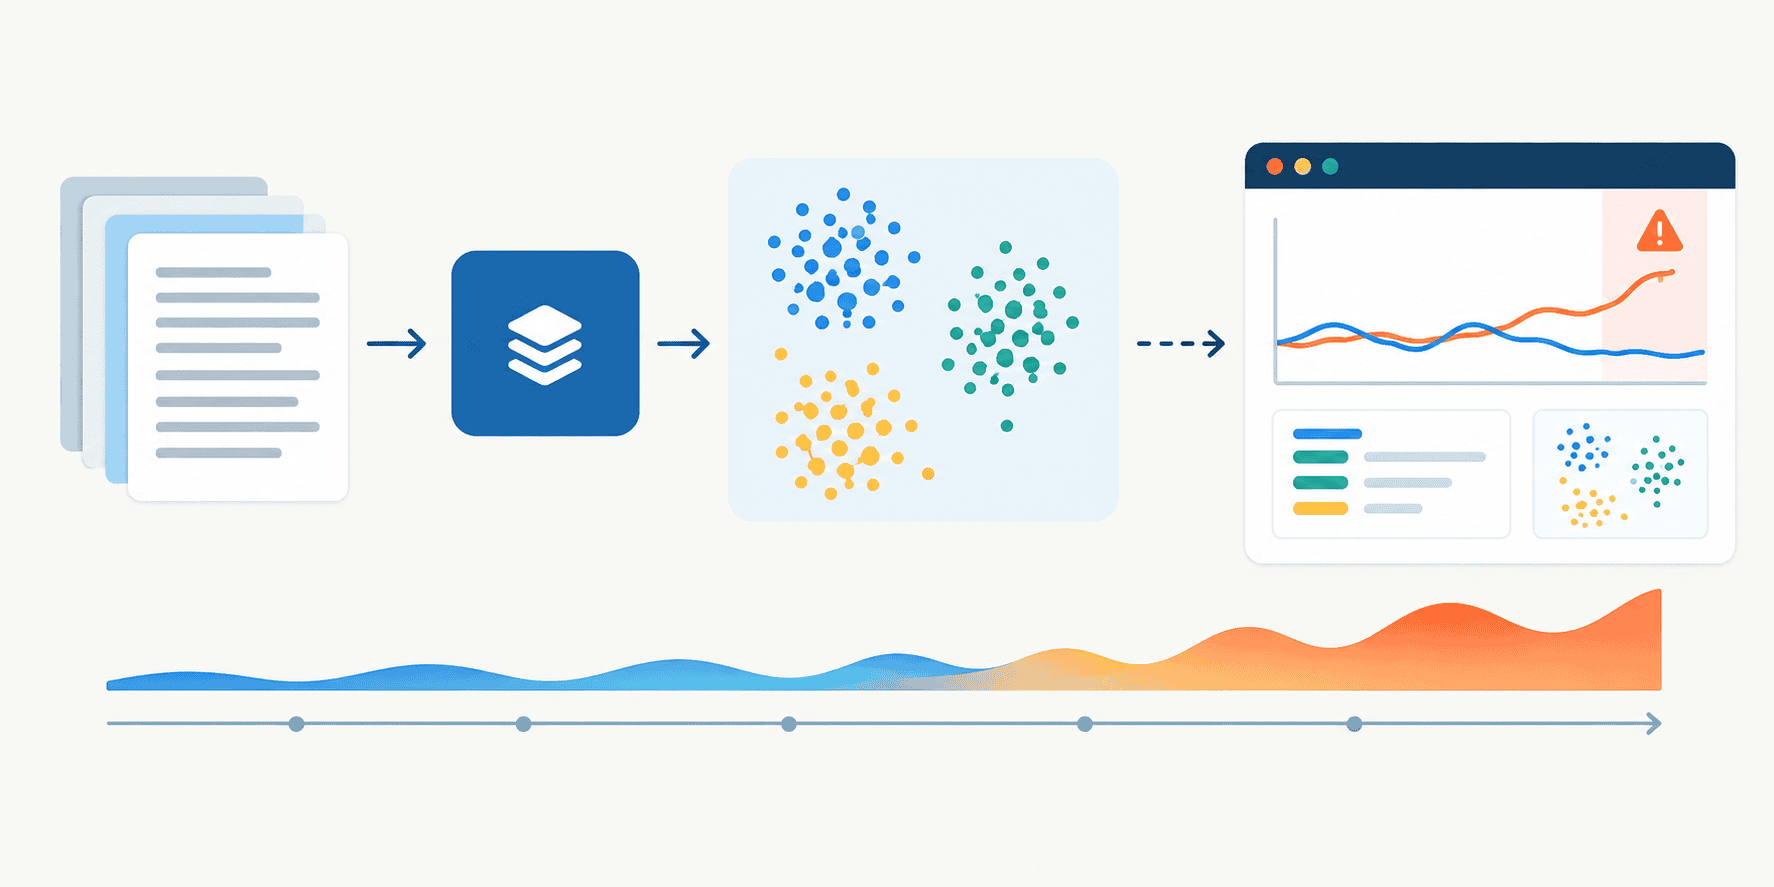
本文介绍生产环境中LLM嵌入漂移的检测方法,重点讲解两种技术:基于模型的检测(训练随机森林分类器区分基线与生产嵌入,ROC-AUC超阈值即告警)和质心距离法(计算两组嵌入质心的余弦距离)。文中用模拟384维嵌入及Scikit-LLM结合SentenceTransformer生成的真实文本嵌入演示,均成功检测到漂移。
延伸解读
嵌入漂移检测的必要性
生产环境中的LLM面临用户行为和数据分布的变化,这些变化会反映在嵌入向量中。传统的表格数据漂移检测方法在高维嵌入上往往失效,因此需要专门针对嵌入的检测技术。本文介绍的两种方法——基于模型的检测和质心距离法——提供了实用的监控手段,帮助判断模型是否需要更新。
基于模型的检测:原理与阈值
该方法训练一个随机森林分类器来区分基线嵌入和生产嵌入。如果分类器能轻易区分两者(ROC-AUC高),则表明存在漂移。文中使用ROC-AUC阈值0.65作为告警线,在模拟数据上得到0.970,在真实文本嵌入上得到1.000,均成功触发告警。阈值需要根据具体场景调整,以平衡灵敏度和误报率。
质心距离法:简单但损失细节
质心距离法计算两组嵌入均值向量的余弦距离,计算成本低,但将高维分布压缩为单一中心点,会丢失多模态或结构变化等信息。文中模拟数据得到0.9811,真实文本嵌入得到0.8719,均超过阈值0.05。阈值需根据基线方差调优,且该方法可能掩盖复杂的漂移模式。
实际应用中的注意事项
在真实场景中,嵌入漂移通常由主题变化引起,但距离值可能不如模拟数据极端。使用Scikit-LLM结合SentenceTransformer生成嵌入时,需注意API配置和模型选择。此外,漂移检测应结合业务上下文,避免仅依赖单一指标,并定期审查阈值和检测频率。
Q&A
什么是嵌入漂移,为什么在生产环境的LLM中需要监控它?
嵌入漂移是指生产环境中LLM接收到的数据(通常编码为数值向量嵌入)的分布随时间发生变化,导致模型性能下降。监控嵌入漂移至关重要,因为它能帮助判断部署的模型何时需要更新或重新训练。
检测嵌入漂移有哪些主要技术方法?
主要有三种技术:1)基于模型的检测:训练一个二分类器区分基线数据和生产数据,通过ROC-AUC等指标判断漂移;2)质心距离法:计算基线嵌入和生产嵌入的质心之间的余弦距离;3)降维结合统计检验:使用UMAP或PCA降维后,应用Kolmogorov-Smirnov等统计检验。
如何用基于模型的方法检测嵌入漂移?具体步骤是什么?
步骤包括:1)将基线嵌入标记为0,生产嵌入标记为1;2)合并数据集并划分训练集和测试集;3)训练一个随机森林分类器(如n_estimators=50, max_depth=5);4)计算测试集上的ROC-AUC分数;5)若ROC-AUC超过阈值(如0.65),则触发漂移告警。
质心距离法检测嵌入漂移的原理和优缺点是什么?
原理是计算基线嵌入和生产嵌入的质心(均值向量)之间的余弦距离,距离越大表示漂移越明显。优点是计算成本低;缺点是丢失了分布细节,可能掩盖多模态偏移或结构变化。
在Scikit-LLM中如何结合SentenceTransformer生成真实文本嵌入并检测漂移?
首先配置Scikit-LLM使用Groq API,然后使用SentenceTransformer(如'all-MiniLM-L6-v2')将文本编码为嵌入。接着,可以应用基于模型的检测(训练随机森林分类器,计算ROC-AUC)或质心距离法(计算余弦距离)来检测漂移。示例中,由于主题差异大,两种方法都成功检测到漂移。
在模拟嵌入和真实文本嵌入上,漂移检测的结果有何不同?
在模拟的384维随机嵌入中,基于模型的检测ROC-AUC达到0.970,质心余弦距离为0.9811;在真实文本嵌入(SentenceTransformer生成)中,ROC-AUC为1.000,质心余弦距离为0.8719。真实文本嵌入的余弦距离较低,因为随机数据可能导致更极端的距离值。
