


MemCurrent:为生产级智能体设计持久记忆
内容提要
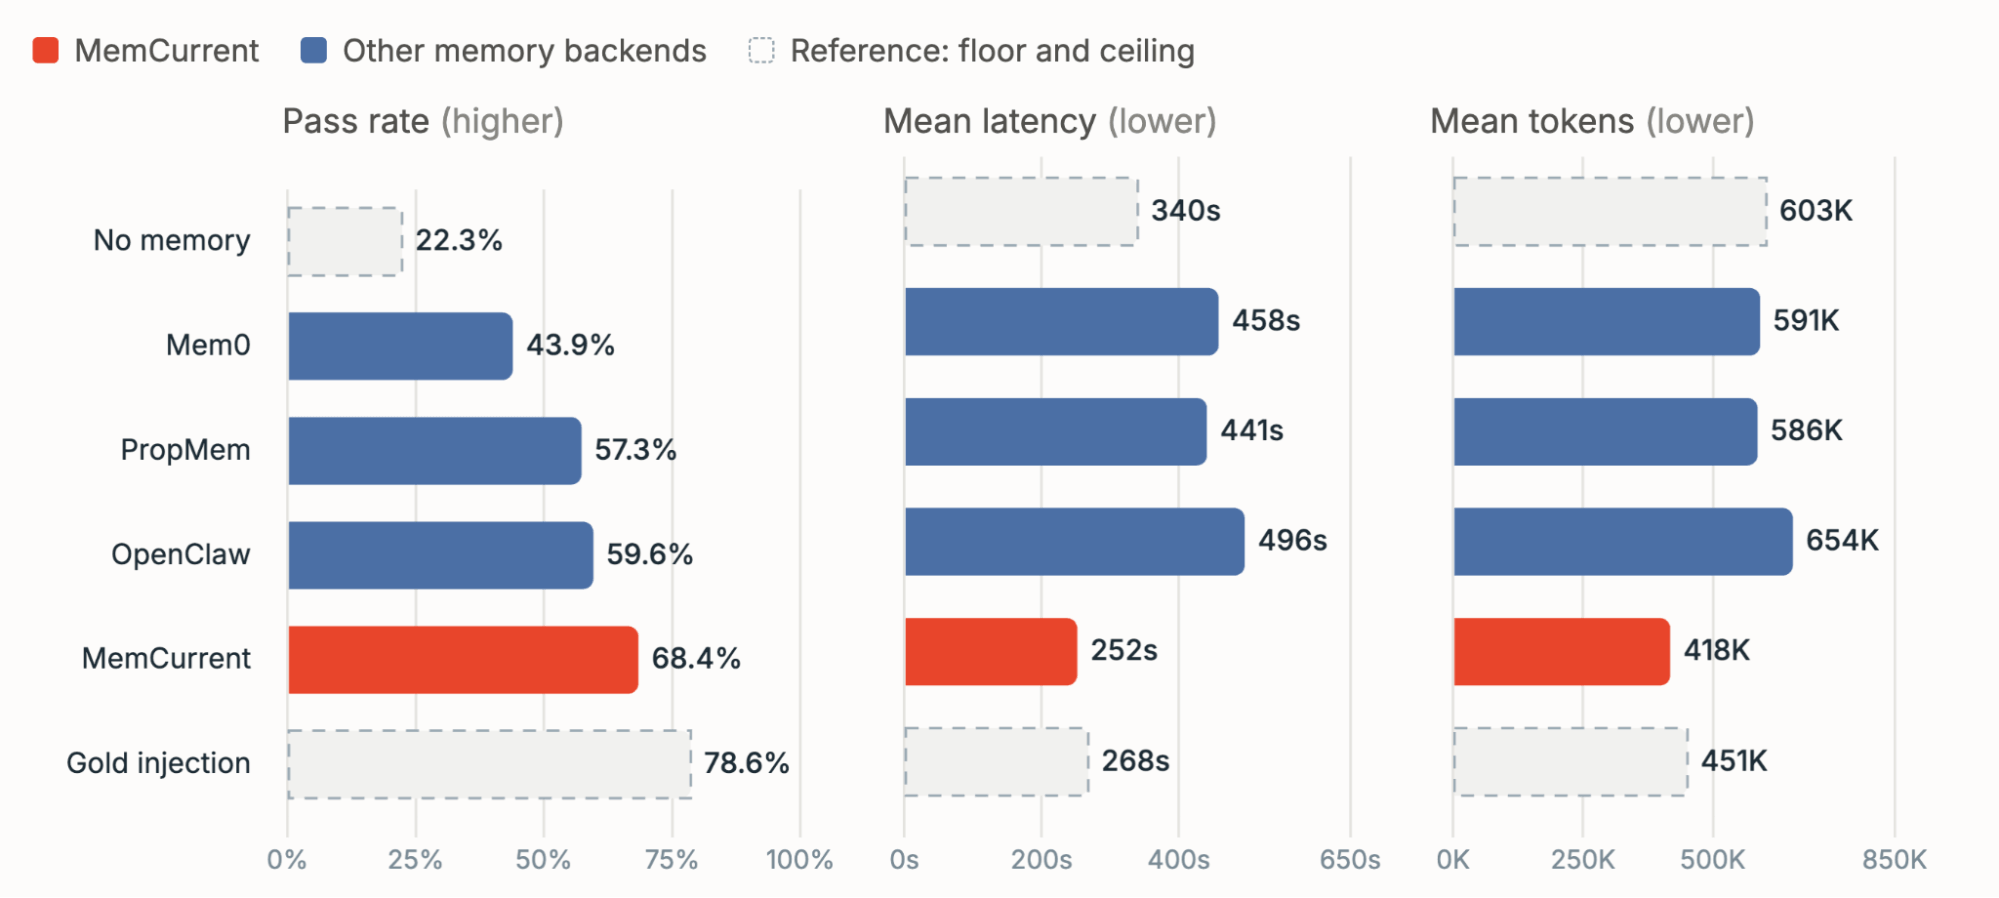
Databricks推出MemCurrent持久记忆架构,用于解决生产级智能体的质量与效率权衡问题。该架构结合原始会话的情景记忆与提炼知识的派生记忆,通过插件自动读写、工具按需调用、离线“做梦”流程整合三种方式运作。在内部企业基准上,通过率提升至无记忆的三倍,同时token减少31%、速度提升26%;在开源基准上以约十二分之一token达到全上下文性能。
延伸解读
记忆不是越多越好:分层设计是关键
MemCurrent 将记忆分为原始会话的情景记忆和提炼知识的派生记忆,并用自动生成的索引在会话开始时告知智能体“知道什么”。消融实验显示,仅用情景记忆通过率仅 35.8%,而派生记忆单独可达 66.1%,两者结合提升至 68.4%。这说明生产级记忆的核心不是堆叠历史,而是通过结构化提炼和索引引导智能体按需检索,避免无关或过时上下文干扰。
在线工具与离线“做梦”分工明确
文章对比了两种派生记忆提取方式:在线工具(如 add_memory)让显式请求立即生效,离线“做梦”管道则在后台提炼隐式经验并清理冲突、合并重复。单独使用离线管道通过率 63.5%,在线工具 53.9%,两者结合最高达 66.1%。这提示开发者:即时修正和后台整合缺一不可,前者保证响应性,后者维持记忆库的一致性与新鲜度。
企业基准揭示真实场景的差距
开源基准多基于合成对话,而 MemCurrent 团队用真实 Genie 会话构建了内部基准,包含 114 个测试用例、29 个用户和 2233 段历史。在该基准上,MemCurrent 通过率 68.4%,远高于 Mem0 的 43.9%,并将无记忆的 22.3% 提升三倍,同时延迟和 token 消耗更低。这表明在长尾、多步骤的企业任务中,记忆架构的优劣会被放大,通用基准的高分未必能直接迁移。
记忆可跨智能体复用,但需注意边界
文章指出,MemCurrent 构建的知识库不绑定单一智能体或 LLM,可随用户迁移到新智能体,并可能成为组织内共享知识的基础。不过,这一方向仍在探索中。读者应留意:跨智能体复用意味着记忆的准确性和时效性要求更高,错误或过时的记忆可能被扩散;同时,文章未披露具体的数据隔离与权限机制,生产部署时需自行评估。
Q&A
MemCurrent 是什么?它主要解决什么问题?
MemCurrent 是 Databricks 推出的面向生产级智能体的持久记忆架构,旨在解决智能体在质量与效率之间的权衡问题,让智能体在提升准确率的同时降低 token 消耗和延迟。
MemCurrent 包含哪几种记忆类型?它们分别存储什么内容?
MemCurrent 包含两种记忆类型:情景记忆(episodic memory)存储原始会话轨迹;派生记忆(derived memory)存储从这些轨迹中提炼的学习成果,以文件形式存放在结构化知识库中,并由自动生成的 memory.md 索引描述文件结构和内容。
MemCurrent 通过哪些方式读写记忆?各自有什么特点?
MemCurrent 通过三种方式读写记忆:1)插件方式,在会话固定点自动读写;2)工具方式,智能体按需调用 add_memory、update_memory、delete_memory、search_memory、fetch_memory 等工具;3)离线“做梦”流程,在后台按计划或触发更新记忆,整合隐式学习并清理存储。
MemCurrent 在内部企业基准测试上的表现如何?
在内部企业基准测试上,MemCurrent 的通过率达到 68.4%,是无记忆(22.3%)的三倍,同时 token 使用量减少 31%、速度提升 26%;与黄金注入(78.6%)相比,缩小了超过 80% 的差距。
MemCurrent 在开源基准测试上的表现如何?
在 LoCoMo、LongMemEval 和 ConvoMem 三个开源基准上,MemCurrent 平均准确率为 88.1%,与全上下文(87.8%)相当,但每个问题输入 token 减少约 12 倍(8.4K vs 103K);在历史最长的两个基准上甚至超过全上下文。
MemCurrent 的设计中,哪种记忆类型贡献更大?提取策略如何组合最佳?
消融实验表明,派生记忆贡献更大(单独使用通过率 66.1%),情景记忆单独使用为 35.8%,两者结合达到 68.4%。提取策略上,离线“做梦”单独使用(63.5%)优于在线工具(53.9%),两者结合效果最佳(66.1%),实现显式请求立即生效、隐式学习后台整合。
