


Figma数据库的100倍扩展:如何实现水平分片
内容提要
Figma通过垂直分区和逻辑复制来扩展数据库,但随着用户和功能的增长,他们采用了水平分片来实现无限可扩展性。他们构建了独特的分片实现,包括相关表的共同位置、逻辑分片、DBProxy查询引擎和影子应用准备框架。Figma的目标是对数据库中的每个表进行水平分片。
延伸解读
垂直分区与水平分片的本质区别
Figma的垂直分区是将高流量相关表(如文件、组织)拆分到独立数据库,类似把衣柜里的衣物分到不同隔层,但每个隔层容量有限。当单表达到数TB、数十亿行时,垂直分区无法解决单机IOPS上限和Vacuum瓶颈,此时必须水平分片,将大表按分片键(如UserId)拆分到多个物理数据库,类似开设分馆。两者并非替代关系,而是互补:垂直分区先隔离负载,水平分片再突破单机极限。
逻辑分片与物理分片解耦的工程价值
Figma将逻辑分片(应用层通过视图路由)与物理分片(Postgres层实际数据分布)分离,使迁移风险可控。逻辑分片可先上线,回滚只需改配置;物理分片涉及数据重分布,回滚复杂。这种解耦让团队能独立测试和验证,降低整体风险。对于考虑分片的团队,这种分阶段策略值得借鉴:先让应用适应分片逻辑,再执行物理迁移,避免一次性高风险操作。
DBProxy查询引擎的权衡与挑战
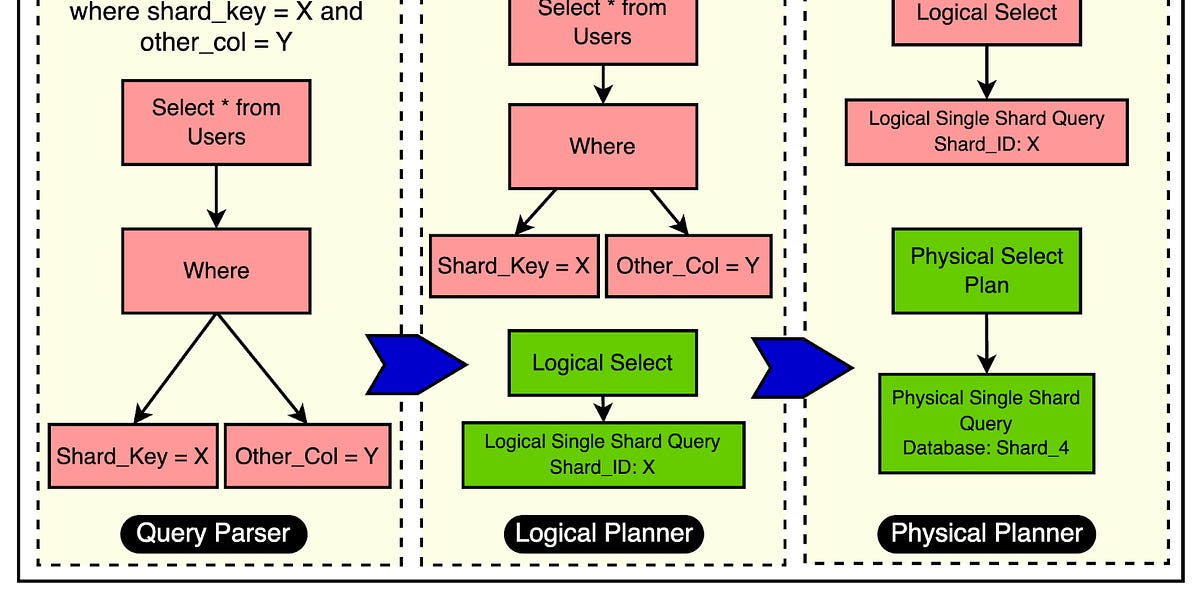
DBProxy解析SQL并路由查询,单分片键查询高效,但无分片键的查询需“散射-收集”,向所有分片发请求再合并结果,这会增加数据库负载,过多此类查询会削弱水平扩展性。Figma通过影子应用框架分析生产流量,选择支持90%常见查询的查询语言,并处理负载削减、事务支持等。这提示:分片后需监控散射查询比例,优化查询模式,否则扩展性可能不升反降。
自建分片方案与替代技术的取舍
Figma评估了CockroachDB、TiDB、Spanner、Vitess及NoSQL,最终选择在现有RDS Postgres上自建水平分片。原因包括:复用团队对Postgres的运维经验、按需定制而非适应通用方案、可回滚到未分片状态、避免重构复杂关系模型。这并非否定分布式数据库,而是基于现有架构和团队能力的务实选择。对于类似场景,自建方案能快速落地,但长期需权衡维护成本与未来迁移可能性。
Q&A
Figma是如何扩展其数据库的?
Figma通过垂直分区和逻辑复制扩展数据库,随后采用水平分片以实现无限可扩展性。
Figma在数据库扩展中遇到了哪些挑战?
Figma面临CPU利用率高、不可预测的延迟、以及大型表的处理需求等挑战。
什么是Figma的水平分片实现?
Figma的水平分片实现包括相关表的共同位置、逻辑分片、DBProxy查询引擎和影子应用准备框架。
Figma为什么选择逻辑复制而不是流复制?
Figma选择逻辑复制因为它允许迁移部分表、支持不同Postgres版本,并能设置反向复制以便回滚。
Figma的数据库分片过程中有哪些关键组件?
Figma的数据库分片过程中包括colos、逻辑分片与物理分片、DBProxy查询引擎等关键组件。
Figma的最终目标是什么?
Figma的最终目标是对数据库中的每个表进行水平分片,以实现近乎无限的可扩展性。
