

Q* 假设:思维树推理、过程奖励模型,以及如何大幅提升合成数据的能力 [译]
内容提要
路透社报道OpenAI内部项目Q*,称其能解小学数学题,被视为迈向AGI的突破。作者推测Q*结合思维树推理与过程奖励模型:思维树生成多条推理路径,过程奖励模型对每个推理步骤打分,再用离线强化学习优化。关键在于用AI而非人工为步骤评分,借助大量算力生成合成数据,从而大幅提升推理训练效率。
延伸解读
Q* 传闻与已知研究的对应关系
路透社报道的 Q* 项目被描述为能解小学数学题,作者推测其技术组合与已发表研究高度吻合:思维树(ToT)生成多条推理路径,过程奖励模型(PRM)对每个步骤评分,再通过离线强化学习优化。这种对应并非官方确认,但文章指出 ToT 和 PRM 的评估都集中在数学推理上,与泄露内容一致。读者应区分传闻与实证,但可借此理解大模型推理训练的可能方向。
过程奖励模型为何关键
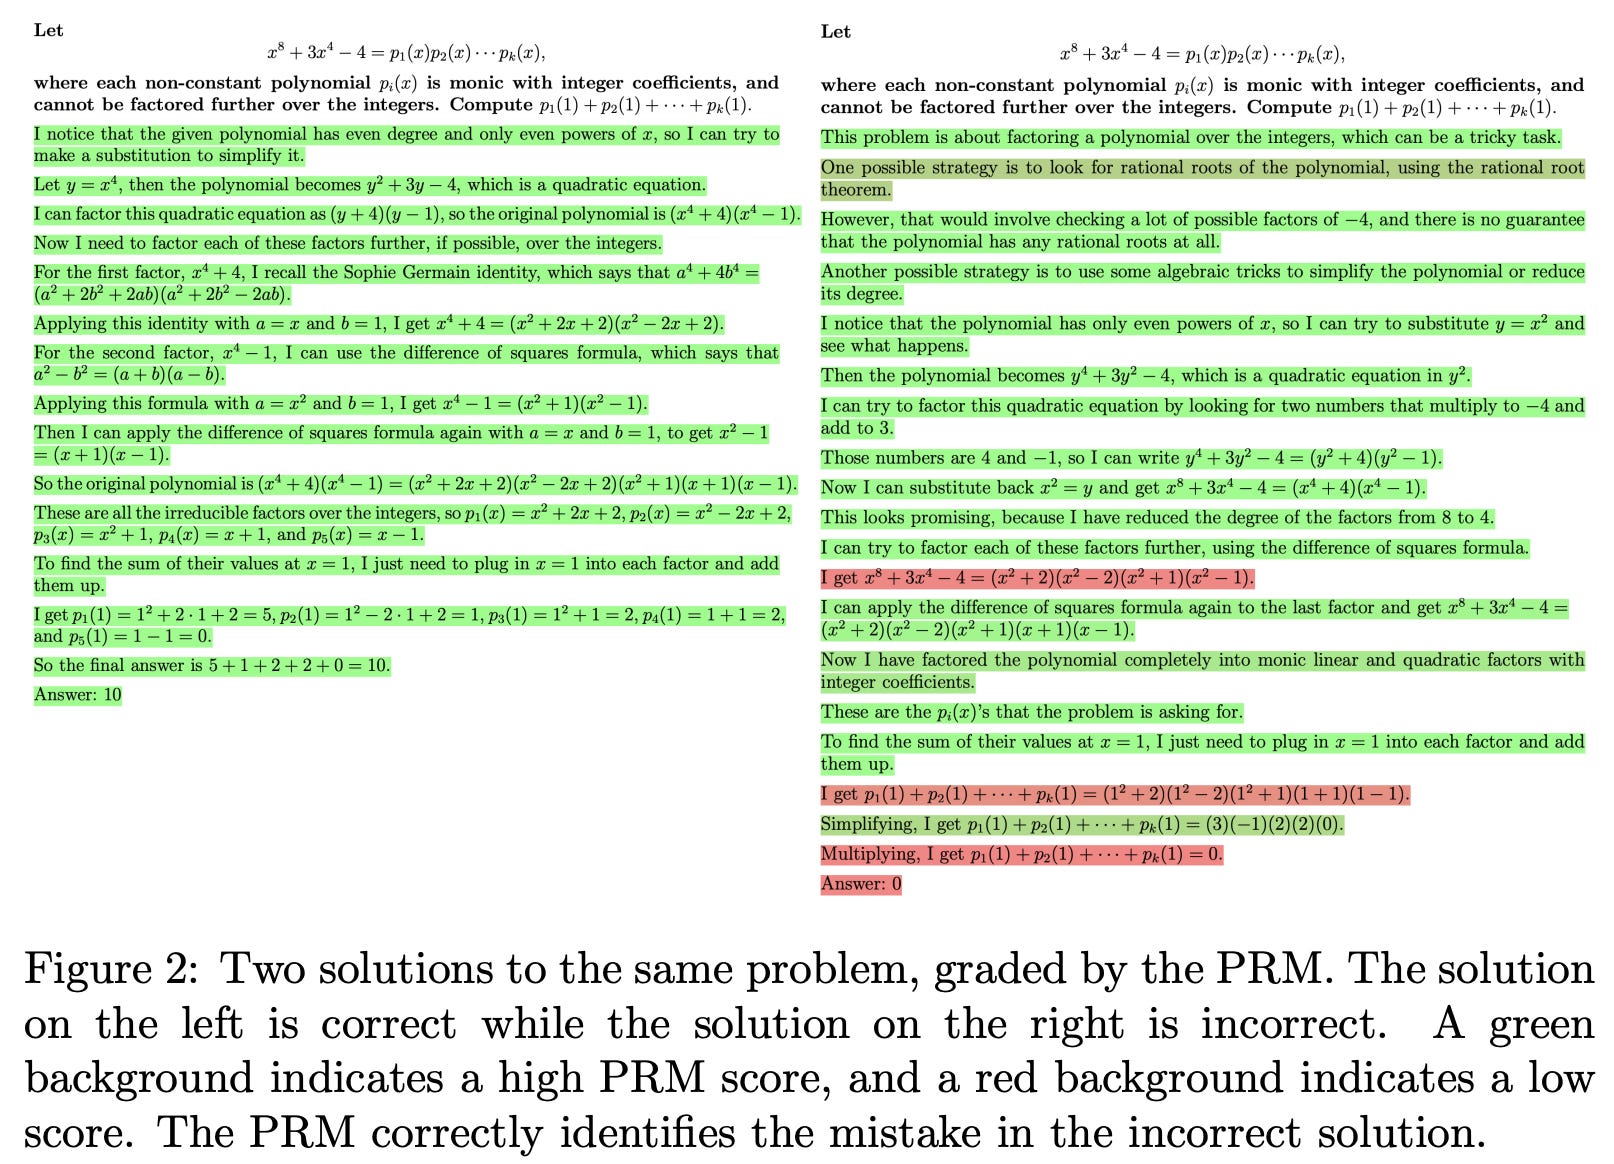
传统 RLHF 对整个回复打分,而 PRM 对每个推理步骤评分,能更精细地引导模型。文章引用 OpenAI 的《Let’s Verify Step by Step》说明,PRM 在推理任务上优于结果奖励模型,且 Best-of-N 抽样能提升效果。真正的潜力在于将 PRM 信号用于训练而非仅推理,这需要 ToT 提供多样化的推理路径供评分和学习。这种分步监督更贴合数学等可分解任务。
合成数据与算力门槛
Q* 假设的核心是用 AI 而非人工为每个推理步骤打分,从而大规模生成合成数据。树状结构比单一思考路径提供更多选择,有助于找到正确答案,但需要大量 GPU 时间。文章提到大型科技公司可能正用过程监督或 RLAIF 创建大规模预训练数据集,这与公开模型的差距令人担忧。不过,合成数据能否扩展到替代互联网规模的数据尚不明确,且实现这些概念需要极高的模型操作技巧。
Q&A
Q* 是什么?它和 AGI 有什么关系?
Q* 是 OpenAI 内部一个被路透社报道的项目名称,读作 Q-Star。OpenAI 的一些人认为它可能是公司在追求通用人工智能(AGI)方向上的一大突破。AGI 被定义为在大多数具有经济价值的任务中超越人类能力的自主系统。Q* 目前能解决一些小学数学问题,虽然水平有限,但让研究人员对其未来充满期待。
思维树(Tree-of-Thoughts)推理是如何工作的?
思维树是一种提示技术,它引导语言模型构建一个推理路径树,将推理步骤分解并激发模型创造新的推理步骤。模型可以生成多条可能通向正确答案的路径,然后采用不同方法评估每个节点或选择最终路径,例如基于最短路径或外部反馈。它被认为是第一个递归式的提示技术,用于增强推理能力。
过程奖励模型(PRM)和传统的结果奖励模型有什么区别?
传统的结果奖励模型对整个语言模型的回应进行评分,而过程奖励模型(PRM)对每个推理步骤进行评分,而不仅仅是整体信息。PRM 能提供更细粒度的反馈,在解决推理任务时优于标准奖励模型。例如,OpenAI 的论文《Let’s Verify Step by Step》展示了这种逐步验证的方法。
Q* 可能如何结合思维树和过程奖励模型来提升推理能力?
根据作者推测,Q* 可能采用过程奖励模型(PRM)对思维树生成的推理数据进行评分,并通过离线强化学习进行优化。思维树提供多样化的推理路径,PRM 对每个步骤打分,离线强化学习则利用这些评分信号优化策略。这种方法将 RLHF 扩展到多步骤方式,而不再是单纯的上下文带状策略。
为什么合成数据对 Q* 这类方法很重要?
合成数据可以快速扩展数据集,用 AI 而不是人类来为每个推理步骤打分,从而利用大量计算资源生成高质量的推理训练数据。树状结构提供了更多选择,帮助找到正确答案。这种大规模 AI 反馈数据可能用于创建大规模的预训练数据集,需要大量 GPU 时间。
实现 Q* 这类方法面临哪些主要挑战?
主要挑战包括:收集合适的提示、构建能够生成高质量推理步骤的模型,以及最关键的是准确评估成千上万个完成的任务。此外,实现这些概念需要极高的模型操作技巧,涉及分布控制、大规模推断和强化学习的挑剔性,这些都远远超出了普通人的知识和经验范围。
