
「RLE」算法在PS2中的应用
内容提要
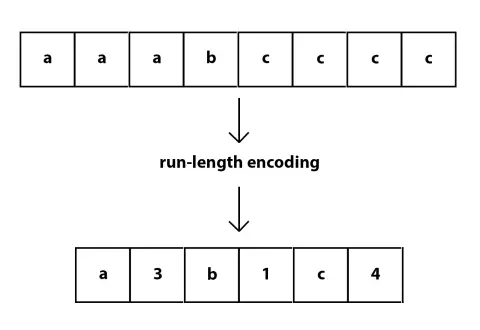
RLE算法用“重复次数×数据”压缩文件,如AAAAAABBCDDEEEEEF编码为6A2B1C2D5E1F,但重复少的字符串反而会变大。PS2对其改良:每2字节为一个单位,rle_code最高位为1表示非重复数据,为0表示重复数据,从而兼顾两类情况,简单易学。
延伸解读
PS2改良RLE的核心机制
PS2的RLE算法以2字节为基本单位,rle_code最高位作为标识位:为1时表示后续是非重复数据,通过0x8000减去rle_code的低7位得到数据块长度;为0时表示重复数据,rle_code直接作为重复次数。这种设计让算法能同时处理连续重复和连续非重复的数据,弥补了传统RLE在非重复数据上压缩失败的缺陷。
与传统RLE的关键差异
传统RLE通常以1字节为单位,仅用“重复次数×数据”表示,遇到ABCDE这类无重复数据时反而会膨胀。PS2的改良版将单位扩大到2字节,并引入标识位区分重复与非重复,使非重复数据也能被有效编码。这种差异是理解PS2图片压缩效率的关键,也体现了针对实际数据特征进行算法优化的思路。
压缩效果与适用场景
PS2的RLE算法在连续重复数据多的文件中压缩效果很好,因为重复块只需存储一次数据加一个rle_code。但对于非重复数据,虽然改良后不会膨胀,但每个数据仍需2字节存储,压缩率有限。因此它更适合重复模式明显的图片数据,而非所有类型的文件。
学习与实现要点
文章提供的伪代码展示了PS2 RLE的解压流程:先读取压缩后文件大小,然后循环读取rle_code,根据最高位判断数据类型并处理。实现时需注意所有数据以2字节为单位,且rle_code为0时可能表示重复次数为0,需跳过。这种结构简单清晰,适合初学者理解行程编码的变体。
Q&A
RLE算法是什么?它是如何压缩数据的?
RLE(Run Length Encoding,行程长度编码)是一种把文件内容用“重复次数×数据”的形式来表示的压缩方法。例如,数据AAAAAABBCDDEEEEEF可以编码为6A2B1C2D5E1F,原始数据17字节,编码后12字节,实现了压缩。
为什么传统的RLE算法有时反而会使数据变大?
因为传统RLE算法对每个字符都加上重复次数,如果字符重复出现的次数很少,编码后反而会增加数据长度。例如,ABCDE编码为1A1B1C1D1E,原始5字节变成10字节,压缩失败。
PS2中使用的RLE算法与传统RLE算法有什么主要区别?
PS2中使用的RLE算法以2字节为一个单位,而传统RLE算法普遍以1字节为单位。此外,PS2的rle_code最高位作为标识位,用于区分后续数据块是重复数据还是非重复数据,从而兼顾两类情况。
PS2的RLE算法中,rle_code的最高位有什么作用?
rle_code的最高位是标识位:如果为1,表示后面紧跟着的数据块是非重复数据,此时用0x8000减去rle_code的后7位得到数据块长度;如果为0,表示后面紧跟着的数据块是重复数据,此时rle_code就是重复次数。
PS2的RLE算法如何处理非重复数据块?
当rle_code的最高位为1时,表示后面是非重复数据块。此时将0x8000减去rle_code的后7位,得到数据块的长度,然后取出后面紧跟的该长度的数据块即可。
PS2的RLE算法如何处理重复数据块?
当rle_code的最高位为0时,表示后面是重复数据块。此时rle_code就是重复次数,只需取出后面紧跟着的一个数据块,重复rle_code次即可。
PS2的RLE算法适合压缩什么样的数据?
PS2的RLE算法适合压缩包含大量连续重复数据的数据,此时压缩效果很好。对于连续的非重复数据,改良后的算法也能处理,但压缩效果可能不如重复数据。
