

将AI驱动的答案和摘要引入网页文件预览
内容提要
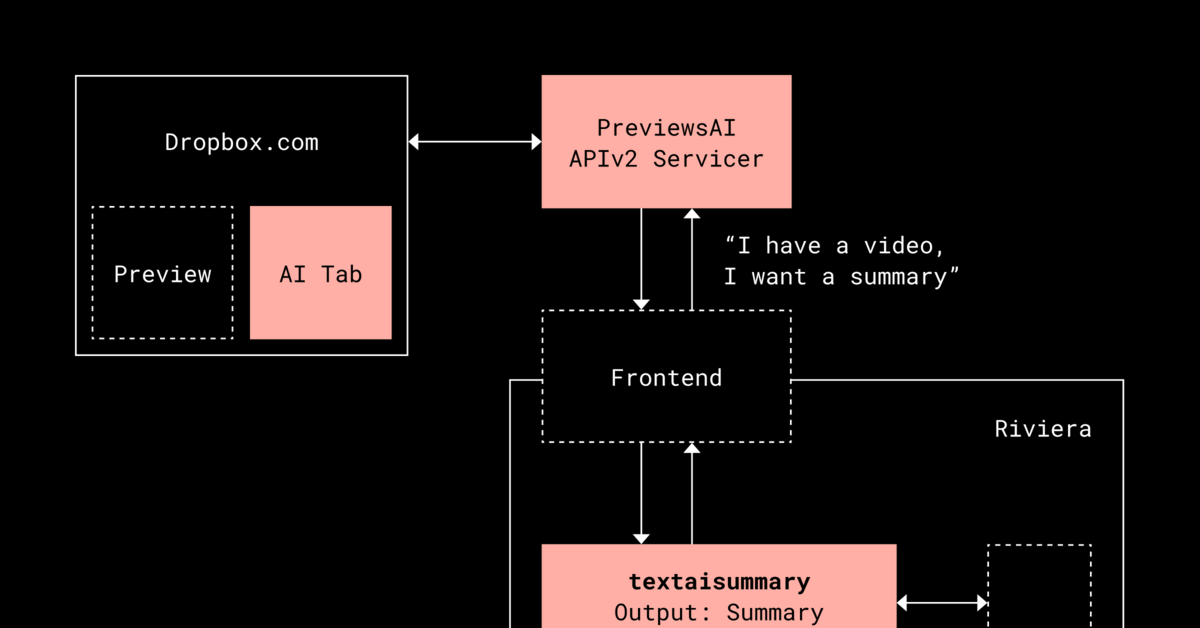
Dropbox的AI驱动的摘要和问答功能现在可以同时处理多个文件。Riviera系统将各种文件类型转换为文本并生成嵌入,即文本的数值表示。摘要插件使用k-means聚类将文本块分组成簇并生成摘要,而问答插件根据与查询的相似性选择相关的文本块并生成答案。该系统还根据问题类型确定要发送给语言模型的相关文本块的数量。
延伸解读
Riviera 转换框架的规模与缓存机制
Riviera 是 Dropbox 内部用于文件转换的系统,支持约 300 种文件类型,每天处理约 25 亿次请求,数据量近 1 EB。它通过插件在隔离的 jail 中运行,并维护转换图以链式执行多步转换。为了应对昂贵的计算,Riviera 内置了缓存层,每个转换状态都可复用。将嵌入生成视为一种文件转换,使得摘要和问答可以共享嵌入缓存,避免重复生成转录和嵌入,从而支撑大规模 AI 功能。
摘要插件:k-means 聚类提升主题覆盖与降低幻觉
摘要插件将文本分块并生成嵌入,然后使用 k-means 聚类将相似块分组。它选取主要簇的代表性块拼接成上下文,再交给 LLM 生成摘要。相比 map-reduce 的摘要之摘要方法,k-means 能覆盖多约 50% 的主题,因为聚类寻找语义上不相似的块,减少了信息重复。同时,由于只调用一次 LLM,幻觉风险更低,且错误定位更容易。
问答插件:基于相似度选择上下文并返回来源
问答插件为问题生成嵌入,计算每个文本块与问题的距离,选择最相似的块作为上下文,连同问题发送给 LLM 生成答案。与摘要插件选择不相似块相反,问答选择相似块。系统还会将相关块的位置作为来源返回,方便用户查阅。此外,插件利用函数调用和结构化输出,在生成摘要或答案的同时请求后续问题,帮助用户更自然地探索文件内容。
多文件扩展:利用幂律动态确定上下文数量
将 AI 摘要和问答扩展到多个文件时,关键挑战是确定发送给 LLM 的相关块数量。Dropbox 发现不能仅凭问题本身判断直接或宽泛,还需结合上下文。他们利用幂律动态:取与查询最相关的前 50 个块,计算最高和最低相关性分数,丢弃底部 20% 的分数范围。直接问题曲线陡峭,保留较少块;宽泛问题曲线平缓,保留更多块。这样能针对问题类型提供恰当上下文,平衡答案的准确性与全面性。
Q&A
Dropbox的AI摘要和问答功能如何处理多个文件?
Dropbox的AI摘要和问答功能可以同时处理多个文件,通过Riviera系统将文件转换为文本并生成嵌入。
Riviera系统支持多少种文件类型的转换?
Riviera系统支持约300种文件类型的转换。
摘要插件是如何生成文件摘要的?
摘要插件使用k-means聚类将文本块分组成簇,并生成主要思想的摘要。
问答插件如何选择相关文本块来生成答案?
问答插件通过计算文本块与用户查询的相似性来选择相关文本块。
如何确定发送给语言模型的文本块数量?
系统根据问题类型和用户查询的上下文来确定发送给语言模型的相关文本块数量。
使用k-means聚类的优势是什么?
使用k-means聚类可以提高摘要的主题多样性,并降低模型产生幻觉的概率。
