

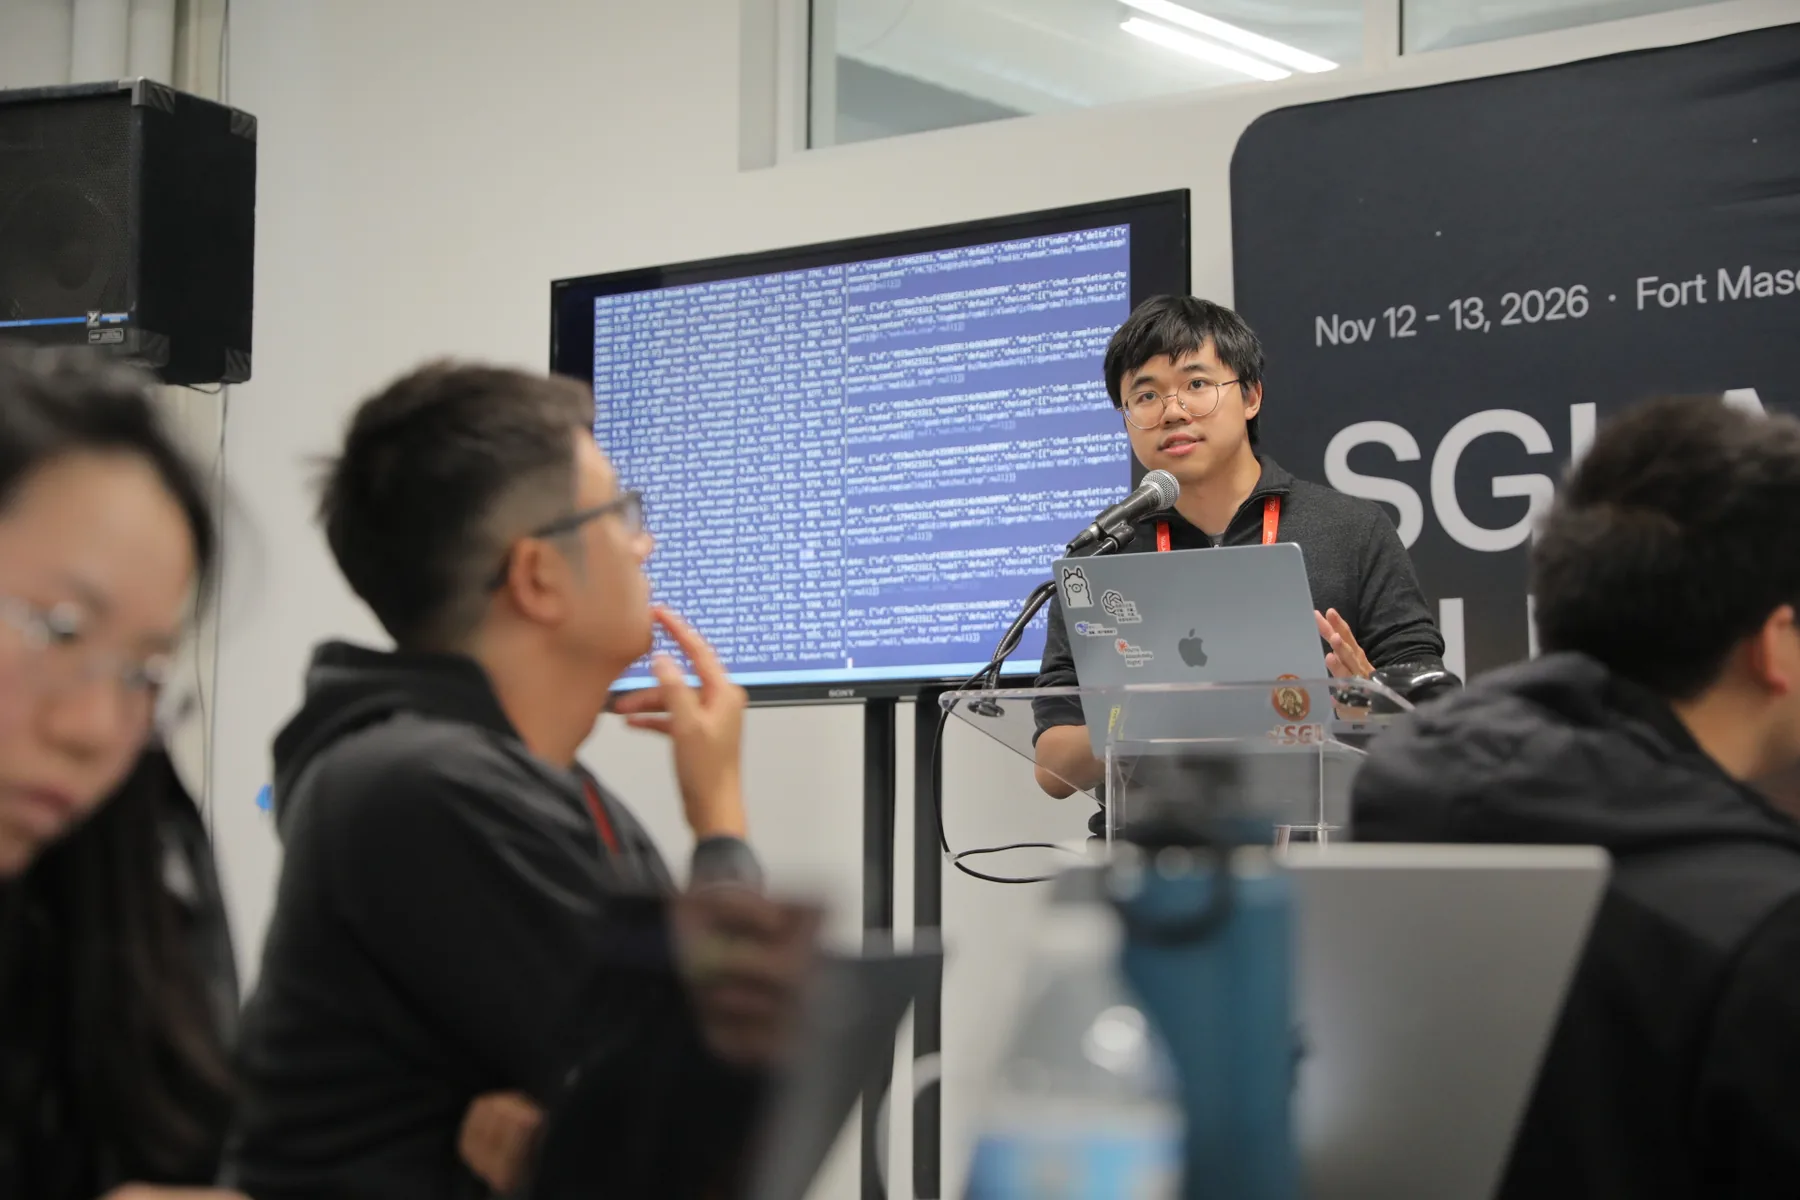

2026年SGLang峰会回顾:共建开放AI基础设施
内容提要
首届SGLang峰会于11月在旧金山举行,超2000名开发者参加。会上宣布成立由九家创始成员组成的SGLang联盟,并发布SGLang v1.0和Miles v0.2。SGLang已服务332家机构,Meta借此实现超2倍GPU节省;Miles扩展至多硬件与多模态强化学习。峰会还展示了AI辅助优化成果,如AI编写的GPU内核使解码提速2倍。
延伸解读
联盟成立:开放治理与厂商协作的新平衡
SGLang联盟由九家创始成员组成,涵盖NVIDIA、AMD、Intel、Google、Meta等硬件与云厂商。联盟定位为常设论坛,成员可参与路线图讨论并贡献生产经验、测试资源,但技术决策与代码合入仍由维护者负责。这种安排既引入厂商深度协作,又保留项目开放性,避免单一厂商主导。对开发者而言,硬件适配和前沿模型支持有望加速,但需关注联盟成员影响力是否影响中立性。
v1.0与AI开发:效率优先,但兼容性待观察
SGLang v1.0强调生产可扩展性,重点强化现有功能、清晰暴露配置问题,并建立兼容性预期。针对混合模型架构和长时智能体,引入统一内存管理与分层缓存以复用状态。同时,项目转向AI驱动开发,多数合并PR由智能体生成,未来还将用AI写代码、审PR、建测试。这能加速迭代,但读者需留意AI生成代码的质量控制与版本迁移成本,官方已提供发布跟踪器供参考。
Miles v0.2:强化学习走向多硬件与多模态
Miles v0.2将生产级RL后训练扩展到NVIDIA GPU、AMD GPU和Google TPU,AWS Trainium即将支持,并兼容Megatron-LM、FSDP、TorchTitan等训练框架。除文本外,新增图像、视频、音频的RL支持,Miles-Diffusion覆盖扩散模型,Multi-LoRA便于单基座模型定制多任务。这降低了多硬件、多模态RL的门槛,但实际部署仍需评估各硬件后端成熟度与工具链完整性。
生产验证与AI优化:收益明确,但依赖场景
Meta报告迁移至SGLang后GPU节省超2倍,并跨NVIDIA、AMD、TPU及MTIA多硬件验证;SGLang已服务332家机构。峰会还展示AI辅助优化成果:AI编写的GPU内核使解码提速2倍,两名工程师借助AI在一周内完成新加速器移植并达生产性能1%以内。这些案例说明开放协作与AI工具能显著提升效率,但节省幅度和移植速度取决于具体工作负载与硬件条件,不宜直接外推至所有场景。
Q&A
SGLang联盟有哪些创始成员?
SGLang联盟的九家创始成员是:NVIDIA、AMD、Intel、Google、Meta、Thinking Machines Lab、Cloudflare、Modal和RadixArk。
SGLang v1.0有哪些主要更新?
SGLang v1.0聚焦于提升生产推理的效率和可扩展性,主要更新包括:加强现有功能、清晰暴露配置问题、建立兼容性预期;引入统一内存管理和分层缓存以支持混合模型架构和长运行代理;并转向AI驱动开发,由代理生成大部分合并的PR。
Miles v0.2支持哪些硬件和训练框架?
Miles v0.2支持NVIDIA GPU、AMD GPU和Google TPU,AWS Trainium即将支持;训练框架支持Megatron-LM、FSDP和TorchTitan。
Meta使用SGLang后取得了什么效果?
Meta在生产环境中使用SGLang后,相比之前的推理解决方案实现了超过2倍的GPU节省,并在多种硬件平台上大规模验证。
SGLang在AI辅助优化方面有哪些成果?
AI代理编写的GPU内核使解码速度提升高达2倍,输出经与原内核验证;两名工程师借助AI代理在不到一周内将SGLang移植到另一款AI加速器,性能达到生产水平的1%以内。
SGLang目前服务了多少家机构?
SGLang已服务332家机构,覆盖AI生态系统的多个领域。
