

在单 CPU 容器中,你的 .NET 并行循环可能退化为串行
内容提要
.NET 的 Parallel.ForEachAsync 默认并发数取决于 CPU 数,在单 CPU 容器中 I/O 密集型循环会退化为串行,处理时间近乎翻倍。应为每个下游依赖设置独立并发预算而非统一限制,并显式配置、启动时校验、监控在途调用。实验表明,按依赖分配许可可避免写入服务过载和 503 拒绝,虽略降健康时吞吐,但可靠性更高。
延伸解读
默认并发数为何在单 CPU 容器中变成 1
Parallel.ForEachAsync 未显式设置 MaxDegreeOfParallelism 时,默认使用 Environment.ProcessorCount 作为并发上限。在 Linux、macOS 及 .NET 6 后的 Windows 上,该值取逻辑处理器数、CPU 亲和性计数和 CPU 利用率限制(向上取整)中的最小值。因此单 CPU 容器得到 1,半 CPU 限制同样为 1,且该值在运行时启动后固定不变。即使传入仅含 CancellationToken 的 ParallelOptions,Max
统一并发限制无法匹配不同依赖的容量
文章指出,用一个 SemaphoreSlim 限制所有出站调用,虽能控制总并发,却无法控制调用在不同依赖间的分布。慢依赖会长时间持有许可,挤占共享池,导致容量较小的服务可能收到超过其处理能力的请求。例如,30 个总许可不能保证容量为 6 的写入服务最多只收到 6 个并发请求。因此,应为每个下游依赖设置独立的并发预算,并依据其实际容量确定限额。
独立预算在故障时避免 503,但健康时略降吞吐
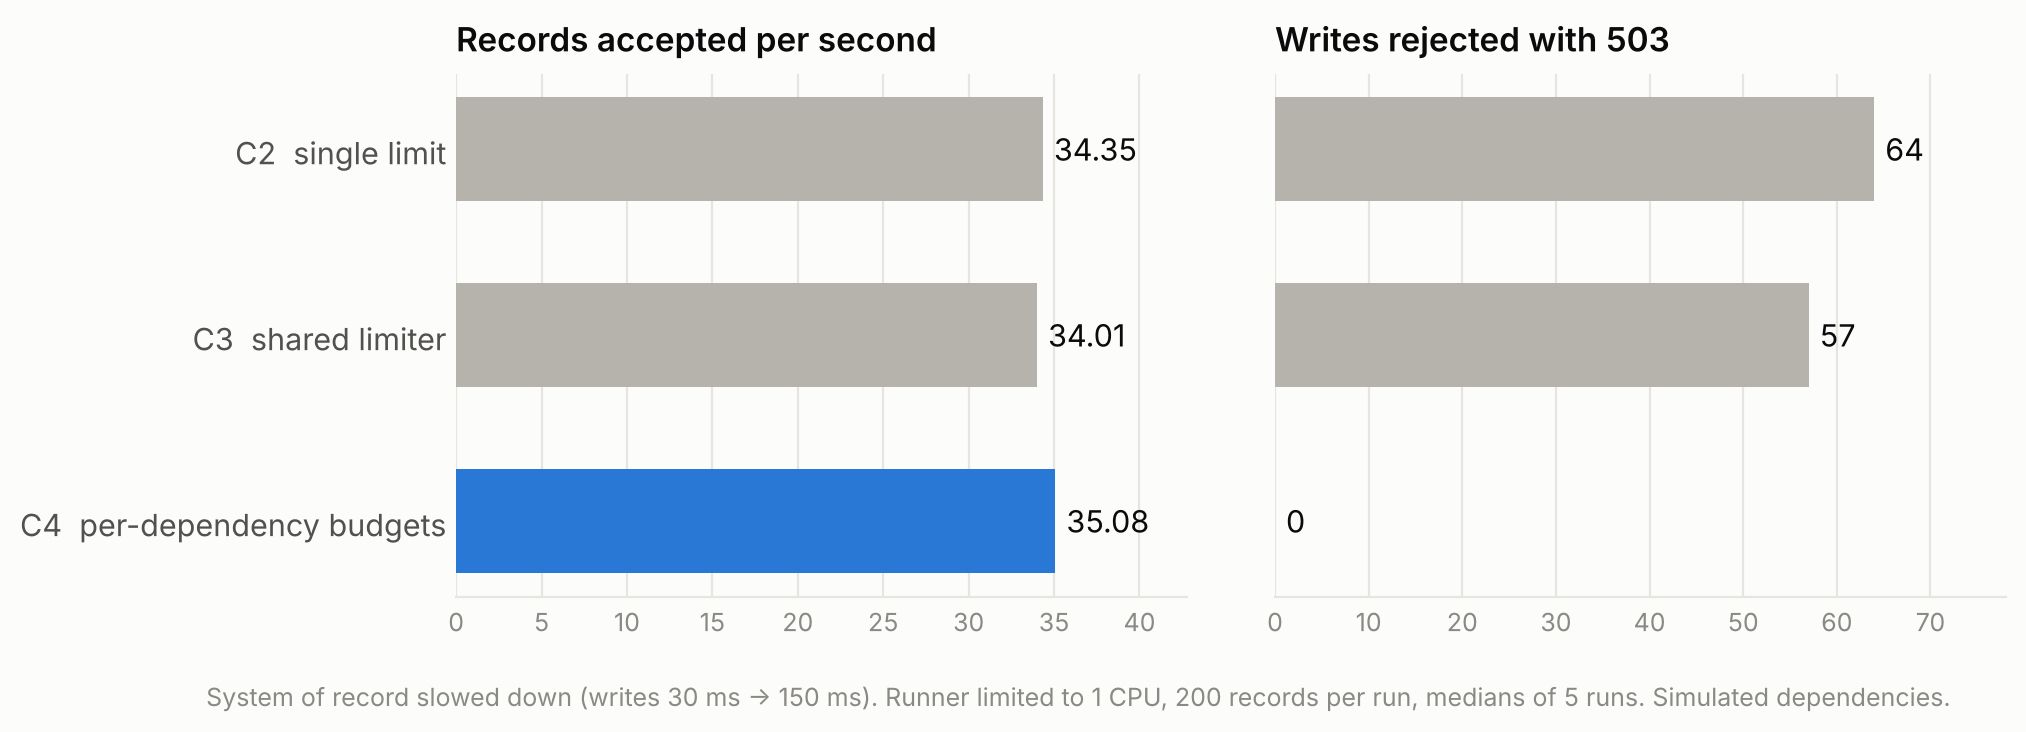
实验对比四种策略:在写入变慢场景下,无依赖限制的 C2 和共享许可的 C3 分别产生 64 和 57 次 HTTP 503 拒绝,而按依赖分配许可的 C4 零拒绝,有用吞吐相近。健康时 C4 吞吐为 58.38 条/秒,比 C3 的 65.32 和 C2 的 67.86 低约 11%–14%。作者认为,当可靠写入比尽快完成批次更重要时,可接受这一吞吐下降;若拒绝写入恢复成本低且延迟优先,则需测量权衡。
配置与监控要点:显式化、校验与超时分离
文章建议将并发限制写入显式配置,并在启动时校验,避免容器规格变化悄然改变对外调用量。同时监控每个依赖的在途调用数,与配置值对比。调用超时应从获得许可后开始计时,避免本地排队消耗超时;许可获取本身也应有独立截止时间。此外,信号量只限制在途调用数,不执行按时间配额,若 API 有每分钟限额,需另用速率限制器。
Q&A
为什么在单 CPU 容器中,.NET 的 Parallel.ForEachAsync 会退化为串行处理?
因为 Parallel.ForEachAsync 默认使用 Environment.ProcessorCount 作为最大并发数。在单 CPU 容器中,ProcessorCount 返回 1,导致循环一次只能处理一个记录,即使操作是 I/O 密集型且大部分时间在等待,也无法并发。
如何为不同的下游服务设置独立的并发限制?
可以为每个依赖创建独立的 SemaphoreSlim,并在调用前获取相应许可,调用后释放。例如,使用一个辅助类为 enrichment API 和记录系统分别设置信号量,确保每个服务的并发数不超过其容量。
在单 CPU 容器中,Parallel.ForEachAsync 处理 200 条记录比双 CPU 慢多少?
实验显示,处理 200 条记录的中位时间从双 CPU 的 42.1 秒增加到单 CPU 的 83.6 秒,几乎翻倍。
使用统一的并发限制(如一个信号量控制所有出站调用)有什么缺点?
统一限制无法区分不同依赖的容量差异。慢速依赖会长时间占用许可,导致其他依赖的并发不足,可能使快速服务过载或慢速服务被过度调用,无法实现精细控制。
在实验中,为每个依赖设置独立预算(C4)与统一限制(C3)在写入服务变慢时的表现有何不同?
当写入服务变慢时,C4(独立预算)没有产生任何 HTTP 503 拒绝,而 C3(统一限制)产生了 57 次拒绝。C4 的有用吞吐量与 C3 相当或略高,但完成时间稍长(5.7 秒 vs 4.2 秒)。
如何确定每个依赖的并发预算大小?
应根据服务的容量和典型服务时间来确定。可以询问服务所有者其最大并发请求数,或在测试环境中逐步增加并发并观察延迟和拒绝情况。使用利特尔法则估算达到目标吞吐量所需的在途调用数,并确保不超过服务容量。
在代码中配置并发限制时,有哪些最佳实践?
应将限制显式配置,并在启动时验证;监控每个服务的在途调用数;为服务调用和许可等待设置独立的超时,调用超时应在获取许可后开始;在容器实际 CPU 限制下重复测量。
