


用于视频生成的扩散模型
内容提要
扩散模型在图像合成方面取得了显著成果,研究者们开始探索更复杂的视频生成任务。视频生成面临时间一致性和高质量数据收集的挑战。研究者提出了基于3D U-Net和Transformer的架构,以及调整现有图像模型生成视频的技术,以提高视频生成的质量和效率。
延伸解读
视频生成的核心挑战:时间一致性与数据稀缺
与图像生成相比,视频生成需保证帧间时间一致性,这要求模型编码更多世界知识。同时,高质量、高维视频数据及文本-视频对的收集难度远高于文本或图像,成为制约发展的关键瓶颈。文章指出,这些挑战催生了从零训练和适配图像模型两条技术路线。
从零训练:3D U-Net与Transformer架构
文章介绍了VDM的3D U-Net,将2D卷积扩展为空间3D卷积,并添加时间注意力块以捕捉时间连贯性。Imagen Video则采用级联扩散模型,包含基础模型和多个时空超分组件,并通过渐进蒸馏将采样步数降至8步。Sora则基于DiT架构,在时空patch上操作,展现了Transformer在视频生成中的扩展潜力。
适配图像模型:微调与免训练策略
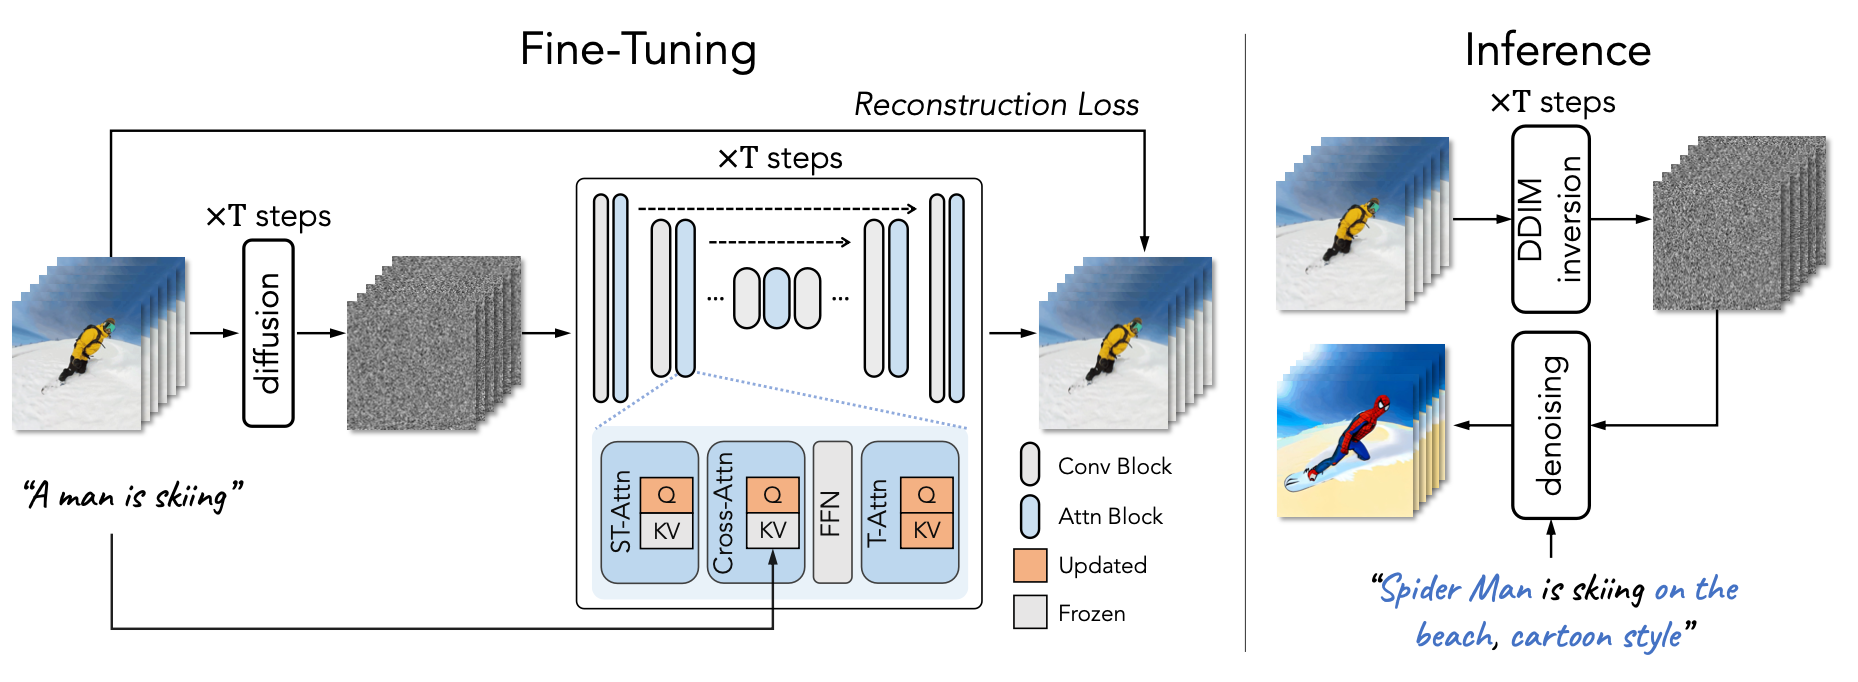
为缓解数据需求,研究者将预训练图像扩散模型“膨胀”为视频模型。Make-A-Video插入伪3D卷积和注意力层,仅微调新层;Tune-A-Video通过ST-Attention实现单视频轻量微调;Video LDM在潜在空间添加时间层并微调解码器。免训练方法如Text2Video-Zero利用跨帧注意力和运动动态,无需训练即可生成视频。
长视频与高分辨率生成的技术路径
生成长视频需多步上采样,如Imagen Video的级联超分和Video LDM的潜在帧插值。ControlVideo通过交叉帧注意力和层次采样确保长视频时间一致性。Lumiere采用时空U-Net一次生成整个视频,避免依赖时间超分。这些方法在计算效率和一致性之间寻求平衡,反映了领域的最新探索。
Q&A
扩散模型在视频生成中面临哪些挑战?
视频生成面临时间一致性和高质量数据收集的挑战。
有哪些模型被提出用于提高视频生成的质量和效率?
研究者提出了基于3D U-Net和Transformer的架构,以及Make-A-Video、Tune-A-Video、Gen-1等模型。
Make-A-Video模型的主要功能是什么?
Make-A-Video模型通过扩展预训练的图像模型来生成视频,包含时空卷积和注意力层。
Tune-A-Video模型如何实现视频生成?
Tune-A-Video模型允许对单个视频进行轻量级微调,以生成新视频。
ControlVideo模型的创新之处是什么?
ControlVideo模型通过交叉帧注意力和层次采样来生成长视频,确保时间一致性。
视频生成模型如何处理时间一致性问题?
视频生成模型需要在多个步骤中进行上采样,以延长视频长度或提高帧率,从而处理时间一致性问题。
