
Agentic coding is straining CI. Here’s how we scaled test impact analysis at Anthropic
内容提要
Anthropic工程师借助Claude大幅提升代码产出,导致CI任务半年激增25倍,测试影响分析服务频繁过载。团队尝试扩容、分片、每日重启等临时方案,分别仅维持70天、29天和不到一天。最终由一名工程师用三周时间,将服务重构为基于内存数据库的无状态、可水平扩展分布式架构。作者建议按两季度25倍负载设计架构,并尽早移除进程内状态。
延伸解读
指数级增长下的架构规划
文章指出,Anthropic的CI任务在六个月内激增25倍,而传统扩容手段仅能维持70天、29天甚至不到一天。作者建议按两个季度25倍负载设计架构,并尽早移除进程内状态。这提醒团队,在AI加速代码生成的背景下,架构规划必须考虑指数增长,而非线性扩展。
临时扩容的局限与代价
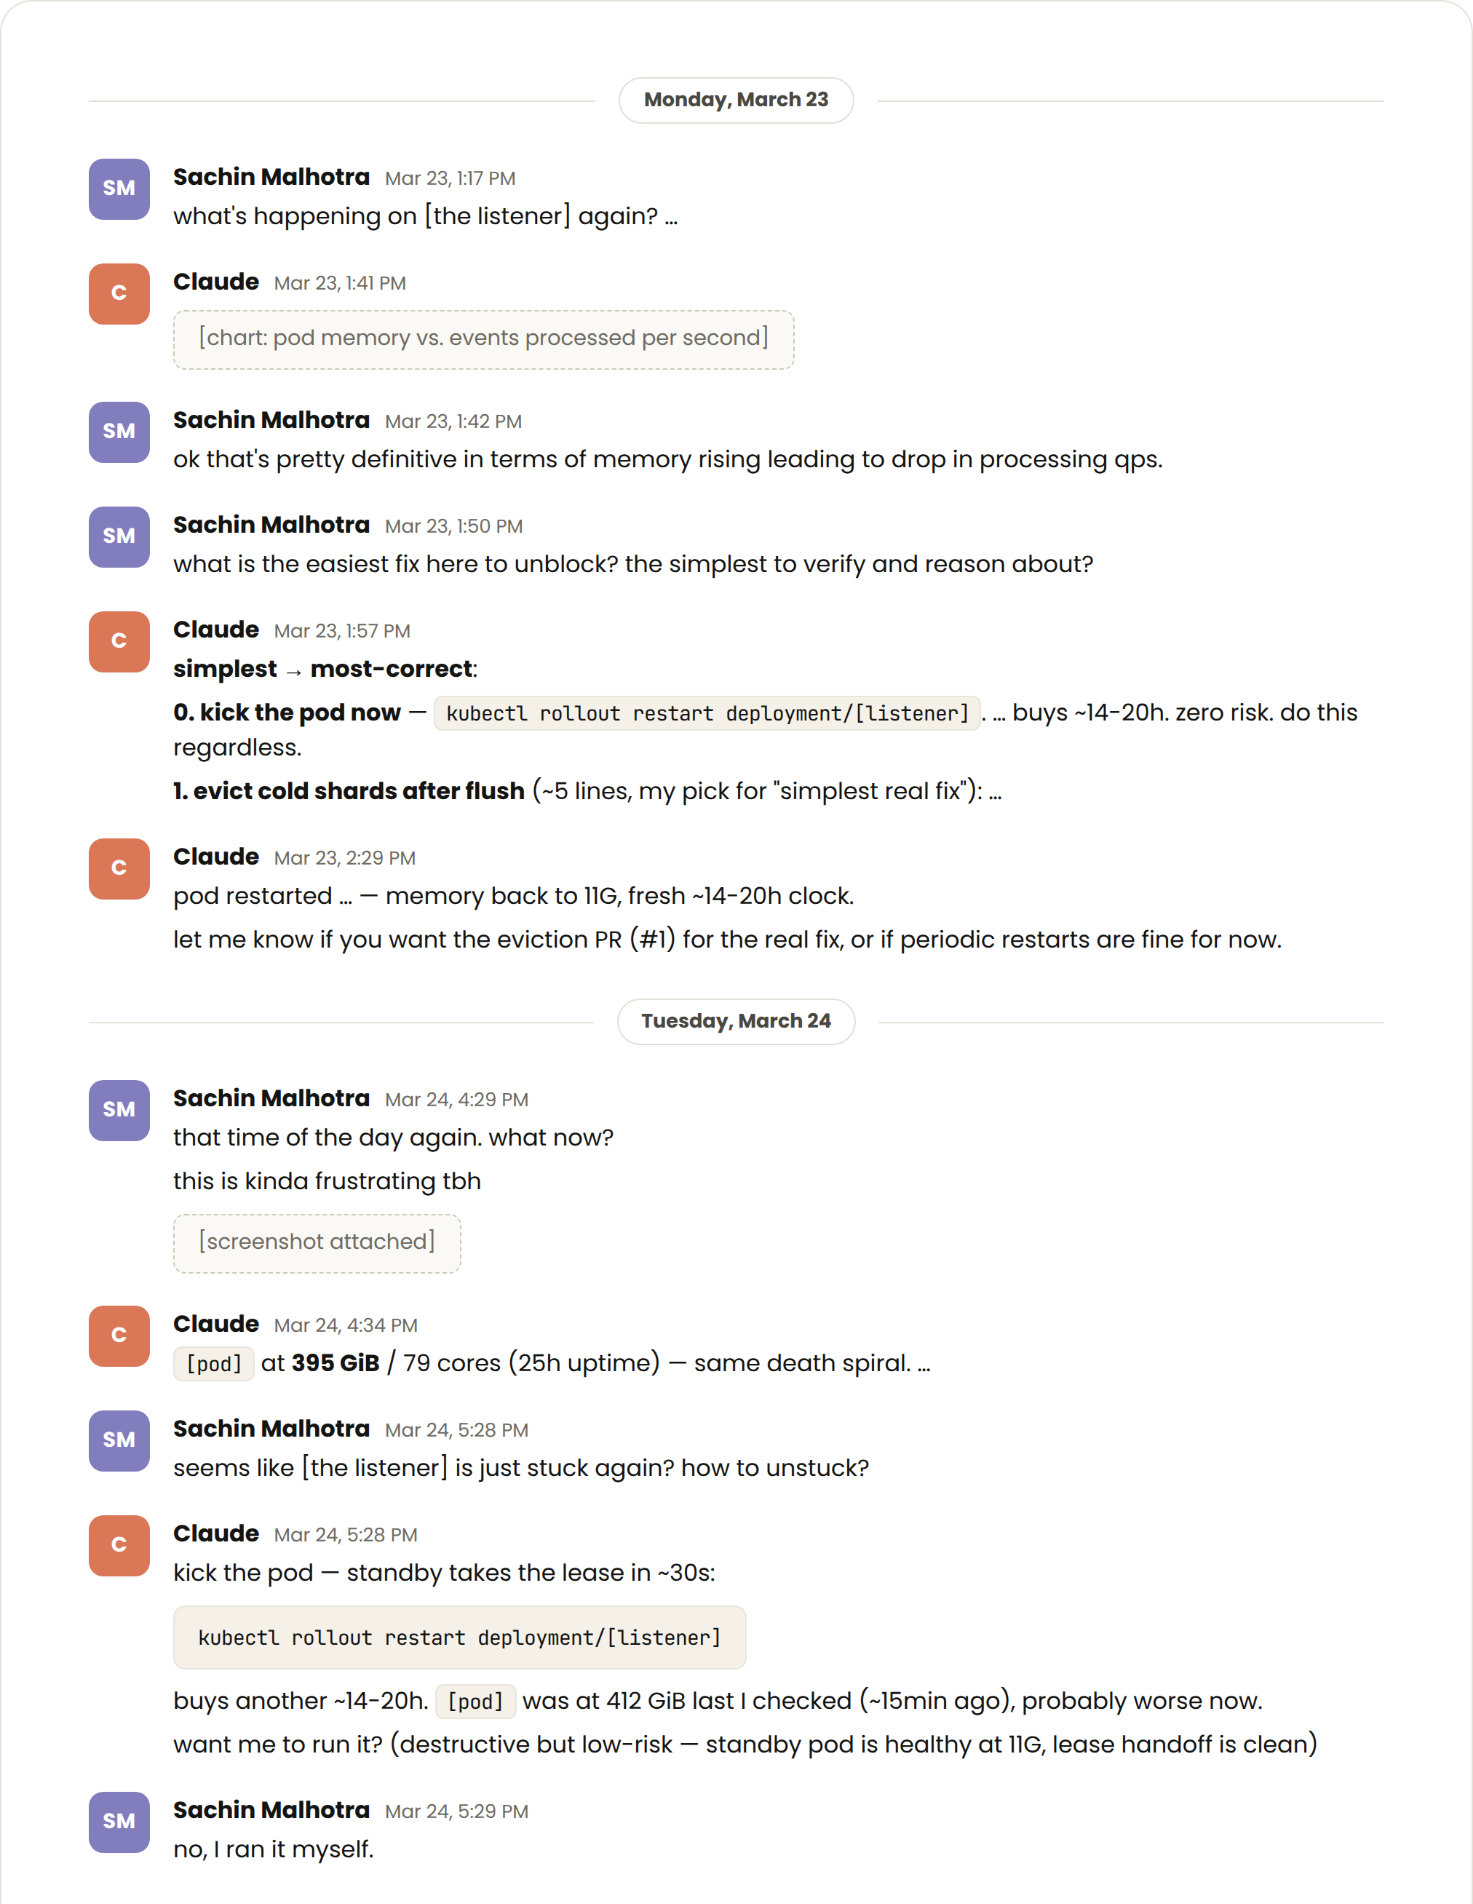
团队尝试了扩容、分片和每日重启三种临时方案,分别只维持了70天、29天和不到一天。这些措施虽然快速,但无法应对持续增长,且重启导致监听器滞后,使用过期数据选择测试。这表明,临时修复可能掩盖问题,最终仍需彻底重构。
无状态分布式架构的优势
最终重构将服务改为基于内存数据库的无状态、可水平扩展架构。监听器工作节点可独立处理结果并追加到日志,消费者进程定期汇总,选择器快速查询。这种设计更易扩展和内存分析,尽管运行成本更高,但避免了单点瓶颈。
AI辅助开发与监控的实践
文章提到,一名工程师用三周完成重构,而一年前需一个季度。团队还利用Claude监控服务,在监听器滞后时自动提醒并讨论方案。这展示了AI在加速开发和运维中的潜力,但需确保服务可观测性,如输入输出任务数匹配,以便AI有效辅助。
Q&A
Anthropic 的 CI 任务为什么在半年内激增了 25 倍?
因为 Anthropic 工程师借助 Claude 大幅提升了代码产出,平均每季度交付的代码量是 2021-2025 年的 8 倍,其中 80% 由 Claude 编写,同时 Claude 也大量参与 PR 的审查和批准。此外,代码库中的测试数量增长了 10 倍,而工程师人数仅略有增加,导致 CI 任务在六个月内增长了 25 倍。
Anthropic 的测试影响分析服务是如何工作的?
该服务是一个确定性的测试影响分析(或测试选择)服务,根据历史表现和包相关性决定每次变更运行哪些测试。它依赖两个同步的组件:一个“监听器”记录每次 CI 运行的测试结果,一个“选择器”读取测试结果历史并决定在哪些打开的 PR 上运行哪些测试。
Anthropic 团队尝试了哪些临时扩容方案?各自维持了多久?
团队尝试了三种临时方案:1) 使用更大的机器(将核心数翻倍),维持了 70 天;2) 分片(按包拆分状态,每个分片有独立 worker),维持了 29 天;3) 每日重启,维持了不到一天。这些方案都只是短暂缓解了问题。
最终的重构方案是什么?为什么它能解决问题?
最终方案是将服务重构为基于内存数据库的无状态、可水平扩展的分布式架构。具体来说,引入了内存数据存储,监听器 worker 可以处理任何结果并将其追加到日志中,不再在内存中保留状态,从而实现无状态和水平扩展。一个独立的消费者进程每隔几秒将日志汇总为每个测试的历史记录,选择器可以快速查找相关结果历史。这种架构运行成本更高,但更容易扩展和进行内存分析。
作者对于架构设计有什么建议?
作者建议:1) 无论自建还是购买,假设你的架构将在两个季度内承受 25 倍的负载;2) 在 v0 设计中就可以考虑 10-20 倍的预期规模(只要预算允许);3) 为服务添加监控,让 Claude 能够像眼睛和耳朵一样帮助逐步修复问题,特别要确保进入的 CI 任务数量与出去的数量相等;4) 从一开始就避免在进程中保持状态,避免将关键服务作为单实例运行,除非你能测量它和任何金丝雀变更。
这次重构花了多长时间?与一年前相比如何?
这次重构由一名工程师耗时三周完成。作者指出,一年前类似的项目可能需要接近一个季度的时间。这反映了现在编写代码不再是瓶颈,重构和重新设计服务的时间也大大缩短。
