


miniTE 技术报告:基于原生 NVFP4 的稳定高效强化学习
内容提要
文章研究原生NVFP4强化学习训练后期的不稳定性,分析量化、激活缩放、KV缓存和执行差异的影响。提出TRIAGE按优势与概率差方向调整更新以提升稳定性,miniTE统一量化接口并优化低精度计算。在8×B300上,完整学习器更新速度约为BF16的1.33–1.37倍,固定输出服务吞吐约为1.64倍。但权重转换与同步开销抵消了采样收益,实际检查点五任务均值仍低于BF16。
延伸解读
训练后期不稳定:量化误差只是起点
文章指出,原生NVFP4强化学习在训练后期会出现奖励下降、熵异常和训练-采样概率差扩大。诊断表明,问题不仅来自量化格式本身,还涉及激活缩放粒度、KV缓存精度以及训练与推理框架的执行差异。例如,将KV缓存从FP8改为BF16可将概率差从0.0721降至0.0583;而W4A16配置下概率差接近BF16参考值。这说明低精度训练需要系统性地对齐数值路径,而非仅替换单个算子。
TRIAGE:用更新方向控制残差风险
TRIAGE不改变前向计算,而是根据优势符号和概率差方向调整更新权重。在负优势且负概率差的片段中,它衰减更新以避免放大不匹配;同时用有界惩罚修复正优势响应中的负偏移。在4B模型上,TRIAGE完成600步训练,五任务均值为58.49%,接近BF16的58.26%;在相同300步预算下,TRIAGE得分53.03%,高于原生NVFP4和TIS。这表明方向感知的更新规则能提升稳定性,但30B模型上仍略低于BF16。
miniTE:统一接口与执行优化
miniTE将量化策略、线性层和计算后端分离,提供精度配置、对齐检查和性能分析。与Transformer Engine合作优化了按token的NVFP4路径,包括连续布局、设备端元数据、amax复用、分组GEMM和融合。在8×B300上,完整学习器更新速度约为BF16的1.33–1.37倍,固定输出服务吞吐约为1.64倍。但文章强调,这些系统收益与学习效果来自不同配置,不能直接推断端到端RL加速或BF16级学习表现。
实际部署的权衡:速度与学习质量尚未兼得
在报告的在线RL运行中,权重转换与同步开销抵消了采样收益,实际检查点五任务均值仍低于BF16。严格对齐实验虽将训练-采样概率差降至约10⁻⁸并保持后期奖励稳定,但该实验与实用学习/吞吐测试配置不同。文章指出,匹配算子并获得较小概率差并不保证BF16级学习,误差容忍度、更新规则和最终结果仍需进一步研究。读者应区分局部数值一致性与端到端训练效果。
Q&A
为什么原生 NVFP4 强化学习训练后期会不稳定?
文章指出,NVFP4 RL 训练后期不稳定源于量化误差、检查点转换误差、激活缩放粒度、KV 缓存精度以及训练与推理框架执行差异的共同作用。这些误差会累积,导致奖励下降、熵异常和训练-采样对数概率差距增大。
TRIAGE 是如何提升 NVFP4 强化学习稳定性的?
TRIAGE 通过分析优势(advantage)与概率差(gap)的方向,在 64 token 的片段中识别高风险更新,并对负优势且负 gap 的 token 进行选择性衰减;同时,对正优势响应中的负片段偏移施加有界伪 Huber 惩罚进行修复,从而控制残差不匹配对学习的影响。
miniTE 在低精度计算优化上取得了怎样的加速效果?
在 8×B300 上,采用 BF16 反向传播的 miniTE 完整学习器更新速度约为 BF16 的 1.33–1.37 倍;在固定输出服务测试中,吞吐量约为 BF16 的 1.64 倍。
miniTE 如何减少训练与推理之间的数值差异?
miniTE 通过分层接口统一量化策略、线性层和计算后端,并提供确定性模式(deterministic mode),逐层替换 Megatron 算子,使其与 SGLang 推理使用相同的内核、公式和归约顺序,从而实现关键层的位精确对齐,将训练-推理对数概率差距降至约 10⁻⁸。
在 NVFP4 量化中,per-token 缩放相比 per-tensor 缩放有什么优势?
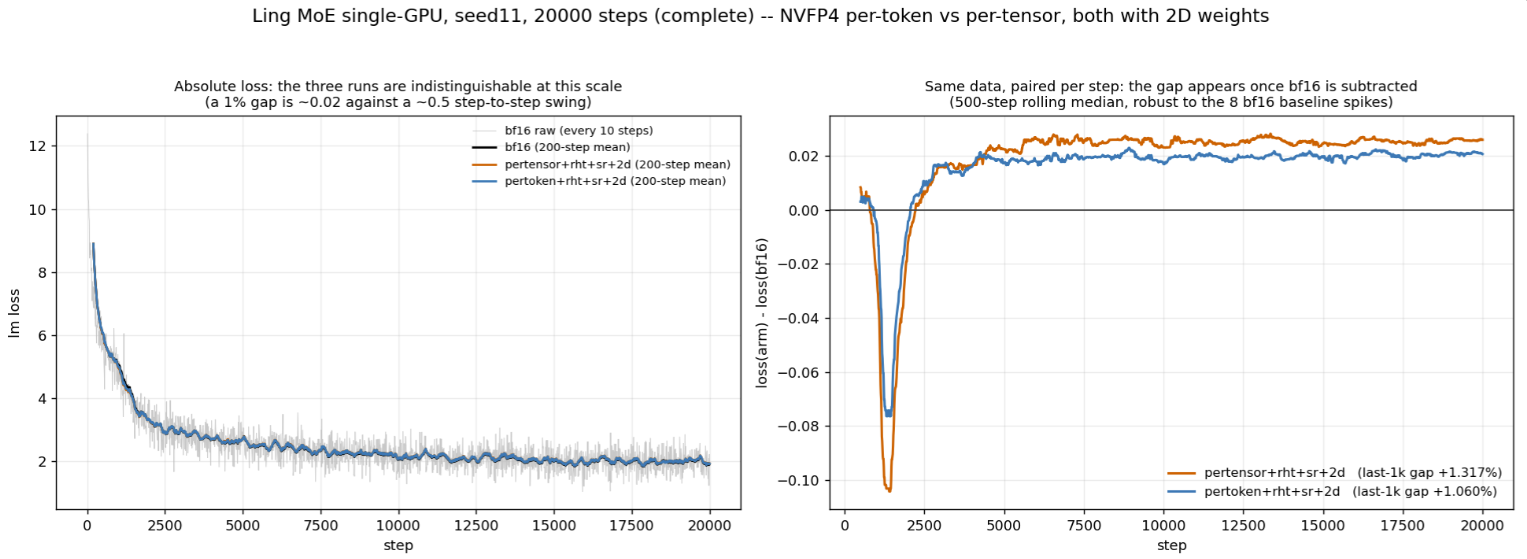
per-token 缩放为每一行单独计算外部缩放因子,减少了与其他 token 最大值的依赖,并能缓解行间幅度差异大时块缩放下溢的问题。在 20k 步语言模型损失实验中,per-token 缩放相对 BF16 的损失差距(+1.060%)小于 per-tensor 缩放(+1.317%)。
miniTE 与 Transformer Engine 联合优化了哪些 NVFP4 计算路径?
联合优化包括:使用连续布局和偏移描述专家边界以直接调用分组 GEMM;在数据生产路径中融合 amax 计算(如 FC1 的排序+amax、FC2 的加权 SwiGLU+amax);以及内核级优化如跨 CTA 的 amax 归约、FC1/FC2 的 GEMM 分块与流水线选择、融合 swizzle 写入缩放布局和激活/尾声融合。
TRIAGE 在数学任务上的实际训练效果如何?
在 4B 模型上,TRIAGE 完成 600 步训练,五任务平均得分为 58.49%,接近 BF16 的 58.26%;在 30B 模型上完成 1700 步,平均得分 70.96%,略低于 BF16 的 72.41%。在相同 300 步预算下,TRIAGE 得分为 53.03%,比原生 NVFP4 和 TIS 分别高 5.93 和 2.27 个百分点。
原生 NVFP4 强化学习目前还存在哪些局限?
文章指出,在实际在线 RL 运行中,权重转换和同步开销抵消了采样收益;实际 miniTE 检查点在五任务均值上仍低于 BF16。此外,匹配算子和获得小差距并不能保证达到 BF16 级别的学习效果,误差容忍度、更新规则和最终结果仍需进一步研究。
