


搭建高效的 ELFK 7.X 集群:ELK、Kafka 与 Filebeat 的完整指南
内容提要
本文介绍了如何搭建高效的ELFK 7.X集群,包括ELK、Kafka和Filebeat的配置与优化,涵盖集群服务版本、服务器环境、系统参数优化、Zookeeper和Kafka的部署步骤,以及Elasticsearch和Kibana的安装与配置,最后介绍了Filebeat和Logstash的设置,以确保日志数据的高效处理与传输。
延伸解读
系统参数调优:保障集群稳定运行的关键步骤
文章强调在部署前需对三个节点进行系统参数优化,包括修改主机名、增加文件描述符、调整内存限制和内核参数。这些设置直接影响Elasticsearch和Kafka在高并发下的稳定性,例如关闭交换内存、提高vm.max_map_count等。若忽略这些步骤,可能导致服务启动失败或性能瓶颈,因此务必在部署前完成并重启生效。
Zookeeper与Kafka集群部署:配置要点与验证方法
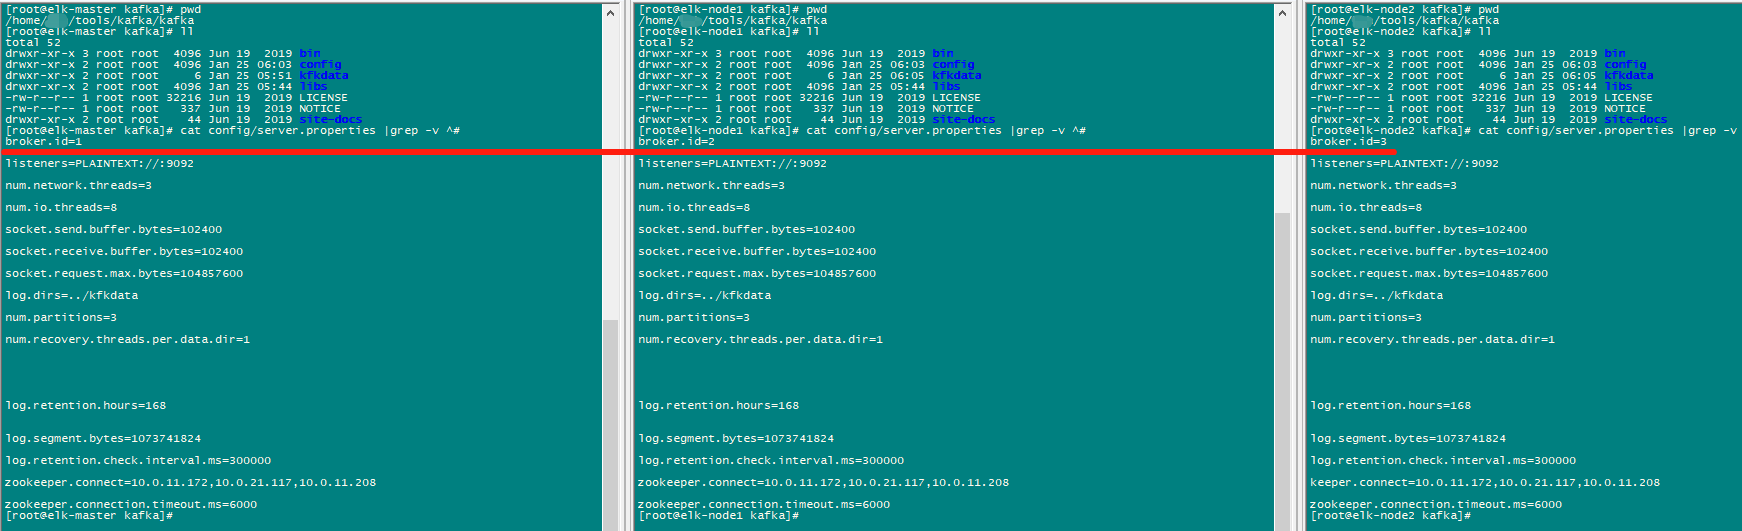
Zookeeper集群需在每个节点创建数据目录、配置zoo.cfg并写入myid,启动后通过zkServer.sh status检查角色。Kafka集群则需修改broker.id、配置Zookeeper连接,并创建topic进行消息发布订阅测试。文章提供了具体命令和配置示例,帮助读者验证集群是否正常工作,避免因配置错误导致数据丢失或服务不可用。
Elasticsearch安全配置:xpack认证与证书管理
文章详细介绍了启用xpack安全功能后的配置流程,包括生成CA和证书、为内置用户设置密码。过程中可能遇到集群状态未恢复导致的503错误,需等待集群稳定后再操作。证书需拷贝到所有节点并正确授权,否则节点间通信会失败。这些步骤对生产环境的数据安全至关重要,但配置不当可能增加部署复杂度。
Filebeat与Logstash集成:日志管道优化实践
Filebeat配置为将日志推送至Kafka,通过设置queue.mem.events、max_bytes等参数平衡吞吐量与资源占用。Logstash则从Kafka消费数据,经filter处理后输出到Elasticsearch,并支持按日期动态索引。文章还提供了systemd服务配置,确保进程稳定运行。读者需根据业务日志量调整参数,避免内存溢出或延迟过高。
Q&A
如何搭建ELFK 7.X集群?
搭建ELFK 7.X集群需要配置ELK、Kafka和Filebeat,并进行相应的安装和优化。
ELFK集群中使用的主要软件版本有哪些?
主要软件版本包括Java 1.8.0_221、Elasticsearch 7.10.1、Filebeat 7.10.1、Kibana 7.10.1、Logstash 7.10.1、Kafka 2.12-2.3.0和Zookeeper 3.5.6。
如何优化ELFK集群的系统参数?
优化系统参数包括修改主机名、增加文件描述符、优化内存限制和内核设置。
Zookeeper的部署步骤是什么?
Zookeeper的部署步骤包括创建项目目录、下载解压、修改配置文件、启动集群和检查状态。
如何配置Kafka以支持ELFK集群?
Kafka的配置包括下载解压、配置服务器、启动集群和创建topic。
Filebeat在ELFK集群中如何使用?
Filebeat用于将日志推送到Kafka,并需要进行相应的配置和服务启动。
