


RAIL:从人类认知能力视角重新审视大型音频语言模型的听觉智能
内容提要
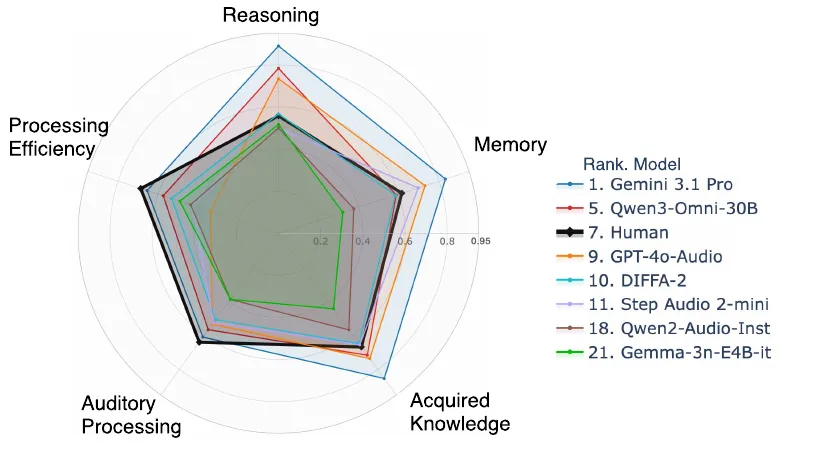
RAIL借鉴CHC认知框架,将音频评测重构为听觉处理、推理、记忆、知识、处理效率五类能力、32项细分任务,构建5306条样本。评估26款音频大模型发现:模型善用语义线索但精细声学感知弱;语音记忆强而非语音记忆普遍不足60%;多步顺序推理易出错;推理预算利用效率差异明显。研究主张按能力维度定位短板,推动音频模型在感知、记忆与效率上改进。
延伸解读
能力分类为何比任务分类更有解释力
文章指出,按语音、环境声、音乐或转写、分类、问答等任务类型组织评测,难以揭示任务背后的能力需求。例如,同样是音频问答,辨认相近声音、回忆先前声音、按顺序推断事件,分别对应感知、记忆和推理。RAIL借鉴CHC认知框架,先定义能力再设计任务,使评测结果能定位模型在具体能力维度上的短板,而非仅比较任务得分。
语义优势与声学短板并存
评估26款音频大模型发现,模型在可借助语言线索的任务上表现较好,跨模型得分中位数约56%—74%;但在依赖音高、节奏、音素细节的纯感知任务上,中位数仅约31%—42%,声源定位约28%。这说明模型更善于利用语义和上下文,对精细声学信息的掌握仍不足。综合排名高的系统,在基础听觉处理上也可能失分。
语音记忆强,非语音记忆弱
语音短时记忆任务中,部分模型得分达100%,多个开源模型超过70%;但非语音声音模式记忆任务中,所有受测模型得分均未超过60%,最好的约59%。文章强调,长音频理解不仅涉及“说了什么”,还包括声音如何出现和变化。评估长音频能力时,语音与非语音记忆需分别检验,不能因语音记忆强而忽略非语音记忆的不足。
推理效率应纳入评估视野
RAIL提出B-AUC,汇总不同推理token预算下的正确率,衡量模型能否用较少推理输出答对。受测模型中,正确率与推理长度关系较弱,开源模型参数规模与B-AUC也无清晰相关。文章提示,复杂任务需充分推理,简单任务应尽早给出可靠答案;对交互式音频模型,评测应同时观察正确率与输出行为,以发现总分之外的改进空间。
Q&A
RAIL 基准测试是基于什么认知框架来构建的?
RAIL 借鉴了 Cattell–Horn–Carroll(CHC)认知能力框架,将听觉智能分解为具体、可测试的狭义能力,并据此设计任务和解释模型表现。
RAIL 将音频评测分为哪几类核心能力?
RAIL 将评测组织为 5 类核心能力:听觉处理、推理、记忆、知识、处理效率,共 32 项细分任务。
RAIL 基准包含多少样本和音频时长?
RAIL 构建了 5306 条样本,总音频时长约 30.6 小时,其中 68.1% 为新构建样本。
在 RAIL 评估中,音频大模型在听觉处理方面表现如何?
模型在听觉处理维度整体弱于人类(人类得分 64.0,最高模型 61.0)。对于能借助语言线索的任务,模型中位数得分约 56%—74%;而依赖音高、节奏和音素细节的纯感知任务,中位数仅约 31%—42%,声源定位约 28%。
模型在语音记忆和非语音记忆上的表现有什么差异?
模型语音短时记忆较强,例如 Gemini 2.5 Flash 和 Gemini 3.1 Pro 得分达 100%,多个开源模型超过 70%;但在非语音声音模式记忆任务上,所有模型得分均未超过 60%,最好的 Gemini 3.1 Pro 约 59%。
RAIL 中的 B-AUC 指标是用来衡量什么的?
B-AUC 汇总不同推理 token 预算下的正确率,衡量模型能否用较少的推理输出获得正确答案,即推理预算的使用效率。
RAIL 评估发现了模型在多步顺序推理上的什么主要问题?
多数受测开源模型在顺序推理任务上得分低于 50%。模型需要依次识别声音对应的规则、执行操作并更新中间状态,但容易在状态更新环节出错,导致最终答案偏离。
