

思维树:利用大语言模型进行深度问题解决 [译]
内容提要
本文提出思维树(ToT)框架,扩展思维链提示,使大语言模型在连贯思维单元中探索多条推理路径,并通过自我评估与广度优先、深度优先等搜索算法进行规划、前瞻和回溯。在24点游戏、创意写作和迷你填字任务上,ToT显著优于IO、CoT等方法,24点成功率由4%提升至74%。该框架通用、模块化、无需额外训练,但计算成本较高。
延伸解读
从“系统1”到“系统2”:ToT的认知启发
文章借用双过程理论,将语言模型逐词生成比作快速、自动的“系统1”,而ToT引入的规划、评估与回溯则类似深思熟虑的“系统2”。这一类比不仅解释了为何CoT在需要探索的任务上表现不佳,也指明了改进方向:不改变模型本身,而是通过外部搜索框架激发其策略性推理。读者可借此理解ToT的设计哲学——用语言化的自我评估替代预编程或学习的启发式。
性能提升显著,但代价是计算成本
在24点游戏上,ToT将GPT-4的成功率从CoT的4%提升至74%,创意写作和填字游戏也有明显改进。然而,这种提升并非免费:ToT需要生成并评估多个思维分支,消耗的API调用和计算资源远高于简单采样。文章明确指出,ToT在GPT-4已擅长的任务上可能并非必需,其模块化设计允许用户在性能与成本间权衡。读者应意识到,ToT更适合那些需要规划或搜索的复杂问题。
搜索策略与评估器的关键作用
ToT的效果高度依赖两个组件:思维生成器和状态评估器。文章通过消融实验显示,在填字游戏中移除剪枝或回溯会显著降低成功率,而使用“神谕”最佳状态则能进一步提升表现。这表明,设计合适的启发式评估(如让模型判断状态“确定/可能/不可能”)至关重要。读者在应用ToT时,需根据任务特点定制思维粒度和评估方式,而非简单套用固定模板。
局限与未来方向:不止于推理任务
文章坦承,ToT目前仅在三个相对简单的任务上验证,且主要使用现成模型。未来可探索将ToT风格的高层决策融入微调,或结合更复杂的搜索算法(如A*、MCTS)。此外,ToT产生的可读推理过程增强了可解释性,但也可能被滥用。读者应关注其通用性边界:对于开放域、多模态或实时交互场景,ToT的适用性仍需进一步研究。
Q&A
思维树(ToT)框架是什么?它和思维链(CoT)有什么区别?
思维树(ToT)是对思维链(CoT)提示方法的扩展,它让语言模型在连贯的文本单元(称为“思维”)中探索多条推理路径,并通过自我评估和搜索算法(如广度优先搜索、深度优先搜索)进行规划、前瞻和回溯。与CoT仅按顺序生成一条思考链不同,ToT维护一个树形结构,每个节点是一个部分解决方案,允许模型评估不同思维并选择最佳路径。
ToT在24点游戏上的表现如何?相比其他方法提升了多少?
在24点游戏中,使用思维链(CoT)提示的GPT-4成功率仅为4.0%,而ToT方法在宽度b=5时成功率达到74%,显著优于IO提示(7.3%)、CoT-SC(9.0%)等方法。即使宽度b=1时,ToT也达到了45%的成功率。
ToT框架包含哪些核心组件?如何实现?
ToT框架需要回答四个问题:1)如何将问题解决过程分解成单独的思维步骤;2)如何从每个状态中产生可能的思维(通过思考发生器,可采用独立同分布采样或提案提示);3)如何用启发式方法评估这些状态(通过状态评估器,可独立评价或跨状态投票);4)使用哪种搜索算法(如广度优先搜索BFS或深度优先搜索DFS)。这些组件模块化,可独立调整。
ToT方法有哪些优势和局限性?
优势包括:通用性(IO、CoT等可视为ToT的特例)、模块化(各组件可独立改变)、适应性(适应不同问题属性和资源限制)、方便性(无需额外训练)。局限性主要是计算成本较高,相比抽样方法需要消耗更多资源(如GPT-4 API成本),且目前仅在三个相对简单的任务上验证,未来需探索更复杂场景。
ToT在创意写作任务中是如何应用的?效果如何?
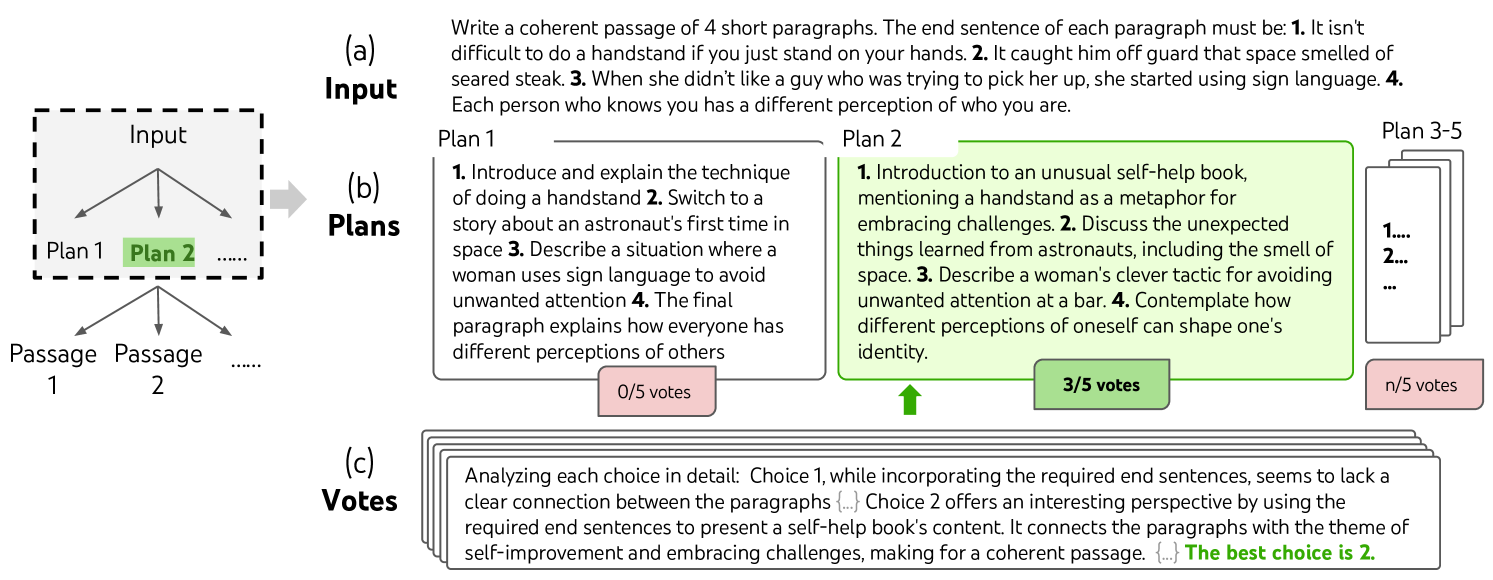
在创意写作任务中,ToT构建深度为2的树:首先生成5个写作计划,通过投票选出最佳计划,然后基于该计划生成5个文段并再次投票选出最佳。评估显示,ToT的连贯性得分(7.56)高于IO(6.19)和CoT(6.93),人类评审在41组中更偏爱ToT方案(对比CoT的21组)。
ToT在迷你填字游戏中的表现如何?搜索策略有什么特点?
在5x5迷你填字游戏中,ToT采用深度优先搜索(DFS),单词成功率达到60%,解决了20个挑战中的4个,而IO和CoT的单词成功率不到16%。DFS会优先探索最有前景的单词提示,当评估器判断当前状态无法完成时进行剪枝并回溯。实验还表明,去除剪枝或回溯会降低效果,而使用最佳状态(Oracle)可解决7/20个游戏。
