

7 个小巧专用模型,在单一任务上胜过巨型大语言模型
内容提要
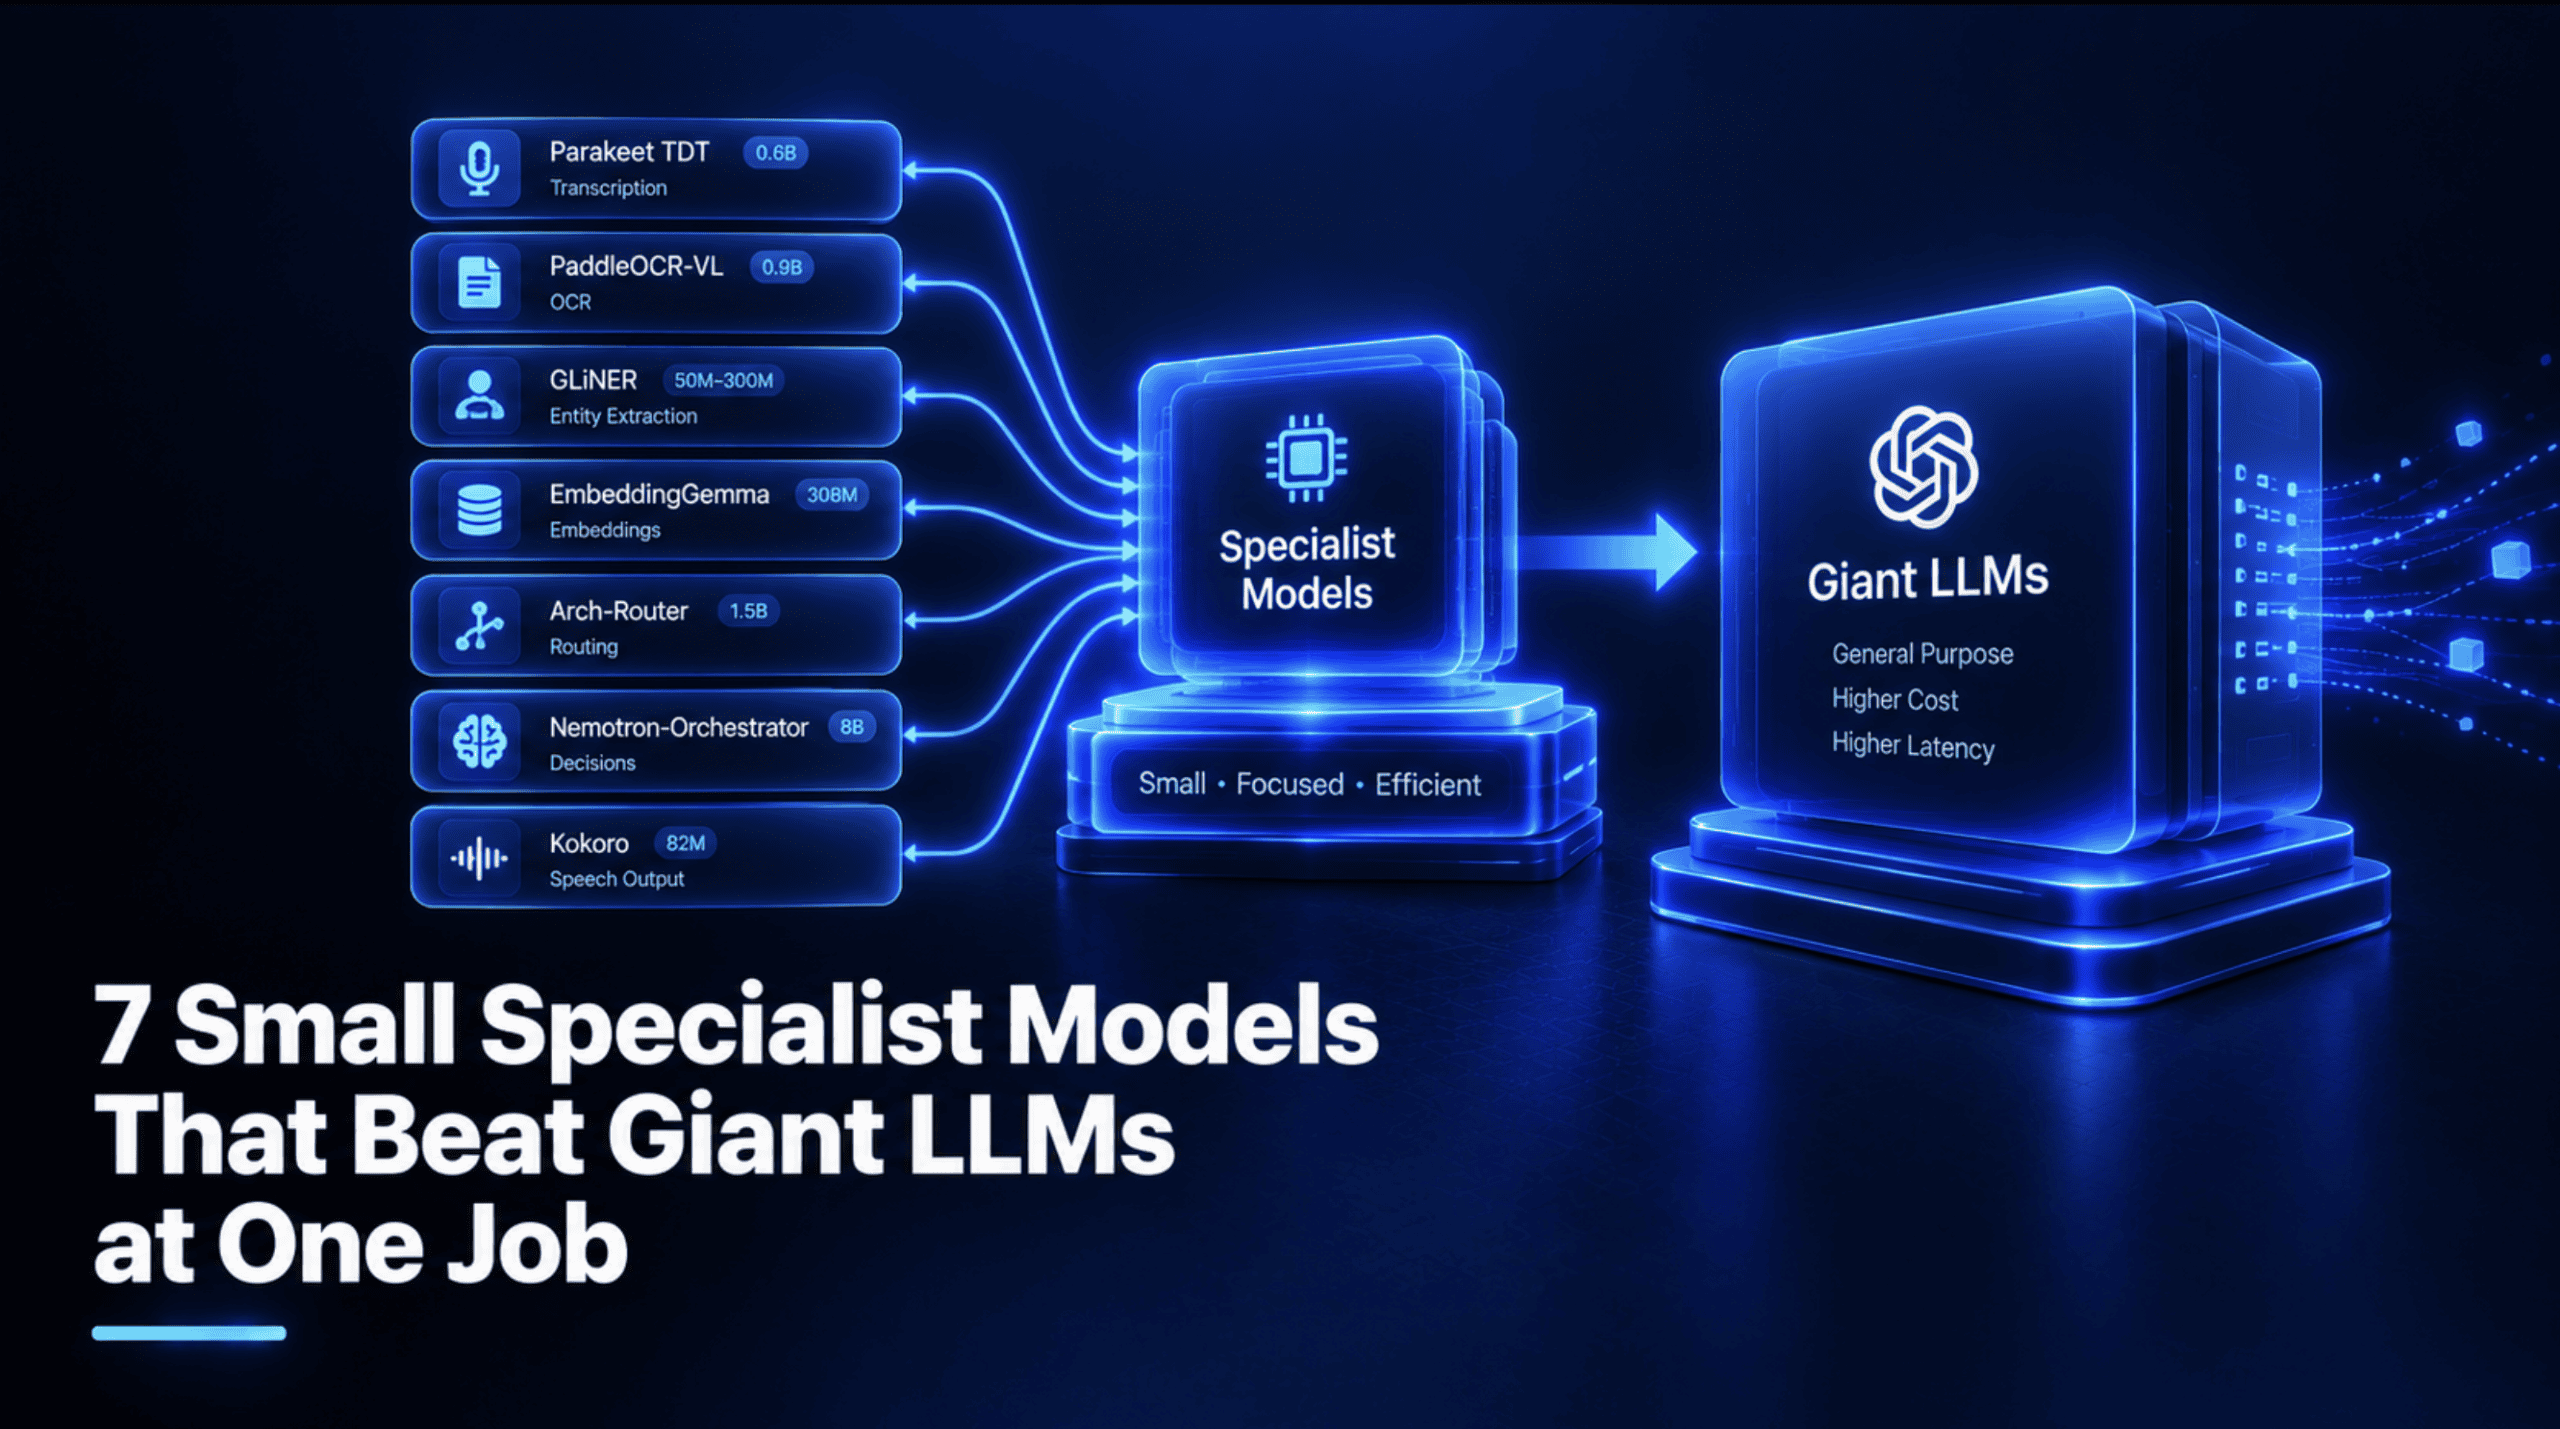
文章介绍七个参数量均低于100亿的开源专用小模型,可分别替代大模型完成单一任务:Parakeet转写、PaddleOCR-VL文字识别、GLiNER实体抽取、EmbeddingGemma向量嵌入、Arch-Router路由、Nemotron-Orchestrator决策、Kokoro语音合成。文中给出各模型的规模、许可证、对比大模型的公开证据及本地运行代码,并指出语言覆盖窄、仅限研究用途等局限。作者建议按任务替换试用,保留大模型处理其独有能力。
延伸解读
“以小胜大”的边界:专用任务与通用能力的区别
文章列举的七个模型均在单一任务上以更小参数量取得优势,但需注意其对比对象并非全是通用大语言模型。例如Parakeet击败的是Whisper large-v3语音模型,Kokoro对比的是其他TTS模型,EmbeddingGemma的领先也仅限500M参数以下的嵌入模型类别。真正与GPT-5、Gemini 3 Pro等前沿大模型直接比较的只有PaddleOCR-VL和Nemotron-Orchestrator,且后者仍会在约40%的步骤中调用GPT-5。因此,这些模型适合替换流水线中的特定环节,而非整体替代大模型。
许可证与用途限制:部署前必须核对的硬约束
七个模型中,Parakeet、PaddleOCR-VL和Kokoro采用Apache 2.0或CC-BY-4.0等宽松许可,商用限制较少;但Nemotron-Orchestrator-8B明确标注仅限研究开发,Arch-Router使用Katanemo自有研究许可,EmbeddingGemma受Gemma条款约束且需在Hugging Face上接受许可。GLiNER的仓库虽为Apache-2.0,但个别检查点可能采用CC BY-NC 4.0等非商用许可。实际选型时,应逐一核对具体检查点的许可证,避免因许可问题导致合
性能证据的时效性与比较基准需谨慎解读
文章引用的多项对比数据存在时效或基准差异。例如GLiNER对比的ChatGPT是2023年版本,Nemotron-Orchestrator对比的GPT-5已非当前前沿,Kokoro在2026年的语音竞技场排名已降至第六,被NVIDIA Magpie超越。PaddleOCR-VL在OmniDocBench v1.6上虽领先Gemini 3 Pro和GPT-5.2,但同榜单中TeleOCR和OvisOCR2分数更高,应理解为“前三”而非“第一”。读者在参考这些证据时,需结合自身数据重新评测,而非直接套用文章结论。
本地运行的工程成本:环境隔离与硬件门槛
文章建议为每个模型创建独立的虚拟环境,因为NeMo、Paddle和vLLM等框架依赖不同版本的PyTorch,混用易产生冲突。部分模型有额外要求:EmbeddingGemma需登录Hugging Face并接受许可,Kokoro需安装espeak-ng系统包。硬件方面,Parakeet模型卡建议至少2GB内存,Nemotron-Orchestrator-8B按文章估计需24GB显存的GPU。首次运行需下载权重,可能耗时较长。这些工程细节直接影响本地部署的可行性与成本,需提前规划。
Q&A
有哪些参数量低于100亿的开源小模型可以在单一任务上替代大模型?
文章介绍了七个专用小模型:Parakeet TDT 0.6B v3(转写)、PaddleOCR-VL-1.6(OCR)、GLiNER(实体抽取)、EmbeddingGemma(向量嵌入)、Arch-Router(路由)、Nemotron-Orchestrator-8B(决策)、Kokoro-82M(语音合成)。它们均满足开放权重、单一任务、有公开对比证据、可在单机运行四个条件。
Parakeet TDT 0.6B v3 和 Whisper large-v3 相比,准确率和速度怎么样?
根据 Open ASR Leaderboard 论文,Parakeet v3 平均词错误率为 6.32,Whisper large-v3 为 7.44;吞吐量(RTFx)Parakeet 为 3,330,Whisper 为 146,约快 23 倍且错误更少。但 Whisper 支持 99 种语言,Parakeet 仅支持 25 种欧洲语言,且在追踪的六种其他欧洲语言中有五种落后于 Whisper。
PaddleOCR-VL-1.6 在文档解析任务上真的能超过 Gemini 3 Pro 和 GPT-5.2 吗?
根据论文,PaddleOCR-VL-1.6 在 OmniDocBench v1.6 上总体得分为 96.33,高于 Gemini 3 Pro 的 92.91 和 GPT-5.2 的 86.59。但同一评测中 TeleOCR(96.91)和 OvisOCR2(96.47)排名更高,因此它属于前三,并非第一。
GLiNER 做实体抽取有什么特别之处?使用时要注意什么?
GLiNER 允许在运行时以字符串形式传入任意标签(如“Person”“Invoice number”),无需重新训练即可改变抽取目标。50M 参数的 GLiNER-S 在零样本 NER 上平均得分 52.7,高于 ChatGPT 的 47.5。注意:对比的是 2023 年的 ChatGPT;它只抽取文本片段,不进行推理或补全缺失信息;不同检查点的许可证可能不同,需确认。
Arch-Router 路由模型的效果和速度如何?部署时需要注意什么?
Arch-Router 参数量 1.5B,论文报告整体路由得分 93.17%,比测试的专有模型(包括 GPT-4o 和 Claude-Sonnet-3.7)平均高 7.71%。每次决策约 50 毫秒,远快于 Gemini-2.0-flash-lite(约 510 毫秒)和 Claude-Sonnet-3.7(约 1,450 毫秒)。它仅负责路由,需要自行配置下游模型;路由描述的质量直接影响效果,且许可证为 Katanemo 研究许可,商用前需阅读条款。
Nemotron-Orchestrator-8B 在决策任务上能打败 GPT-5 吗?可以商用吗?
在 Humanity's Last Exam 上得分为 37.1%,高于 GPT-5 的 35.1%,成本约为 30%,速度快 2.5 倍;在 FRAMES 和 τ²-Bench 上也领先。但它赢在决定调用哪个工具或模型,在 τ²-Bench 中仍有约 40% 的步骤调用 GPT-5 等大模型。许可证为 NVIDIA 研究许可,仅限研发用途,目前不能用于生产环境。
