


推出 AptMQL-Bench:一个 Text-to-MQL 基准
内容提要
本文介绍AptMQL-Bench:将现有Text-to-SQL数据集转换为Text-to-MQL基准,包含21个MongoDB数据库和3186条自然语言请求。作者提出由编码智能体驱动、人工审核的三阶段转换流程:基于访问模式的模式设计、数据迁移与校验、SQL到MQL翻译及优化。相比机械转换,该方案实现无损迁移且查询速度显著更快。评测显示该基准对模型仍有挑战,最强模型Claude Opus 4.5仅达70.34% Soft-EX,并提出软执行准确率指标。
延伸解读
机械转换的陷阱:数据丢失与性能瓶颈
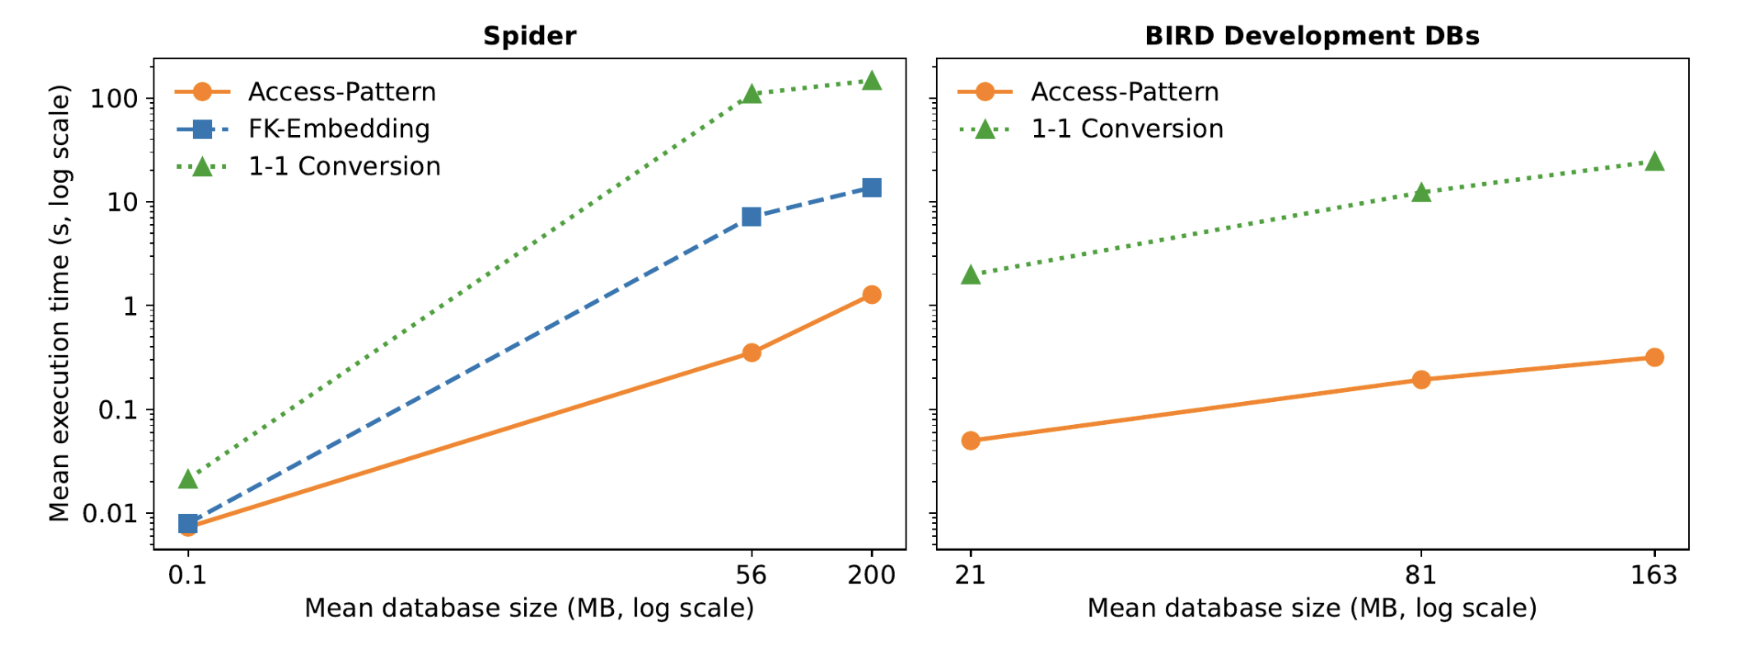
文章指出,将关系型数据机械转换为MongoDB文档模型存在显著风险。实验显示,沿外键嵌入的策略在24个数据库中有6个迁移失败,8个出现数据丢失,最坏行丢失率达25.9%。即使是一对一映射,虽然无损,但查询性能随数据量增长急剧下降。这提醒开发者,简单的结构转换可能掩盖数据完整性和扩展性问题,需在迁移前评估访问模式。
访问模式驱动的模式设计:性能提升的关键
AptMQL-Bench采用基于访问模式的模式设计,将常一起访问的数据嵌入同一文档。在200MB数据量下,其MQL查询速度比外键嵌入快约11倍,比一对一映射快两个数量级。这表明,针对实际查询负载设计文档模式,而非机械映射,能大幅提升MongoDB的查询效率,尤其适合数据量增长较快的场景。
Soft-EX指标:更贴合MongoDB实践的评估方式
传统Strict-EX要求返回结果与标准答案字段完全一致,但MongoDB中返回整个文档是常见做法。Soft-EX允许预测结果包含额外字段,只要核心字段值匹配即可。在Claude Opus 4.5上,Soft-EX得分70.34%,而Strict-EX仅50.44%。人工复核发现,所有差异均因额外字段导致,说明Soft-EX能更公平地反映模型在真实MQL场景下的语义理解能力。
模型表现:语义理解仍是主要挑战
评测的八个模型中,最强模型Claude Opus 4.5在提供外部知识时Soft-EX仅70.34%,无知识时57.38%。外部知识普遍带来12-19个百分点的提升。值得注意的是,部分模型生成可执行MQL的比例高达98-99%,表明语法错误已少见,剩余错误多源于语义误解。这提示未来改进方向应聚焦于提升模型对查询意图和数据库模式的理解,而非单纯纠正语法。
Q&A
AptMQL-Bench 是什么?它包含哪些内容?
AptMQL-Bench 是一个 Text-to-MQL 基准,通过转换现有 Text-to-SQL 数据集构建。它包含 21 个新的 MongoDB 数据库和 3,186 条自然语言请求,这些请求迁移自 BIRD 数据集,覆盖商业、科学、体育和金融等领域。
为什么需要专门为 MQL 构建基准?现有方法有什么问题?
MQL 是 MongoDB 的查询语言,尽管 MongoDB 很流行,但 MQL 受到的关注较少。现有的 Text-to-MQL 方法要么基于原生 MongoDB 数据(如 NL-to-mongosh 数据集),要么机械地转换 Text-to-SQL 数据集(如 DocSpider 的一对一映射、TEND-v2 的外键嵌入)。机械转换存在缺陷:外键嵌入可能导致无限递归、文档超过 16 MB 限制、行丢失(最坏 25.9%),并且生成的模式可扩展性差。
AptMQL-Bench 的转换流程分为哪几个阶段?
转换流程分为三个阶段:1)基于访问模式的模式设计:智能体推断应用场景和访问模式,设计概念和逻辑模式,确保数据访问模式符合 MongoDB 的黄金法则;2)迁移与验证:执行迁移后运行三项自动检查(数据一致性、引用完整性、无遗漏),人工审核修复问题;3)SQL 到 MQL 翻译与优化:智能体翻译查询并确保结果一致,然后进行第二遍优化,使用嵌入字段和预计算聚合,45.32% 的查询被优化。
基于访问模式的模式设计相比机械转换有哪些优势?
基于访问模式的模式设计实现了无损迁移(24 个数据库全部无损),而外键嵌入方法在 6 个数据库上失败,8 个有损。在查询执行时间上,当数据库大小达到 200 MB 时,访问模式 MQL 比外键嵌入快约 11 倍,比一对一迁移快约两个数量级(Spider 数据集);在 BIRD 数据集上,比一对一迁移快 40 到 77 倍。
AptMQL-Bench 上各大语言模型的表现如何?
评测了 8 个模型(5 个开源,3 个专有)。最强模型 Claude Opus 4.5 在无外部知识时 Soft-EX 为 57.38%,有外部知识时达到 70.34%。外部知识对所有模型都有帮助,提升 12-19 个百分点。最新模型(如 Gemma 4 和 Claude 系列)生成可执行 MQL 的比例约 98-99%,表明语法错误已很少,主要挑战在于语义。
为什么提出 Soft-EX 指标?它与 Strict-EX 有何不同?
Strict-EX 要求返回结果与金标准逐字段完全相等,因此返回整个文档(即使包含正确答案)会被判错,但这在 MongoDB 中是惯用做法。Soft-EX 允许预测结果包含额外字段,只要返回的行与金标准相同且每个金标准字段的值匹配即可。例如,返回包含额外字段的文档在 Soft-EX 下正确,在 Strict-EX 下错误。人工审核了 634 个两种指标不一致的查询,确认差异仅在于额外字段。
