
华为昇腾如何跨越CUDA生态鸿沟
内容提要
华为提前9个月发布昇腾960,并全面开源CANN,旨在跨越英伟达CUDA生态鸿沟。华为通过遵守开源规则、捐赠资金和派遣工程师维护vLLM、PyTorch等项目,使昇腾获得主流系统接纳。目前昇腾在推理场景已可用,但预训练仍困难,仅有美团LongCat等少数案例。结论:在封闭市场同时尊重开源规则,才能突破生态壁垒。
延伸解读
生态壁垒的本质:时间与确定性
文章指出,英伟达真正的护城河是CUDA生态,而非单纯芯片性能。AI研究员从学生时代就使用PyTorch和CUDA,迁移到新生态需要数月适配,且面临框架Bug、版本滞后等风险。在竞争激烈的AI行业,时间与确定性比金钱更宝贵,晚一个月发布模型就可能出局。因此,除非新生态有数量级优势,否则用户不会轻易迁移。
昇腾的敲门砖:守规矩与讲礼貌
与鸿蒙早期在开源社区灌水、拍门不同,昇腾这次通过捐赠资金、派遣工程师全职维护vLLM、PyTorch等项目,以提交代码和修复Bug的方式赢得信任。vLLM官方仓库已收录昇腾的vllm-ascend,PyTorch官网也将其列为第四家加速后端。这种从内部开门的策略,比强行推广更有效,也体现了对开源规则的尊重。
训练鸿沟:后训练可用,预训练仍难
文章明确区分训练阶段:后训练已有昇腾案例,如深圳河套学院在1000多张910C上完成DeepSeek V4-Pro后训练;但预训练仍困难,因卡间连接慢、长时间稳定运行成功率低。目前宣称用昇腾预训练的仅智谱GLM-4.7和美团LongCat-2.0,后者未明确供应商。主流模型如Kimi、DeepSeek等预训练仍依赖英伟达。
市场分工:训练用英伟达,推理与出海上昇腾
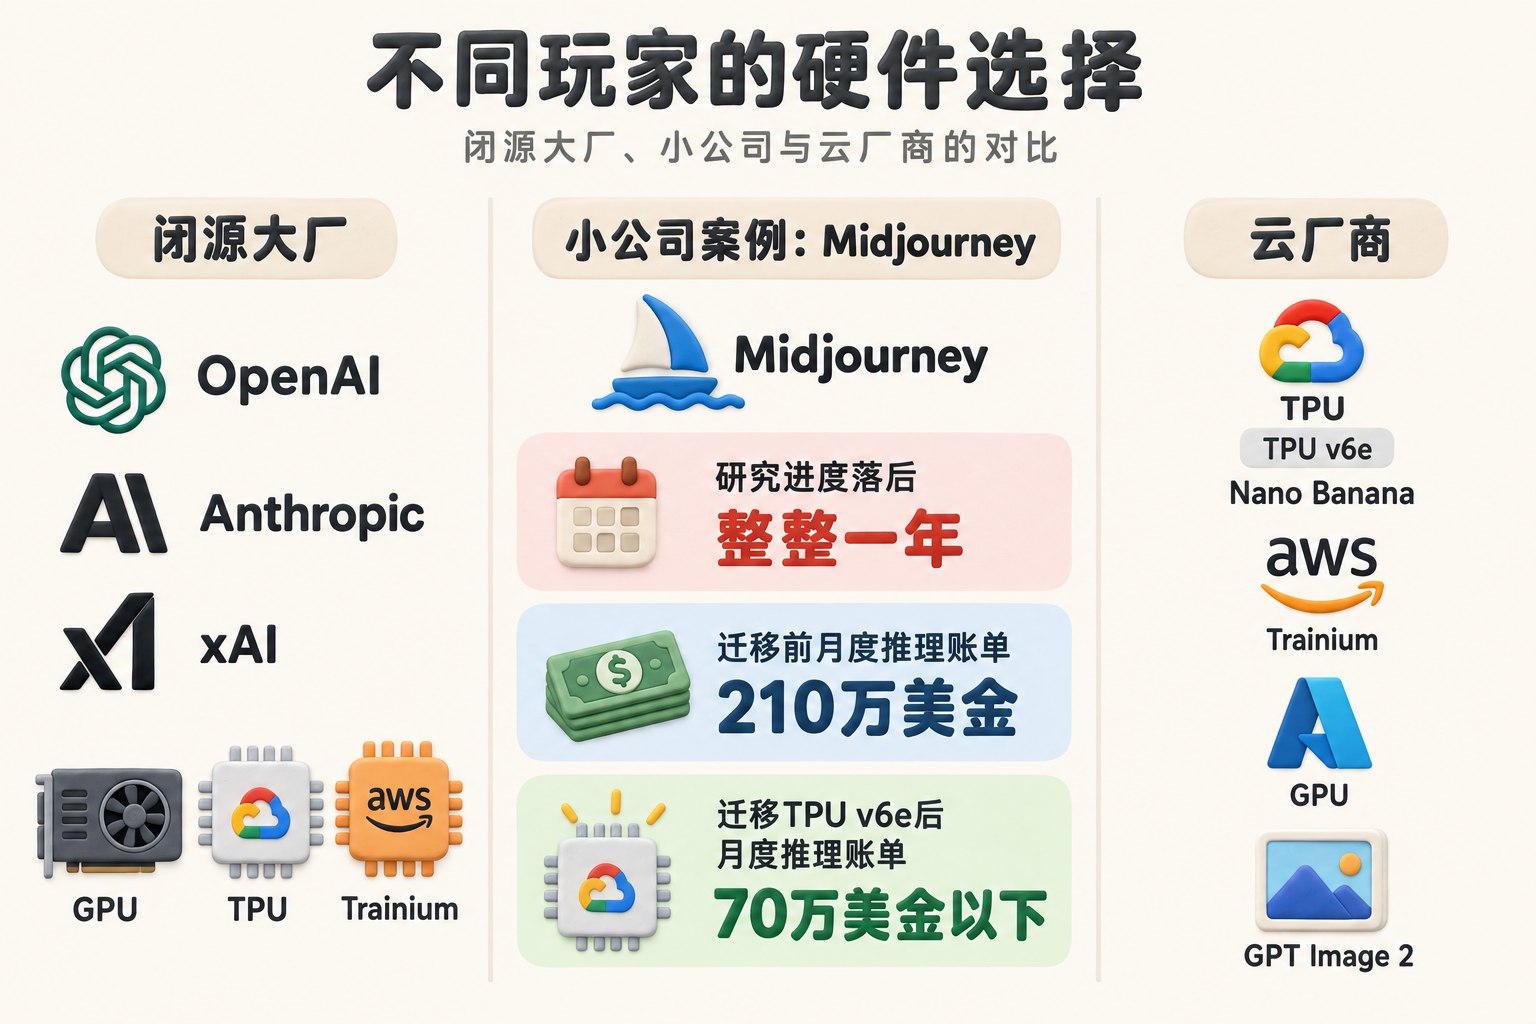
文章建议不同玩家算三笔账:大厂可自研或混用;小公司训练应优先英伟达,避免适配拖累进度;云厂商需承担适配成本,或直接采购华为。国内小模型公司可训练用英伟达、推理用昇腾,并借助华为云出海。华为已在中东、东南亚部署模型服务,昇腾硬件加中国模型正整套出海。
Q&A
华为昇腾960提前发布,但真正重要的是什么?
真正重要的是华为宣布CANN全面开源开放,进入常态化社区运营,昇腾生态跨过了从“可用”到“易用”的关键拐点,即正在跨越CUDA生态鸿沟。
英伟达的CUDA生态护城河为什么难以被打破?
CUDA自2007年发布已近20年,主流框架PyTorch与CUDA深度绑定,开源模型默认按其格式发布,工具链成熟。研究者从学习阶段就使用CUDA,迁移到新生态需要花费大量时间、人力和资金,且面临新框架Bug、版本滞后等风险,在竞争激烈的AI行业,时间和确定性至关重要,因此后来者难以替代。
华为昇腾这次是如何让开源社区接纳自己的?
华为遵守开源规则,向基金会捐钱,派遣工程师全职维护vLLM、PyTorch等项目,提交代码、修复Bug,并让昇腾仓库进入vLLM官方组织,成为国产芯片中唯一进入本家的。同时维护Triton分支并同步,将昇腾加入PyTorch官网下载页。通过守规矩、讲礼貌的方式,逐步获得开源社区信任。
昇腾在训练场景,尤其是预训练方面的现状如何?
后训练已有不少案例,如深圳河套学院等用1000多张910C完成DeepSeek V4-Pro后训练。但预训练仍很困难,因为卡间连接慢,长时间稳定运行成功率低,速度慢。目前宣称用昇腾预训练的有智谱GLM-4.7和美团LongCat-2.0,但前者后续不再强调,后者供应商未明确,且外部使用少。主流模型如Kimi、DeepSeek等预训练仍用英伟达。
不同规模的公司应该如何选择AI芯片?
闭源大厂可自研或混用多套硬件;小公司应避免自研芯片,训练用英伟达,推理可考虑TPU等省钱方案;云厂商需承担适配成本,可买英伟达或华为(华为替其完成适配)。国内小模型公司训练用英伟达,推理确保能在昇腾上跑,出海可用昇腾。
华为跨越CUDA生态鸿沟需要哪两个条件?
第一,一个封闭的市场,让英伟达无法进入,给国内厂商机会;第二,守规矩、讲礼貌,遵守开源社区规则,捐钱、出人、改代码,逐步赢得信任。两者缺一不可。
