华为提前9个月发布昇腾960,并全面开源CANN,旨在跨越英伟达CUDA生态鸿沟。华为通过遵守开源规则、捐赠资金和派遣工程师维护vLLM、PyTorch等项目,使昇腾获得主流系统接纳。目前昇腾在推理场景已可用,但预训练仍困难,仅有美团LongCat等少数案例。结论:在封闭市场同时尊重开源规则,才能突破生态壁垒。
DeepSeek因V4.1 Flash调用量暴涨219%而算力仅增8%,导致服务变慢、回答变短。为补缺口,计划部署十六万颗华为昇腾芯片,但交付需等到2027年。同时,自动化风控造成大量误封,用户申诉困难。算力紧张短期内难以缓解。
黄仁勋预计英伟达未来一年芯片销量翻番,称AI行业无需新监管。Anthropic称Claude主导其26%研发,与Rum Group签137亿美元算力协议,将在新加坡设办公室。OpenAI讨论新一轮融资,估值或超1.2万亿美元。甲骨文启动裁员以支持AI基建。华为昇腾960研发超预期,性能倍增。张一鸣首次成为亚洲首富。
赛力斯否认问界撤出华为门店,称部分门店保留销售;小米公开MiMo-V2.6训练成本超135万美元;Anthropic称Claude主导26%研发;豆包发布座舱助手;OpenAI将定期披露模型异常行为;华为昇腾960提前至明年一季度;Manus拟融资5亿美元;恒大汽车退出制造转电池贸易。
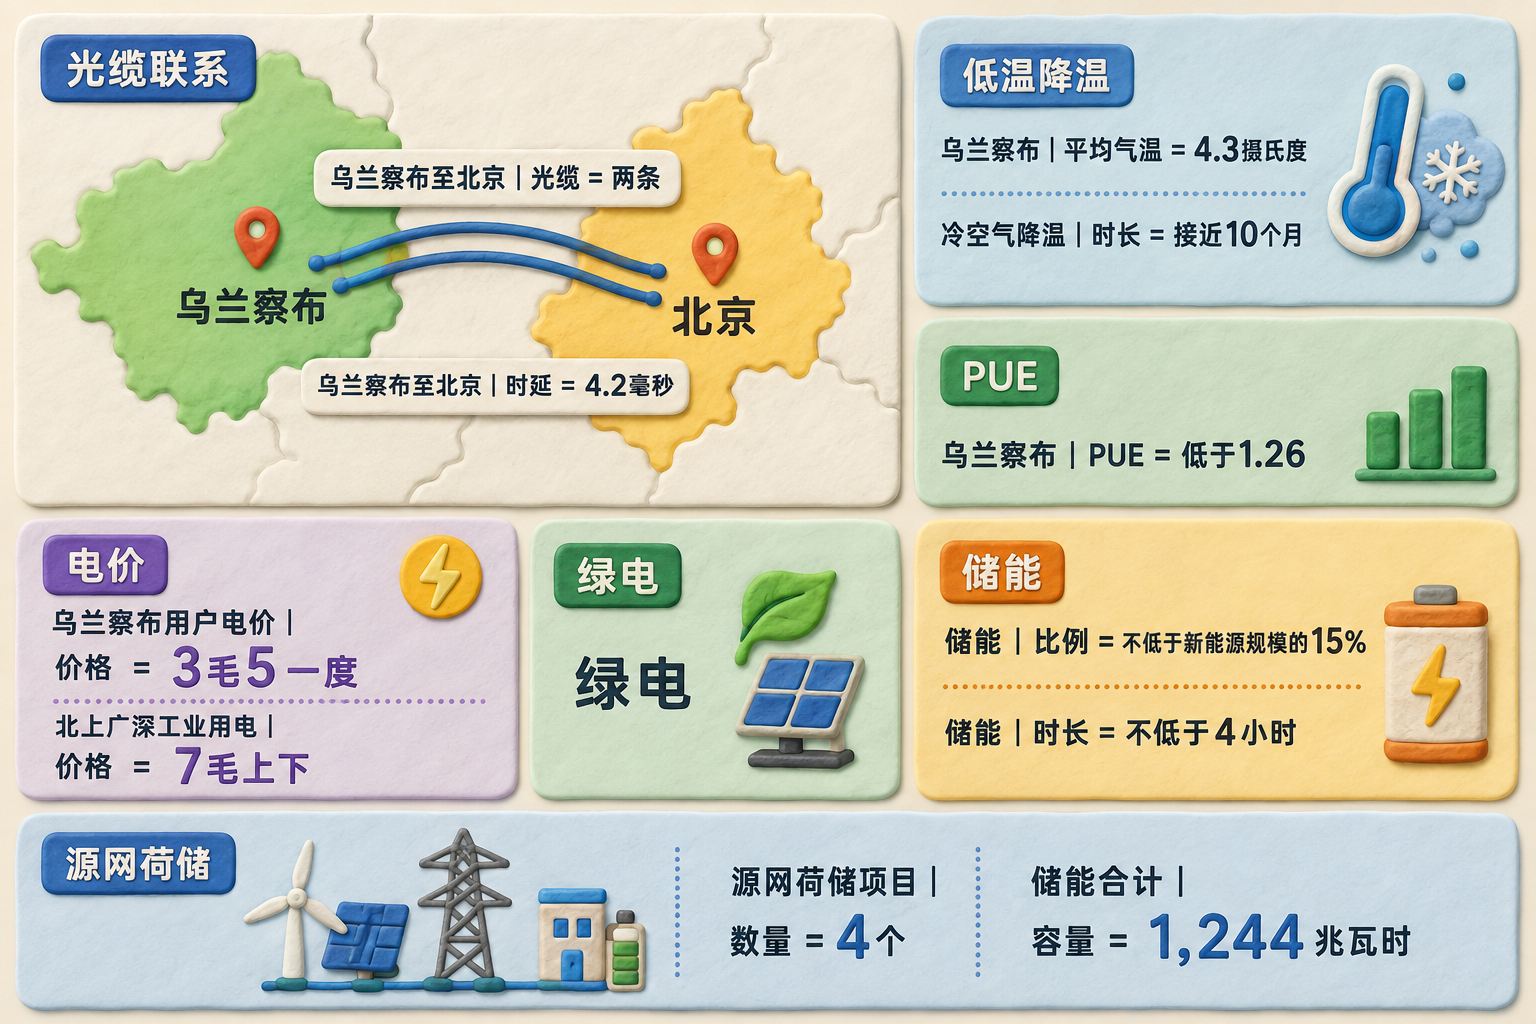
DeepSeek计划在内蒙古乌兰察布建设1吉瓦算力中心,部署16万枚华为昇腾950DT芯片用于推理,总投资约25.6亿美元。此举旨在回应此前梁文锋言论泄露,展示支持国产芯片,并推动融资。乌兰察布因电价低、气候冷、绿电充足而入选。美国因缺地电水受阻,中国则缺高端卡。项目预计2027年底投用,或影响未来AI成本及DeepSeek融资上市。
8月1日北京将举办AI编译器技术分享会,智源、TileRT、腾讯、华为昇腾、智元创新等专家出席。议题涵盖Triton语言扩展、TileRT低延迟推理、FalconGEMM低复杂度矩阵乘法、AscendNPU IR开源及具身智能编译器,探讨多层级协同优化。活动限150人,需报名。
面壁智能推出的BitCPM-CANN三值大模型显著降低显存需求,最高可节省6倍,同时保留97%的模型能力。该模型首次在华为昇腾平台上完成训练,支持多种应用场景,从手机到PC。通过三值量化技术,模型在保持性能的同时显著减少内存占用,为AI在终端设备的应用提供了新可能。
英伟达H200解禁后,中国在算力竞争中短期获利,但面临华为昇腾的压力。美国通过限制销售保护市场利益,英伟达则借此巩固CUDA生态。H200的引入可能影响国产芯片发展,未来算力战争仍在继续。
DeepSeek V4正式开源,华为昇腾首发,性能媲美顶级闭源模型。该模型包括V4-Pro和V4-Flash,支持百万token上下文,适配多款主流产品。国产芯片厂商获得早期访问权限,英伟达不再是唯一选择。阿联酋计划在两年内让AI Agent接管50%政府工作,小米预计AGI将在两年内实现,中美模型差距仅两三个月。
DeepSeek v3.2引入国产GPU语言TileLang,取代Triton,提升性能。TileLang简化GPU内核开发,支持华为昇腾,适合不同水平的开发者。DeepSeek团队利用TileLang快速开发原型,验证其在模型训练中的有效性。
魔乐社区推出阶跃星辰自研的Step-Video和Step-Audio开源大模型,支持华为昇腾架构。Step-Video-T2V是全球最大开源视频生成模型,具备高质量视频生成能力;Step-Audio为首款产品级开源语音交互模型。社区提供免费算力支持,方便用户体验,吸引众多企业关注。
本文介绍了如何将聆思CSK6大模型开发板接入华为昇腾版DeepSeek大模型,步骤包括创建应用、导入工程、配置参数和验证部署。成功接入后,用户可以通过开发板实现语音交互,验证DeepSeek的功能。
完成下面两步后,将自动完成登录并继续当前操作。