


vLLM 多副本如何复用 KV Cache?llm-d 缓存感知路由实战
内容提要
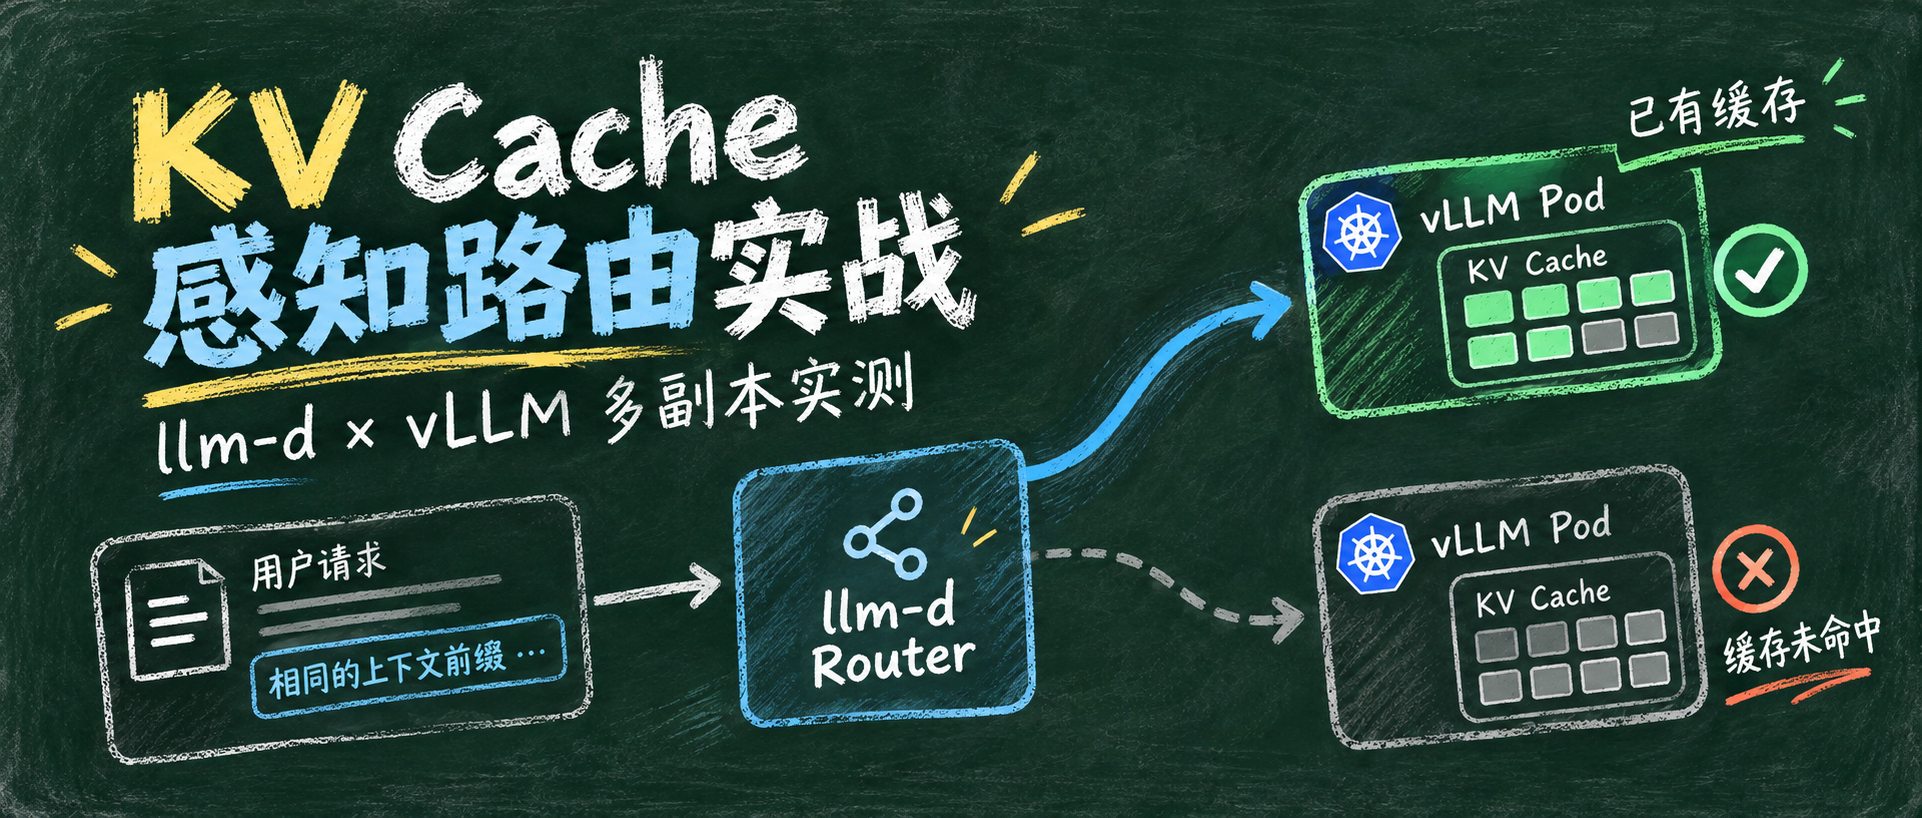
文章探讨多副本vLLM部署中KV Cache的复用问题:单实例APC仅能本地复用缓存,多副本需路由配合。llm-d Router通过近似前缀记录、评分与选点,将请求优先发往可能已有缓存的实例。实验对比随机路由与前缀感知路由,后者使后续请求100%回到原副本,前缀命中率由56.56%升至99.60%,Prefill token均值由2261.5降至21.0,TTFT P95由2018ms降至159.2ms。
延伸解读
缓存感知路由的收益集中在尾部延迟
实验显示,前缀感知路由将TTFT P95从2018ms降至159.2ms,但P50仅从155.1ms降至127.3ms。这是因为随机路由下约一半请求仍会回到原副本并命中缓存,这部分请求本就较快;收益主要来自避免请求落到冷副本后触发完整Prefill。因此,评估此类路由时,应重点关注P95等尾部指标,而非仅看平均延迟。
近似估算的边界:记录不等于缓存仍在
llm-d的Approximate方案依据历史路由记录推测缓存位置,部署简单且不依赖引擎事件,但记录的是请求分配历史,而非引擎实际缓存清单。若缓存已被驱逐或实例重启,估算可能与实际状态不符。文章也指出,Precise方案需处理事件延迟、丢失与索引重建问题。选择方案时需权衡部署复杂度与状态准确性。
命中率高不等于延迟低:需结合负载判断
文章明确提醒,缓存命中率高不一定代表请求延迟更低。若有缓存的实例队列很长,而无缓存的实例可立即计算,复用缓存省下的Prefill时间可能抵不过额外排队时间。此时前缀评分需与负载感知配合。本次实验全局并发为1且未叠加负载评分,结果适用于长上下文前缀、共享提示词等存在复用且负载不极端的场景。
Q&A
vLLM 多副本部署时,为什么单靠 APC 无法复用 KV Cache?
APC 只在单个实例内复用 KV Cache。多副本时,请求若被分到没有对应缓存的实例,就无法复用,需要重新计算 Prefill。因此需要路由配合,让请求尽量落到已有缓存的实例。
llm-d Router 是如何实现缓存感知路由的?
llm-d Router 通过 Approximate 插件根据历史路由记录估算各实例可能缓存的前缀块,再由 prefix-cache-scorer 评分,最后 max-score-picker 选择评分最高的实例。它不跨实例传输 KV Cache,实际复用由 vLLM 决定。
Approximate 和 Precise 两种缓存感知方式有什么区别?
Approximate 根据历史路由记录估算缓存位置,部署简单但不确认缓存是否仍存在;Precise 订阅引擎的 KV Events 维护真实缓存索引,更准确但需处理事件延迟、丢失和索引重建。
前缀感知路由相比随机路由,实验效果提升多少?
实验显示,前缀感知路由使后续请求 100% 回到原副本(随机路由为 56.7%),前缀 token 命中率从 56.56% 升至 99.60%,实际 Prefill token 均值从 2261.5 降至 21.0,TTFT P95 从 2018.0 ms 降至 159.2 ms。
缓存命中率高是否一定意味着请求延迟更低?
不一定。如果命中缓存的实例队列很长,而冷实例可立即计算,复用缓存省下的 Prefill 时间可能抵不过排队时间。此时需要前缀评分与负载感知配合使用。
Burst Prefix 插件解决什么场景的问题?
Burst Prefix 针对冷缓存场景:大量共享相同前缀的请求同时到达且所有实例都无缓存时,它在短时间窗口内收集请求,尽量将相同前缀的请求分配到同一实例,减少重复前缀计算。
