

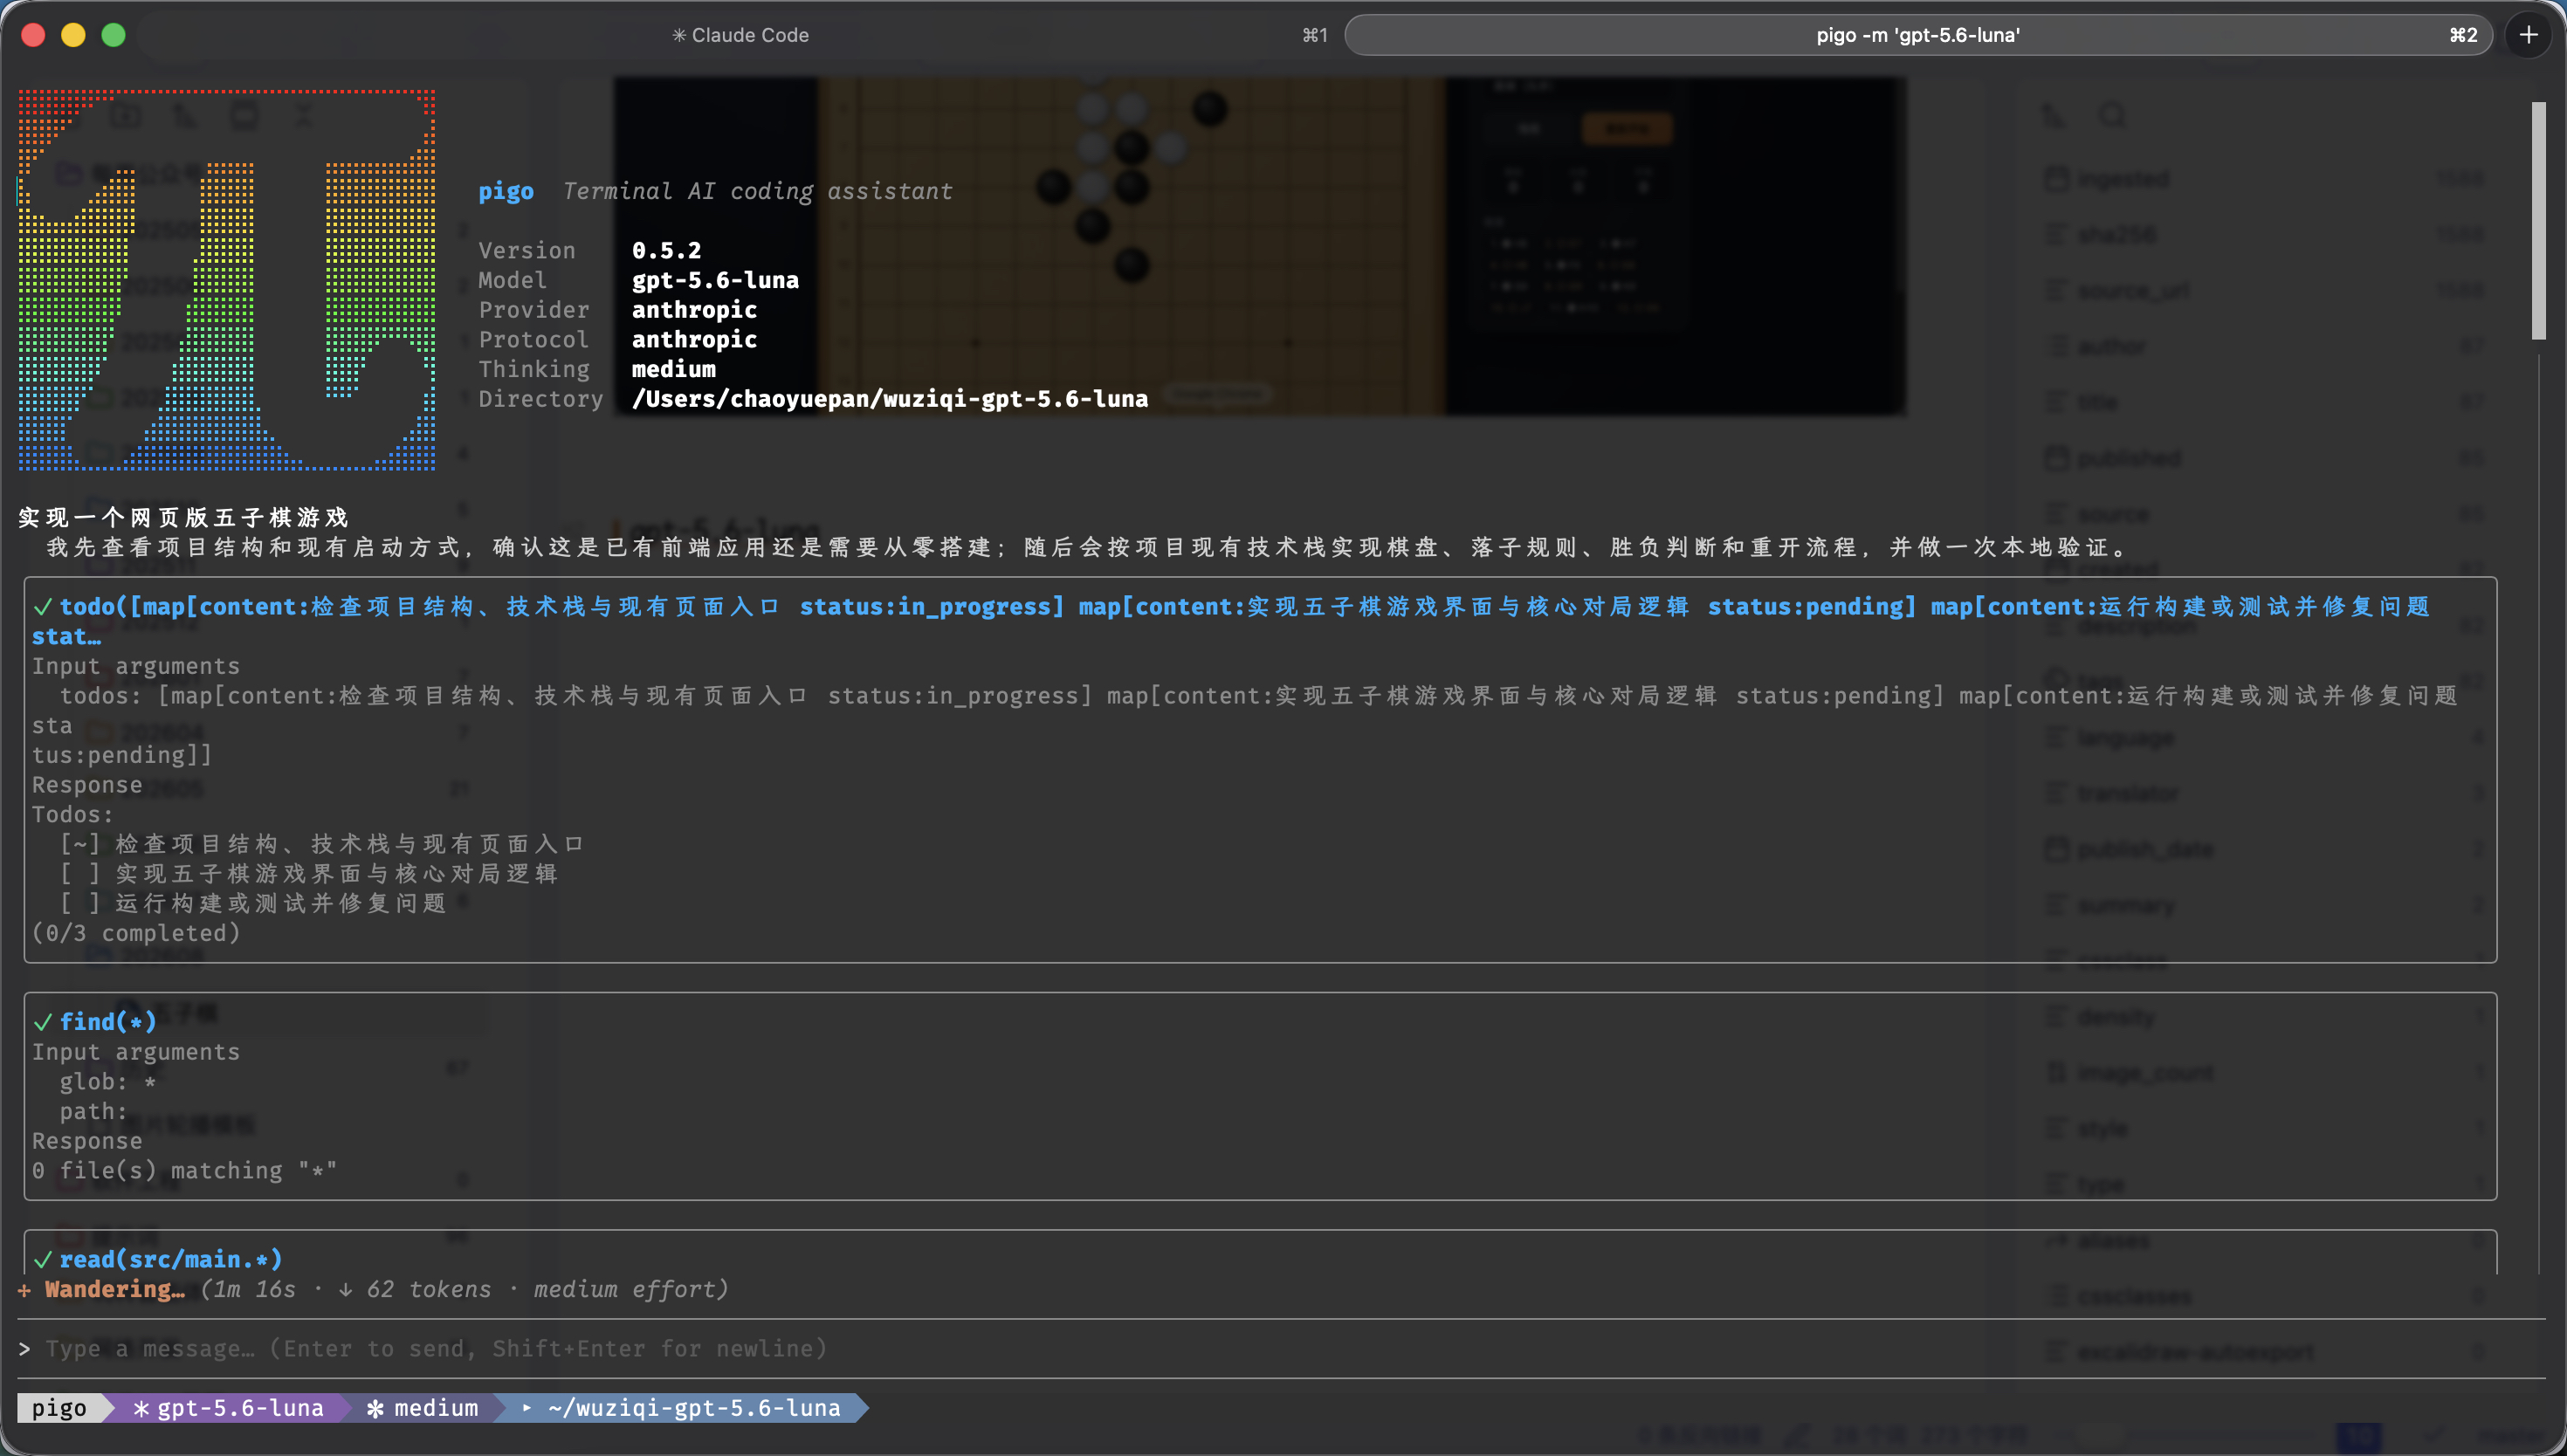

测试最新的几个大模型创建五子棋游戏
内容提要
作者用同一提示词“实现网页版五子棋”测试8个最新大模型。deepseek-v4-flash和kimi-k3综合最佳,功能全、AI实测可用且自带测试;Opus 5工程最扎实但需本地服务器;gpt-5.6-luna设计感最强;MiniMax-M3界面精致,但人机对战实测失效。结论:模型自述功能不可全信,需亲自验证。
延伸解读
模型自述功能不可全信,实测才是关键
文章通过同一提示词测试8个模型,发现MiniMax-M3虽然代码中写了完整的AI评分逻辑,界面也最精致,但人机对战实测失效,AI从不落子。这提醒我们,模型声称的功能列表可能只是代码层面的实现,未必能真正运行。deepseek-v4-flash则因自测发现并修复了类似bug而表现最佳。因此,对于AI生成的代码,亲自运行验证核心功能必不可少。
不同模型对模糊需求的补全策略差异明显
面对“实现网页版五子棋”这一模糊需求,各模型默认补全的功能范围大相径庭。有的只做双人对战(如deepseek-v4-pro、gpt-5.6-luna),有的则主动加入人机对战、难度选择、规则说明等未明说的功能(如deepseek-v4-flash、Opus 5)。这种差异反映了模型在需求理解与产品思维上的不同取向,也影响了最终交付物的完整度。
工程严谨度与运行便利性往往难以兼得
Opus 5在工程规范上最突出:模块化拆分、单元测试、无障碍适配,但代价是必须启动本地服务器才能运行。而deepseek-v4-flash同样具备模块化和自测,却保持了双击即玩的便利性。kimi-k3则以单文件实现全功能,牺牲了代码结构。可见,模型在工程严谨度与开箱即用之间需要权衡,用户应根据场景选择。
自带测试与主动修复是可靠交付的重要标志
deepseek-v4-flash和glm-5.2在生成后主动进行了验证:前者运行Node单元测试和无头浏览器烟测,还修复了会导致AI失灵的变量作用域bug;后者检查语法、胜负判定并截图确认渲染。这种自测习惯显著提升了交付物的可信度。相比之下,仅堆砌功能而不验证的模型,如MiniMax-M3,反而可能产出不可用的结果。
Q&A
用同一句提示词测试8个大模型做五子棋,综合表现最好的是哪几个?
deepseek-v4-flash 和 kimi-k3 综合表现最好。两者功能全、AI 对弈实测可用,并且都自带了测试。
哪些大模型生成的五子棋自带 AI 人机对战且实测可用?
deepseek-v4-flash(三模式三难度,Alpha-Beta 实测可用)、kimi-k3(单文件带三档难度,模式匹配 AI 实测可用)、Opus 5(alpha-beta AI 真正跑通)、gpt-5.6-sol(挑战电脑模式)的人机对战实测可用。注意 MiniMax-M3 名义有 AI 但实测失效。
MiniMax-M3 的五子棋有什么问题?
MiniMax-M3 界面最精致,代码里也写了启发式 AI,但人机对战实测是坏的:黑棋落子后白棋一直卡在“思考中…”,AI 从不落子、棋局锁死,控制台也没有报错。只有双人对战模式真正可用。
哪些模型生成的五子棋需要本地服务器才能运行?
Opus 5 需要本地服务器。它用了 ES Module,file:// 直开会被浏览器拦截,必须用 npm start 起服务访问 localhost:8000。其他模型如 deepseek-v4-flash、kimi-k3、deepseek-v4-pro、glm-5.2 等均可双击打开。
哪个模型生成的五子棋设计感最强?
gpt-5.6-luna 设计感最强,做出来像杂志内页:浅米色底、超大衬线中文标语“落子无悔,胜负在心”,配英文标签,排版克制高级。功能上只有本地双人对战,没有 AI。
deepseek-v4-flash 在测试中有什么突出亮点?
deepseek-v4-flash 综合表现最好:功能最全(三种对局模式、三档 AI 难度,困难档用深度 4 的 Alpha-Beta 搜索),分层交付多文件并附详细 README,自带 Node 单元测试和无头浏览器烟测,过程中主动发现并修掉两个真 bug(包括会导致 AI 失灵的变量作用域冲突),人机对战在 Chrome 实测可用。
这次测试得出的主要结论是什么?
主要结论:模型自述的功能清单不能全信,必须亲自跑一遍验证。面对相同模糊需求,不同模型在“补全需求”上默认取向差别很大;有的默认只做双人对战,有的主动补上人机对战、难度、规则说明甚至测试验收。MiniMax-M3 是反面教材,功能最多、界面最漂亮,却没验证核心人机对战能否跑通。
