

基于Spark的中风数据处理与分析
内容提要
本文介绍了基于Spark的中风数据处理和分析,包括数据清洗预处理、Spark SQL和Spark MLlib的数据分析和机器学习建模,以及使用逻辑回归、决策树和随机森林等算法进行中风预测,解决数据不平衡问题的SMOTE算法,使用ECharts进行可视化,通过Flask构建简单的Web界面实现中风预测功能。
延伸解读
数据不平衡的处理策略
文章指出,中风预测数据集中正负样本极不平衡,直接训练模型会导致模型偏向多数类,无法有效预测中风。为此,实验采用SMOTE过采样技术,人工合成少数类样本,使两类样本数量相对平衡。这一步骤对提升模型对中风病例的识别能力至关重要,也提醒读者在实际医疗数据挖掘中需重视类别不平衡问题。
模型选择与性能对比
实验对比了逻辑回归、决策树和随机森林三种算法。在未处理数据不平衡时,模型预测能力较差;使用SMOTE后,随机森林表现更优。这表明集成方法在处理复杂医疗数据时可能更具优势,但具体性能需结合评估指标。读者可关注不同算法在过采样后的表现差异,以选择适合自己场景的模型。
关键风险因素分析
通过相关性分析,年龄、高血压、心脏病、BMI和平均血糖水平与中风有较强相关性。可视化结果进一步显示,中风人群中患有心脏病、高血压的比例更高,且私营企业员工和自营工作者的BMI偏高。这些发现提示,控制血压、血糖和体重可能有助于降低中风风险,但需注意相关性不等于因果关系。
技术栈整合与可视化
实验整合了Hadoop、Spark、Flask和ECharts,实现了从数据存储、分析到Web可视化的全流程。HDFS用于伪分布式存储,Spark SQL进行统计分析,Spark MLlib构建预测模型,最终通过Flask提供交互界面。这种技术组合适合处理大规模数据,但部署和维护成本较高,读者可根据实际需求权衡。
Q&A
中风数据处理的实验目的是什么?
实验目的是通过数据分析和预测模型进行中风的早期预警和预防,提升中风预测的准确性。
在中风数据分析中使用了哪些机器学习算法?
使用了逻辑回归、决策树和随机森林三种机器学习算法进行中风预测。
如何解决中风数据中的不平衡问题?
采用SMOTE算法进行过采样,以平衡中风和非中风样本的数量。
数据预处理的主要步骤有哪些?
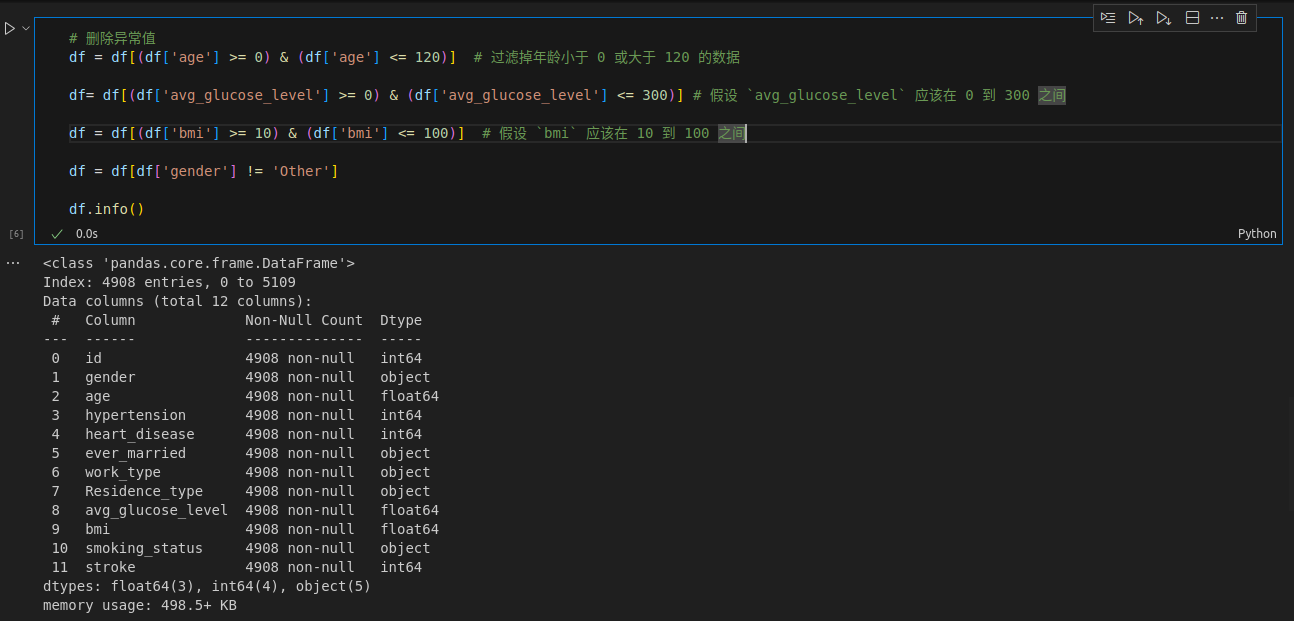
主要步骤包括数据集预览、清洗、删除缺失值、重复值和异常值,最后保存为新的csv文件。
如何使用Flask实现中风预测功能?
通过Flask构建Web界面,用户输入参数后,后端利用训练好的模型进行中风预测并返回结果。
中风与哪些因素有较强的相关性?
中风与年龄、高血压、心脏病、BMI和平均血糖水平有较强相关性。
